DeepSeek V4.1 Flash-Update steigert die Werte, doch die Belege bleiben intern

Quellenprüfung vom 19. Oktober 2026: DeepSeek-V4.1-Flash-1017 ist das Update vom 17. Oktober für das im September veröffentlichte Modell V4.1 Flash. Die folgenden Grafiken wurden eigenständig anhand der Modellkarte erstellt; die Messwerte stammen jedoch von DeepSeek und sind keine unabhängige Reproduktion. Die API-Preise blieben bei diesem Update unverändert. Die Vergleichstabelle nennt weder Stichprobengrößen und Unsicherheitsintervalle noch angeglichene Rechenbudgets zwischen den Anbietern. — Quelle
DeepSeek veröffentlichte am 17. Oktober ein Update für DeepSeek V4.1 Flash und beansprucht höhere Benchmark-Werte, schnellere Aufgabenerledigung und kürzere Ausgaben. Der Checkpoint mit dem Namen DeepSeek-V4.1-Flash-1017 ersetzt die September-Version in der Web-App, der mobilen App und der API von DeepSeek.
Die entscheidende Änderung ist weder eine neue Modellfamilie noch eine neue Architektur. DeepSeek beschreibt 1017 als geringfügiges Update des bestehenden V4.1 Flash-Modells. Entwickler verwenden weiterhin deepseek-flash, während der Dienst Anfragen ohne erforderliche API-Migration an den neuen Checkpoint weiterleitet.
Dieser stille Austausch schafft die zentrale Spannung. DeepSeek präsentiert ein stärkeres Verhältnis von Leistung zu Kosten, insbesondere für Coding-Agenten und toolgestützte Arbeit. Die veröffentlichten Ergebnisse stammen jedoch weiterhin vom Unternehmen selbst, und mehrere für enge Vergleiche nötige Evaluierungsdetails wurden nicht offengelegt.
Die Zahlen von DeepSeek verdienen dennoch Aufmerksamkeit. Die größten Fortschritte zeigen sich offenbar bei Terminal-Arbeit, Programmsynthese, Automatisierung und Aufgaben, die ganze Software-Repositories umfassen. Das sind die Workloads, bei denen Anthropic, OpenAI, Google, Moonshot AI und Zhipu AI um die Akzeptanz von Entwicklern konkurrieren.
Das Update setzt daher nicht nur Benchmark-Ranglisten unter Druck. Es fordert Anbieter heraus zu zeigen, dass Premium-Modelle reale Aufgaben zuverlässiger, mit weniger Tokens und weniger menschlichem Eingreifen erledigen. DeepSeek hat seine Seite dieses Arguments verbessert, doch externe Tests müssen nun bestimmen, wie stark das Update Produktionsergebnisse verändert.
Das DeepSeek V4.1 Flash-Update ist ein Checkpoint, keine neue Architektur
DeepSeek hat das Modell hinter einem bestehenden Produkt aktualisiert, statt eine weitere Architekturgeneration einzuführen.
Das Oktober-Changelog des Unternehmens besagt, dass DeepSeek V4.1 Flash auf DeepSeek-V4.1-Flash-1017 aktualisiert wurde. Die Web- und mobilen Anwendungen verwenden nun zusammen mit dem API-Endpunkt die neue Version.
Bestehende API-Nutzer benötigen keine neue Modellkennung. Anfragen mit deepseek-flash erreichen den neuesten Checkpoint. Auch ältere Kennungen für frühere Flash-Modelle werden laut DeepSeeks Dokumentation auf die aktuelle Version weitergeleitet.
Diese Bereitstellungsmethode kann 1017 kleiner erscheinen lassen, als es ist. Ein stabiler Endpunkt verringert den Migrationsaufwand, bedeutet aber auch, dass sich das Anwendungsverhalten ohne Änderung des Modellnamens ändern kann. Teams, die Ausgabekonsistenz bewerten, sollten den bereitgestellten Checkpoint festhalten, nicht nur die API-Kennung.
Die Veröffentlichung unterscheidet sich vom ursprünglichen Launch von V4.1 Flash am 10. September. Diese frühere Veröffentlichung führte die Architektur der Modellfamilie, natives visuelles Verständnis, Unterstützung für längere Kontexte und ein überarbeitetes Inferenzdesign ein. Der Oktober-Checkpoint aktualisiert das Modell innerhalb dieser etablierten Grundlage.
Die Architektur nutzt ein Mixture-of-Experts-Design oder MoE. Dieser Ansatz aktiviert für jedes Token nur einen Teil eines deutlich größeren Netzwerks, um den Rechenaufwand zu senken und gleichzeitig eine breite Modellkapazität zu erhalten.
DeepSeek gab für das September-Modell ein Backbone mit 552 Milliarden Parametern an. Demnach sind bei der Verarbeitung von Eingaben 8 Milliarden Parameter aktiv und während der Ausgabeerzeugung 16 Milliarden. Diese Spezifikationen beschreiben die V4.1-Architektur, nicht eine mit 1017 eingeführte neue Parameterkonfiguration.
Die ursprüngliche Veröffentlichung beschrieb außerdem ein kausales Encoder-Decoder-Design. Vereinfacht gesagt weist das Modell dem Verstehen von Prompts und dem Erzeugen von Antworten unterschiedliche aktive Kapazitäten zu. DeepSeek positioniert diese Asymmetrie als Möglichkeit, Durchsatz zu verbessern und Speicheranforderungen zu senken.
Der technische Bericht beschreibt Unterstützung für Kontexte von bis zu einer Million Tokens. Ein Kontextfenster bezeichnet die Menge an Material, die ein Modell innerhalb einer Anfrage berücksichtigen kann. Die aktuelle Dokumentation von DeepSeek nennt außerdem eine maximale Ausgabelänge von 384.000 Tokens.
Diese Grenzen kamen nicht mit 1017. Auch natives Vision-Verständnis war bereits Teil von V4.1 Flash. Diese Fähigkeiten als Oktober-Neuerungen zu behandeln, würde das Ausmaß der Änderung übertreiben.
Stattdessen scheint 1017 ein Post-Training- und Verhaltensupdate zu sein. DeepSeek sagt, es verbessere Schlussfolgern, Coding, Agentenarbeit und visuelle Aufgaben, während Laufzeit und Antwortlänge sinken. Das Unternehmen hat für diesen Checkpoint keine separate neue Parameterzahl veröffentlicht.
Auch die Verteilung als offenes Modell ist relevant. DeepSeek veröffentlichte den Checkpoint über sein Model Repository unter einer MIT-Lizenz. Das gibt Forschern und Infrastrukturteams Zugriff auf die Gewichte, vorbehaltlich der praktischen Anforderungen, ein so großes Modell bereitzustellen.
Offene Gewichte ermöglichen eine tiefergehende Prüfung. Sie machen unabhängige Evaluierung jedoch nicht unmittelbar oder kostengünstig. Die Reproduktion von Agenten-Benchmarks erfordert kompatible Infrastruktur, Harness-Konfigurationen, Tool-Zugang, Wiederholungsrichtlinien und erhebliche Rechenkapazität.
Das Ergebnis ist eine Veröffentlichung, die über eine API leicht zugänglich, aber umfassend schwerer zu validieren ist. Diese Lücke erklärt, warum die Benchmark-Tabelle von DeepSeek derzeit den Großteil der Geschichte trägt.
DeepSeek-Coding-Benchmarks zeigen, wo das Update Verbesserungen brachte
Die stärksten berichteten Zugewinne konzentrieren sich auf Coding- und Agentenaufgaben, bei denen kürzere Durchläufe genauso wichtig sein können wie höhere Genauigkeit.
Die größte Veränderung unter diesen vier Programmiertests zeigt Terminal-Bench 4.0 mit einem Anstieg von 31.2 auf 42.3. Das entspricht 11.1 Punkten beziehungsweise rund 35.6% relativ zum bisherigen Wert. DeepSWE v1.1 steigt von 74.2 auf 77.0. Das Wettbewerbsbild ist gemischt: In der Anbietertabelle liegt Flash-1017 bei DeepSWE über dem als Opus 5 bezeichneten Modell, bei Terminal-Bench, ProgramBench und NL2Repo-Bench dagegen darunter. Der Vergleich übernimmt die genaue Quellenbezeichnung Opus 5. Terminal-Bench verwendet Claude Code, DeepSWE verwendet Mini-SWE-V2. Die Tabelle belegt weder gleiche Budgets noch Erfolgsquoten im Produktivbetrieb.

Redaktionelle Grafik anhand der Modellkartendaten von DeepSeek vom 17. Oktober 2026. Höhere gemeldete Werte sind besser. Terminal-Bench: Claude Code; DeepSWE: Mini-SWE-V2. Testdatum, Stichprobengrößen, Reasoning-Aufwand, Wiederholungsversuche sowie angeglichene Token- und Zeitbudgets werden in der Tabelle nicht offengelegt. — Quelle
DeepSeek berichtet für den 1017-Checkpoint einen Terminal-Bench-4.0-Wert von 42,3. Das September-Modell V4.1 Flash erreichte im Vergleich des Unternehmens 31,2. Das entspricht einem Anstieg um 11,1 Punkte innerhalb von DeepSeeks veröffentlichter Konfiguration.
Terminal-Bench bewertet Agenten, die in Kommandozeilenumgebungen arbeiten. Diese Aufgaben verlangen mehr als das Schreiben einer isolierten Funktion. Das Modell muss Ziele interpretieren, Tools verwenden, Dateien navigieren, Befehle ausführen und sich von Fehlern erholen.
Das Unternehmen erklärt, Terminal-Bench 4.0 über das Claude Code-Framework getestet zu haben. Dieses Detail ist relevant, weil ein Agenten-Framework die Tools, Anweisungen und Interaktionsschleifen prägt, die dem zugrunde liegenden Modell zur Verfügung stehen.
Bei DeepSWE v1.1 berichtet DeepSeek von einem Anstieg von 74,2 auf 77,0. Für diese Bewertung verwendete es das Mini-SWE-V2-Framework. Software-Engineering-Benchmarks können stark von Repository-Setup, Tool-Berechtigungen und erlaubten Versuchen abhängen.
ProgramBench zeigt einen größeren numerischen Sprung von 20,3 auf 29,1. NL2Repo-Bench steigt von 65,4 auf 68,2. Letzterer konzentriert sich darauf, natürlichsprachliche Anfragen in Änderungen über Software-Repositories hinweg zu übersetzen.
Das Muster deutet darauf hin, dass DeepSeek auf fortlaufende Coding-Workflows zielte, nicht nur auf Programmierung mit kurzen Antworten. Diese Unterscheidung ist für Unternehmen wichtig, die Agenten anhand von Issue-Queues, Code-Review-Aufgaben, Migrationen und Debugging-Sitzungen testen.
Agenten-Benchmarks zeigen eine ähnliche Richtung. DeepSeek berichtet 60,5 bei Automation-Bench v1.0.6, verglichen mit 54,8 für den vorhergehenden Checkpoint. Agents’ Last Exam steigt von 31,8 auf 35,4.
Apex Bench v1.1 steigt in der Tabelle des Unternehmens von 64,6 auf 72,1. DeepSeek präsentiert diese Ergebnisse als Beleg dafür, dass das Update längere Sequenzen mit Planung, Tool-Nutzung und Ausführung bewältigen kann.
Auch die visuellen Agentenwerte stiegen. Chartography mit Tools erhöhte sich von 78,9 auf 83,0, während BabyVision von 89,6 auf 92,5 zulegte. ZeroBench-main mit Tools stieg von 49,0 auf 51,0.
DeepSeek sagt, ZeroBench-main habe Pass@5 verwendet. Diese Metrik erlaubt bis zu fünf Versuche und erfasst, ob mindestens einer erfolgreich ist. Sie sollte nicht als direkt gleichwertig mit einer Erfolgsrate beim ersten Versuch gelesen werden.
Das Unternehmen berichtet außerdem 42,6 bei Humanity’s Last Exam ohne Tools. Für eine reine Text-Teilmenge nennt es 44,0, obwohl das Teilergebnis den Wert für die breitere Evaluierung nicht ersetzen sollte.
Die Benchmark-Gewinne sind in jedem in der Tabelle veröffentlichten Vergleich mit früheren Modellen konsistent. Kein aufgeführtes Ergebnis zeigt, dass der 1017-Checkpoint hinter der September-Version zurückliegt. Diese Konsistenz stützt DeepSeeks Behauptung, dass das Update innerhalb seiner ausgewählten Evaluierungen breit besser ist.
Die Tabelle legt jedoch für mehrere Vergleiche keine Stichprobengrößen offen. Außerdem fehlen Angaben zu Hardware, Token-Budgets, Zeitlimits, Wiederholungsbudgets und Einstellungen für den Schlussfolgerungsaufwand. Diese Variablen können Agenten-Evaluierungen erheblich beeinflussen.
Ein Modell, dem mehr Tool-Aufrufe oder mehr Reasoning-Tokens erlaubt sind, kann Aufgaben abschließen, die eine strengere Konfiguration verfehlt. Es kann dabei aber auch mehr Zeit und Ressourcen verbrauchen und dennoch einen besseren Wert erzielen.
DeepSeek sagt, der neue Checkpoint reduziere sowohl Laufzeit als auch Ausgabelänge. Diese Behauptung ist zentral, weil kürzere Ausgaben die Menge an erzeugtem Text senken können, die eine Anwendung verarbeiten muss. Schnellere Abschlüsse können außerdem Nutzererfahrung und Agentendurchsatz verbessern.
Die Veröffentlichungsmaterialien nennen jedoch keinen universellen Prozentsatz für eine der beiden Reduktionen. Die Laufzeit variiert je nach Workload, Infrastruktur, Kontextlänge und Agenten-Framework. Die Ausgabelänge verändert sich mit Prompts und Aufgabenkomplexität.
Die verantwortungsvolle Lesart ist daher eng gefasst. DeepSeek berichtet über bessere Werte, schnellere Abschlüsse und kürzere Antworten in seinen evaluierten Harnesses. Die genaue Verbesserung in der Produktion bleibt vom Workload abhängig.
Kürzere Ausgaben sind der eigentliche Wettbewerbsdruck
DeepSeek argumentiert, dass nützliche KI-Leistung pro erfolgreich abgeschlossener Aufgabe gemessen werden sollte, nicht allein anhand roher Intelligenzwerte.
DeepSeek meldet einen Anstieg von 54.8 auf 60.5 bei Automation-Bench v1.0.6, von 31.8 auf 35.4 bei Agents’ Last Exam und von 64.6 auf 72.1 bei Apex Bench v1.1. Flash-1017 übertrifft in allen drei Tests den Tabellenwert von Opus 5, wobei jeder Benchmark eine andere Aufgabenmenge bewertet. Die Werte sprechen für weitere Tests in Agentenabläufen, belegen aber keine zuverlässige Ausführung in einer uneingeschränkten Umgebung. Betreiber sollten an ihren eigenen Aufgaben erfolgreiche Abschlüsse, sämtliche Wiederholungsversuche, Werkzeugfehler, Prüfzeit und gesamte Tokenkosten messen. DeepSeek empfiehlt für diese Version Harness 0.2.1-rc.1 oder neuer.

Redaktionelle Grafik zu drei unterschiedlichen, von DeepSeek durchgeführten Agenten-Benchmarks der Version vom 17. Oktober 2026; höhere Werte sind besser. Die Tabelle nennt weder den genauen anbieterübergreifenden Aufwand und die Token- und Zeitbudgets noch Stichprobengrößen oder Testdatum. Die drei Ergebnisse dürfen nicht zu einer Gesamtpunktzahl zusammengefasst werden. — Quelle
Modellkäufer achten zunehmend darauf, wie viele erfolgreiche Workflows ein System innerhalb eines Budgets und Zeitlimits abschließt. Ein hoher Benchmark-Wert verliert an Bedeutung, wenn das Modell in Schleifen gerät, unnötige Erklärungen schreibt oder wiederholt Tools aufruft.
Agentenaufgaben verstärken dieses Problem. Ein Coding-Assistent kann Tausende Tokens erzeugen, während er den falschen Weg erkundet. Er kann auch Zeit verschwenden, indem er Dateien erneut liest oder Korrekturen versucht, die das zugrunde liegende Problem nicht beheben.
DeepSeeks Behauptung kürzerer Ausgaben zielt direkt auf diese Ineffizienz. Wenn 1017 mit weniger erzeugten Tokens zum gleichen oder einem besseren Ergebnis kommt, kann es Latenz und Betriebskosten zugleich reduzieren. Das ist folgenreicher als bloß prägnante Prosa.
Das Unternehmen bezeichnet die Veränderung als Pareto-Verbesserung beim Verhältnis von Leistung zu Kosten. Eine Pareto-Verbesserung bedeutet, dass eine Option in mindestens einer bedeutenden Dimension besser wird, ohne in den anderen gemessenen Dimensionen schlechter zu werden.
Hier beansprucht DeepSeek stärkere Benchmark-Leistung bei niedrigerer Laufzeit und kürzerer Ausgabe. Das Argument lautet, dass Entwickler nicht mehr so stark zwischen Fähigkeit und Geschwindigkeit oder Effizienz abwägen müssen.
Die verfügbaren Belege stützen die Leistungsseite innerhalb von DeepSeeks Evaluierungstabelle. Sie belegen die Kosten-pro-Erfolg-Seite nicht vollständig, weil das Unternehmen keine detaillierten Ressourcenmessungen auf Aufgabenebene veröffentlicht hat.
Die aktuellen Modellspezifikationen zeigen, dass Flash-1017 die bestehende Dienstkonfiguration beibehält. Sowohl Thinking- als auch Non-Thinking-Modi bleiben verfügbar, ebenso Tool-Aufrufe, JSON-Ausgabe, Vision und kompatible API-Formate.
Der unveränderte Endpunkt verringert auch die Bereitstellungsreibung. Ein Team kann das neue Verhalten testen, ohne seine Integration neu zu schreiben. Dieser Vorteil kann die Einführung beschleunigen, insbesondere für Entwickler, die DeepSeek Flash bereits nutzen.
Er schafft jedoch auch ein Betriebsrisiko. Anwendungen, die auf einem stabilen Ton, einer bestimmten Ausgabestruktur oder einem bestimmten Ablehnungsverhalten basieren, können auf eine stille Checkpoint-Änderung negativ reagieren. Regressionstests werden unerlässlich, sobald sich das gehostete Modell hinter einem beständigen Namen ändert.
Für Coding-Plattformen entsteht der unmittelbare Druck bei Modellen, die mit Premium-Zuverlässigkeit vermarktet werden. Die Tabelle von DeepSeek vergleicht 1017 mit K3, GLM-5.3, GPT-5.6 Sol und einem Modell mit der Bezeichnung Opus 5.
Diese Bezeichnungen müssen genau so wiedergegeben werden, wie DeepSeek sie bereitstellt. Die Tabelle bewertet nicht jedes aktuelle Modell jedes Unternehmens. Die Opus-5-Bezeichnung sollte nicht stillschweigend in eine andere Anthropic-Version umgewandelt werden.
DeepSeeks Checkpoint übertrifft die Opus-5-Referenz der Tabelle bei DeepSWE v1.1, Automation-Bench, Agents’ Last Exam und Apex Bench. Bei Terminal-Bench, ProgramBench, NL2Repo-Bench und drei aufgeführten visuellen Tests liegt er hinter dieser Referenz.
Dieses gemischte Ergebnis ist aussagekräftiger als die schlichte Behauptung eines Sieges. DeepSeek wirkt bei mehreren Agenten-Evaluierungen besonders wettbewerbsfähig, doch die eigene Tabelle des Anbieters zeigt nicht, dass es in jeder Kategorie führt.
Der Druck auf Wettbewerber entsteht durch das Gesamtpaket. DeepSeek kombiniert zugängliche Weights, einen stabilen API-Zugang, ein großes Kontextfenster, multimodale Eingaben und bessere Agenten-Scores. Jede dieser Eigenschaften erweitert den Kreis der Teams, die bereit sind, es zu testen.
Die Veröffentlichung im September stellte Effizienz bereits als architektonisches Ziel dar. DeepSeek erklärte, V4.1 Flash benötige für seinen Key-Value-Cache ein Viertel des High-Bandwidth Memorys und ein Achtel des Solid-State-Speichers.
Ein Key-Value-Cache speichert während der Inferenz erzeugte Informationen, damit das Modell nicht für jedes neue Token alles erneut berechnen muss. Kleinere Caches können den Speicherbedarf langer Prompts und wiederholter Agenten-Interaktionen senken.
Diese Architekturangaben beziehen sich auf V4.1 Flash als Modellfamilie. Die Geschichte im Oktober lautet, dass DeepSeek durch Post-Training das bestehende Design effektiver gemacht habe. Mit 1017 wurde kein weiteres Cache-Redesign angekündigt.
Diese Unterscheidung ist für Käufer wichtig. Die Architektur erklärt, warum ein Modell wirtschaftlich betrieben werden könnte. Das Verhalten eines Checkpoints bestimmt, ob er die tatsächlichen Aufgaben des Käufers präzise und effizient erledigt.
Teams, die das Update bewerten, sollten daher abgeschlossene Arbeit messen, nicht nur erzeugte Tokens. Sie sollten erfolgreiche Änderungen, akzeptierte Ergebnisse, menschliche Korrekturen, vergangene Zeit und Wiederholungsversuche über repräsentative Workflows hinweg erfassen.
Diese Bewertung kann in umfassendere AI workflows eingebettet werden. Entscheidend ist, Prompts, Quellmaterial, Ergebnisse und Prüfentscheidungen für spätere Vergleiche zu bewahren.
Was die Benchmark-Tabelle nicht belegt
Die Zahlen von DeepSeek sind aussagekräftige Hinweise auf die Entwicklungsrichtung des Unternehmens, aber keine unabhängige Bestätigung der Zuverlässigkeit im Produktiveinsatz.
Die Ergebnisse für visuelle Aufgaben mit Werkzeugnutzung verbessern sich, zeigen aber keinen durchgängigen Vorsprung. Chartography steigt von 78.9 auf 83.0, BabyVision von 89.6 auf 92.5 und ZeroBench-main von 49.0 auf 51.0. Die Quellenwerte für Opus 5 bleiben mit 84.0, 94.1 und 52.0 höher. Da diese Bewertungen Werkzeuge zulassen, sind die Zahlen keine reine Bildgenauigkeit ohne Hilfsmittel. ZeroBench-main verwendet Pass@5 und erlaubt somit mehrere Versuche; das Ergebnis steht nicht für Zuverlässigkeit beim ersten Versuch. Visuelle Agenten benötigen bei folgenreichen Aktionen weiterhin angemessene Werkzeugberechtigungen, Fehlerbehandlung und menschliche Prüfung.

Von DeepSeek durchgeführte visuelle Bewertungen mit Werkzeugnutzung für die Version vom 17. Oktober 2026; höhere Werte sind besser. ZeroBench-main ist Pass@5. Andere Versuchslimits, Stichprobengrößen, Unsicherheitsintervalle, angeglichene Budgets und Testdatum werden in der Tabelle nicht offengelegt. — Quelle
Die wichtigste Einschränkung ist die Unabhängigkeit der Quellen. DeepSeek veröffentlichte den Vergleich und wählte Modelle, Benchmarks, Harnesses und Konfigurationen aus. Die für diesen Artikel geprüften Primärquellen enthalten kein unabhängig reproduziertes Ergebnis für den exakten Checkpoint 1017.
Das macht die Scores nicht falsch. Anbieter-Evaluierungen sind nach einer Modellveröffentlichung oft die ersten verfügbaren Belege. Sie können zeigen, wo ein Unternehmen investiert hat und welche Workloads es verbessern will.
Sie können jedoch nicht jeden Vergleich abschließend entscheiden. Agenten-Benchmarks enthalten mehr bewegliche Teile als klassische Frage-und-Antwort-Tests. System-Prompt, Tools, Timeout, Sandbox und Retry-Logik eines Frameworks können den Endscore verändern.
DeepSeek legt einige Bedingungen offen. Terminal-Bench verwendete Claude Code, DeepSWE Mini-SWE-V2 und ZeroBench-main Pass@5. Das Unternehmen empfiehlt außerdem DeepSeek Harness in Version 0.2.1-rc.1 oder neuer.
Diese Empfehlung deutet darauf hin, dass die Harness-Integration Teil der Performance-Geschichte ist. DeepSeek erklärt, das Modell für den eigenen Harness, Tencent CodeBuddy, WorkBuddy und weitere Plattformen optimiert zu haben.
Verbesserungen an Modell und Harness sind beide legitim. Käufer müssen jedoch wissen, ob sich die Zugewinne über verschiedene Umgebungen hinweg übertragen lassen. Ein auf einen Agenten-Loop abgestimmter Checkpoint könnte sich innerhalb der Orchestrierungsschicht eines anderen Unternehmens anders verhalten.
Das Fehlen offengelegter Reasoning-Einstellungen schafft zusätzliche Unsicherheit. DeepSeek unterstützt mehrere Thinking-Effort-Stufen, die beeinflussen, wie viel interne Rechenleistung eine Anfrage erhält. Eine höhere Stufe kann Ergebnisse verbessern, zugleich aber Latenz oder Tokenverbrauch erhöhen.
Auch Hardwaredetails sind für Geschwindigkeitsangaben relevant. Die Laufzeit in einem gehosteten Dienst lässt sich nicht direkt auf selbst gehostete Inferenz übertragen. Netzwerk-Overhead, Batching, Quantisierung und die Wahl des Beschleunigers können die beobachtete Latenz dominieren.
Die offenen Weights machen diese Fragen überprüfbar, doch Self-Hosting ist nicht automatisch einfach. Ein Backbone mit 552 Milliarden Parametern stellt hohe Anforderungen an Speicher und Arbeitsspeicher, selbst wenn pro Token nur ein Teil des Netzwerks aktiviert wird.
Quantisierung reduziert den Speicherbedarf, indem Weights mit geringerer numerischer Präzision gespeichert werden. Sie kann die Bereitstellung praktikabler machen, doch die Ergebnisse können von der offiziellen Checkpoint-Konfiguration abweichen. Teams sollten die Genauigkeit nach jeder Konvertierung validieren.
Sicherheit ist ein weiteres Thema für den Produktiveinsatz. Coding Agents lesen häufig Repositories, führen Befehle aus, installieren Pakete und ändern Dateien. Ein besserer Benchmark-Score belegt nicht, dass ein Modell sicher weitreichende Berechtigungen erhalten kann.
Organisationen sollten Agentenarbeit isolieren, Zugangsdaten beschränken, Tool-Aufrufe protokollieren und sensible Änderungen prüfen lassen. Diese Kontrollen gelten für jedes Coding-Modell, unabhängig von seiner Benchmark-Position.
Dieselbe Vorsicht gilt für das Kontextfenster von einer Million Tokens. Die Unterstützung eines großen Kontexts garantiert keine zuverlässige Informationswiedergewinnung aus jeder Position. Lange Prompts können Ablenkung, widersprüchliche Anweisungen und unnötigen Rechenaufwand verursachen.
DeepSeeks native Vision-Unterstützung bestand ebenfalls schon vor dem Oktober-Update. Die höheren visuellen Agenten-Scores deuten auf eine bessere Nutzung dieser Fähigkeit hin, beweisen jedoch keine gleichwertige Zuverlässigkeit bei Diagrammen, Schnittstellen, Dokumenten und natürlichen Bildern.
Der historische Kontext unterstreicht die Notwendigkeit maßvoller Aussagen. Der V4-Launch von DeepSeek erhielt Aufmerksamkeit, weil er großen Kontextsupport mit einer auf Effizienz ausgerichteten Architektur kombinierte. Unabhängige Analysten, die in früherer Berichterstattung zitiert wurden, sahen die Familie als konkurrenzfähig zu führenden amerikanischen Modellen an.
Diese breitere Wettbewerbsfähigkeit validiert nicht automatisch die genauen Verbesserungen des neuen Checkpoints. Die 1017-Weights erfordern eigene Tests, insbesondere bei Workloads, die realen Deployments ähneln.
Eine praxisnahe Bewertung sollte beide Checkpoints mit identischen Prompts und Tools vergleichen. Sie sollte Temperatur, Effort-Einstellungen, Timeouts, Retry-Anzahlen und Repository-Zustände bewahren.
Prüfer sollten zudem die Ergebnisqualität bewerten, nachdem Vorteile durch höhere Ausführlichkeit herausgerechnet wurden. Eine kürzere Antwort ist nützlich, wenn sie vollständig bleibt. Sie wird zu einem Rückschritt, wenn sie Tests, Einschränkungen, Migrationsschritte oder Fehlererklärungen auslässt.
Bei Wissensarbeit kann Prägnanz ähnliche Zielkonflikte erzeugen. Kurze Zusammenfassungen verkürzen die Lesezeit, doch verdichtete Antworten können Unsicherheit verschleiern oder Minderheitenbelege verwerfen. Für folgenreiche Entscheidungen bleibt menschliche Prüfung nötig.
Die richtige Skepsis ist daher konkret. DeepSeek hat glaubwürdige First-Party-Belege für Verbesserungen veröffentlicht. Es hat jedoch noch keine universellen Geschwindigkeitsgewinne, geringere Gesamtkosten pro Aufgabe oder überlegene Zuverlässigkeit in unabhängigen Produktivumgebungen nachgewiesen.
Drei Signale werden zeigen, ob Flash-1017 den Markt verändert
Unabhängige Reproduktion, Performance über verschiedene Harnesses hinweg und anhaltende Entwickleradoption werden entscheiden, ob 1017 mehr als eine starke Benchmark-Veröffentlichung eines Anbieters wird.
Das Update vom 17. Oktober ersetzt den über den API-Alias deepseek-flash bereitgestellten Checkpoint bei unveränderten Preisen. Nach Prüfung am 19. Oktober kostet eine Million Flash-Tokens außerhalb der Spitzenzeiten 0.003 US-Dollar für zwischengespeicherte Eingaben, 0.15 für nicht zwischengespeicherte Eingaben und 0.60 für Ausgaben. Zu Spitzenzeiten betragen die Preise 0.006, 0.30 und 1.20 US-Dollar. Für eine ausdrücklich hypothetische Aufgabe mit einer Million nicht zwischengespeicherten Eingabe-Tokens, vier Millionen zwischengespeicherten Eingabe-Tokens und 100000 Ausgabe-Tokens ergibt sich eine Modell-Tokengebühr von 0.222 US-Dollar außerhalb der Spitzenzeiten oder 0.444 zu Spitzenzeiten. Diese Rechnung schließt Such- und Abrufgebühren, Infrastruktur, Wiederholungsversuche und menschliche Prüfung aus. Kürzere Ausgaben können die Ausgabekosten senken; DeepSeeks Geschwindigkeits- und Kostenaussage bedeutet aber keine feste Ersparnis für jede Arbeitslast.
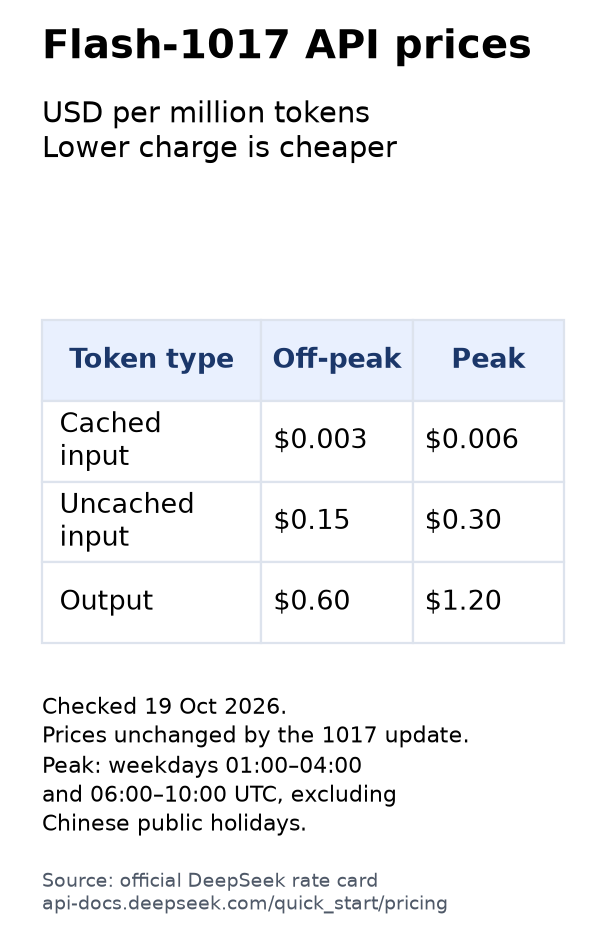
Offizielle Flash-1017-Preisliste, geprüft am 19. Oktober 2026, in US-Dollar je Million Tokens; niedrigere Gebühren sind günstiger. Spitzenzeiten sind werktags 01:00–04:00 und 06:00–10:00 UTC, ausgenommen chinesische gesetzliche Feiertage. Modell-Tokenpreise sind von Such-, Abruf- und anderen Betriebskosten getrennt. — Quelle
Das erste Signal ist eine unabhängige Bewertung des exakten 1017-Checkpoints. Forschende müssen die veröffentlichten Weights testen, nicht das September-Modell oder einen gehosteten Alias mit unklarer Version.
Diese Tests sollten Prompts, Harness-Versionen, Effort-Einstellungen, Hardware, Zeitlimits und Retry-Richtlinien veröffentlichen. Die Ergebnisse sollten Genauigkeit, vergangene Zeit, Output-Tokens und das Verhalten bei fehlgeschlagenen Aufgaben umfassen.
Eine Bestätigung der von DeepSeek berichteten Richtung würde die Argumentation des Unternehmens stärken. Große Rückschritte oder stark konfigurationsabhängige Zugewinne würden sie schwächen. Gemischte Ergebnisse würden darauf hindeuten, dass 1017 einigen Agenten-Loops stärker zugutekommt als anderen.
Das zweite Signal ist die Performance über mehrere Harnesses hinweg. DeepSeek optimierte gezielt für ausgewählte Plattformen, wodurch Portabilität zu einer zentralen Frage wird. Das Modell sollte seine Zugewinne auch in alternativen Coding Agents und Enterprise-Orchestrierungssystemen behalten.
Harnesstests über verschiedene Systeme hinweg können Modellverbesserungen von Integrationsverbesserungen trennen. Beides hat Wert, beantwortet jedoch unterschiedliche Kaufentscheidungen.
Ein Unternehmen, das DeepSeek Harness übernimmt, kann vom kombinierten System profitieren. Ein Unternehmen, das einen etablierten internen Agenten beibehält, benötigt Belege dafür, dass der Checkpoint allein seinen Workflow verbessert.
Beobachten Sie, ob Drittanbietertests den Anstieg bei Terminal-Bench reproduzieren, ohne den Tool-Zugriff zu verändern. Beobachten Sie außerdem, ob kürzere Outputs vollständig bleiben, wenn ein anderes Framework einen anderen System-Prompt verwendet.
Konsistente Zugewinne würden DeepSeeks Behauptung eines besseren zugrunde liegenden Checkpoints stützen. Auf bevorzugte Harnesses begrenzte Zugewinne würden die Wahl der Integration zu einem größeren Teil der Entscheidung machen.
Das dritte Signal ist anhaltende Entwickleradoption nach dem anfänglichen Veröffentlichungszyklus. Downloads, Integrationen, reproduzierbare Tests und Fallstudien aus dem Produktiveinsatz sind wichtiger als Aufmerksamkeit in der Launch-Woche.
Die MIT-lizenzierten Weights senken die rechtliche Hürde für Experimente. Der Umfang des Modells erhöht jedoch die Infrastrukturhürde für ernsthaftes Self-Hosting. Viele Teams werden weiterhin gehosteten Zugang oder spezialisierte Inferenzanbieter wählen.
Die Adoption sollte daher über beide Wege hinweg gemessen werden. Gehostete Nutzung zeigt, ob das API-Erlebnis attraktiv ist. Self-Hosted-Deployments zeigen, ob offener Zugang praktische Alternativen für Organisationen mit besonderen Anforderungen schafft.
Bindung ist wichtiger als Tests. Entwickler testen häufig neue Modelle, weil es leicht ist, einen API-Identifier auszutauschen. Sie behalten ein Modell nur, wenn es akzeptierte Arbeit verbessert, ohne neue Prüfaufwände zu erzeugen.
Das wahrscheinlichste kurzfristige Ergebnis sind umfassendere Tests, nicht eine unmittelbare Marktumwälzung. DeepSeek hat Coding-Agent-Teams einen konkreten Anlass gegeben, ihre Evaluierungen erneut durchzuführen. Seine stärksten berichteten Zugewinne passen zu Aufgaben, die Entwickler bereits nur schwer zuverlässig automatisieren können.
Wettbewerber haben weiterhin Spielraum, mit besseren Modellen, stärkeren Agenten-Frameworks, geringerer Latenz, sichererer Ausführung oder vorhersehbarerem Verhalten zu reagieren. DeepSeeks eigene Tabelle zeigt, dass der 1017-Checkpoint nicht jeden Vergleich anführt.
Die Veröffentlichung demonstriert zudem einen schnelleren Wettbewerbsrhythmus. Im September erschien eine große Architektur, fünf Wochen später folgte ein verhaltensorientierter Checkpoint. Stabiles API-Routing ermöglicht DeepSeek, diese Verbesserung sofort bereitzustellen.
Dieser Rhythmus nützt Nutzern, wenn Updates messbare Zugewinne bringen. Er erschwert Governance, wenn sich das Verhalten schneller ändert als unternehmensweite Evaluierungszyklen. Teams benötigen Versionsaufzeichnungen und wiederkehrende Regression-Suites, um beide Effekte zu steuern.
Für Entwickler ist die Entscheidung einfach. Testen Sie DeepSeek-V4.1-Flash-1017 anhand genau der Aufgaben, die Ihre Nutzer ausführen. Messen Sie akzeptierte Ergebnisse, Wiederholungsversuche, Latenz, Output-Länge und menschliche Korrekturen.
Enterprise-Käufer sollten Anbieter nach Checkpoint-Identifiers und Änderungsmitteilungen fragen. Sie sollten außerdem reproduzierbare Evaluierungsbedingungen verlangen, bevor sie eine Benchmark-Führung als Kaufentscheidung behandeln.
Wissensarbeiter sollten darauf achten, ob kürzere Antworten Belege und Nuancen bewahren. Eine schnellere Antwort schafft wenig Wert, wenn jemand danach fehlende Begründungen rekonstruieren muss.
Das DeepSeek-V4.1-Flash-Update hat die Vergleichsgruppe bereits verändert. Es erhöht die Coding- und Agenten-Scores des vorherigen Checkpoints und behält zugleich denselben Zugangsweg und dieselbe Modellfamilie bei.
Was als Nächstes geschieht, hängt von Belegen außerhalb von DeepSeeks Labor ab. Führen Sie kontrollierte Vergleiche durch, bewahren Sie die vollständige Evaluierungsdokumentation und beobachten Sie, ob unabhängige Tests die behauptete Kombination aus Genauigkeit, Geschwindigkeit und Prägnanz reproduzieren.


