Nano Banana 2.1: Was Googles Bild-Benchmarks verraten


Google veröffentlichte Nano Banana 2.1 am 6. Oktober 2026. Diese Analyse vom 14. Oktober behandelt es als Weiterentwicklung dieser Veröffentlichung – nicht als heutigen neuen Launch.
Die veröffentlichten Ergebnisse liefern überzeugende Hinweise darauf, dass Nano Banana 2.1 Nano Banana 2 bei mehreren Aufgaben der Bildgenerierung und -bearbeitung verbessert. Die größten berichteten Vorteile zeigen sich bei Infografik-Design, Konsistenz mehrerer Figuren, maskenbasierter Bearbeitung und der Arbeit mit mehreren Referenzen. Aktiviertes Thinking erzielt im Allgemeinen die höchsten Werte, wobei sein Nutzen je nach Aufgabe variiert.
Diese Erkenntnisse brauchen klare Grenzen. Die meisten Werte sind präferenzbasierte Elo-Ratings und keine Prozentangaben korrekter Bilder. Google nennt Fehlerbereiche für Elo-Ergebnisse, definiert jedoch nicht deren Konfidenzniveau. Das Unternehmen legt weder Stichprobengrößen, Benchmark-Prompts, Bildauflösungen, Wiederholungsbudgets, detaillierte Thinking-Einstellungen noch Bedingungen mit gleichem Rechenaufwand in der Tabelle der Modellkarte offen. Das Ergebnis zur Faktentreue stammt von einem automatisierten Bewerter und nicht aus einer menschlichen Genauigkeitsmessung.
Folglich sind die Benchmarks nützliche Hinweise auf die relative Leistung unter Googles Evaluierung, belegen aber weder Produktionszuverlässigkeit noch Latenz oder Kapitalrendite. Teams, die eine Migration erwägen, benötigen weiterhin arbeitslastspezifische Tests mit kontrollierten Eingaben, Fehlerkriterien und vollständigen Anfragekosten.
Was Google am 6. Oktober tatsächlich veröffentlicht hat
Nano Banana 2.1 ist Googles aktualisiertes Bildgenerierungs- und konversationelles Bildbearbeitungsmodell der Flash-Klasse. Der stabile Gemini-API-Modellcode lautet gemini-nano-banana-2.1. Google beschreibt es als Update für Gemini 3.1 Flash Image, auch Nano Banana 2 genannt, sowie als effizienteres Gegenstück zu Gemini 3 Pro Image, das gemeinhin Nano Banana Pro heißt. Das Gemini API changelog dokumentiert die allgemeine Verfügbarkeit am 6. Oktober 2026.
Laut der Nano Banana 2.1 model card basiert das Modell auf Gemini 3.6 Flash, akzeptiert Text und Bilder und gibt Bilder sowie Text zurück. Google positioniert es für kontrollierte Bilderstellung, Bearbeitung, textlastige Grafiken, lokalisierte Darstellung und iterative Workflows. Die Evaluierung kombiniert menschliche Präferenzurteile im direkten Vergleich für Generierung und Bearbeitung mit einer einseitigen automatisierten Bewertung der Faktentreue.
Die Karte benennt zudem konkrete Einschränkungen: Kleiner oder langer Text kann verschwimmen oder zerfallen; Identitäten können driften; maskierte Bearbeitungen können Markierungen beibehalten oder Anweisungen nur teilweise befolgen; Posen können unerwartet bestehen bleiben; räumliche Beziehungen wie links und rechts können verwechselt werden; und Weltwissen, 3D-Schlussfolgern sowie Faktentreue bleiben unvollkommen. Auch gelegentliche Langsamkeit und Timeouts werden eingeräumt. Das sind operative Risiken, keine Fußnoten: Jedes benötigt vor dem Einsatz einen Abnahmetest und eine Fallback-Richtlinie.
Googles API model documentation ergänzt Implementierungsdetails. Die Ausgabe erfolgt standardmäßig in 1K und kann bis zu 4K angefordert werden. Thinking bietet minimal, medium – den Standard – und high. Das Modell unterstützt Search Grounding, jedoch kein Function Calling, keine Code-Ausführung und keine strukturierten Ausgaben.
Die Modellkarte nennt einen Kontext von bis zu einer Million Token und eine Textausgabe von bis zu 64K, während die bereitgestellte Gemini-API-Seite 131,072 Eingabetoken und 32,768 Ausgabetoken aufführt. Die öffentlichen Dokumente erklären nicht die Beziehung zwischen diesen unterschiedlichen Grenzen. Bereitsteller sollten die dokumentierten Grenzen des jeweils aufgerufenen Endpunkts befolgen, anstatt anzunehmen, dass die höheren Angaben der Modellkarte über diese API verfügbar sind.
Generation Elo zeigt einen Vorsprung, keine Genauigkeitsquote
Google berichtet über zwei menschlich bewertete Text-zu-Bild-Vergleiche: Gesamtpräferenz und Infografik-Design. In beiden liegt Nano Banana 2.1 mit Thinking auf Platz eins, gefolgt von Nano Banana 2.1 ohne Thinking, Nano Banana 2 Thinking und Nano Banana Pro.
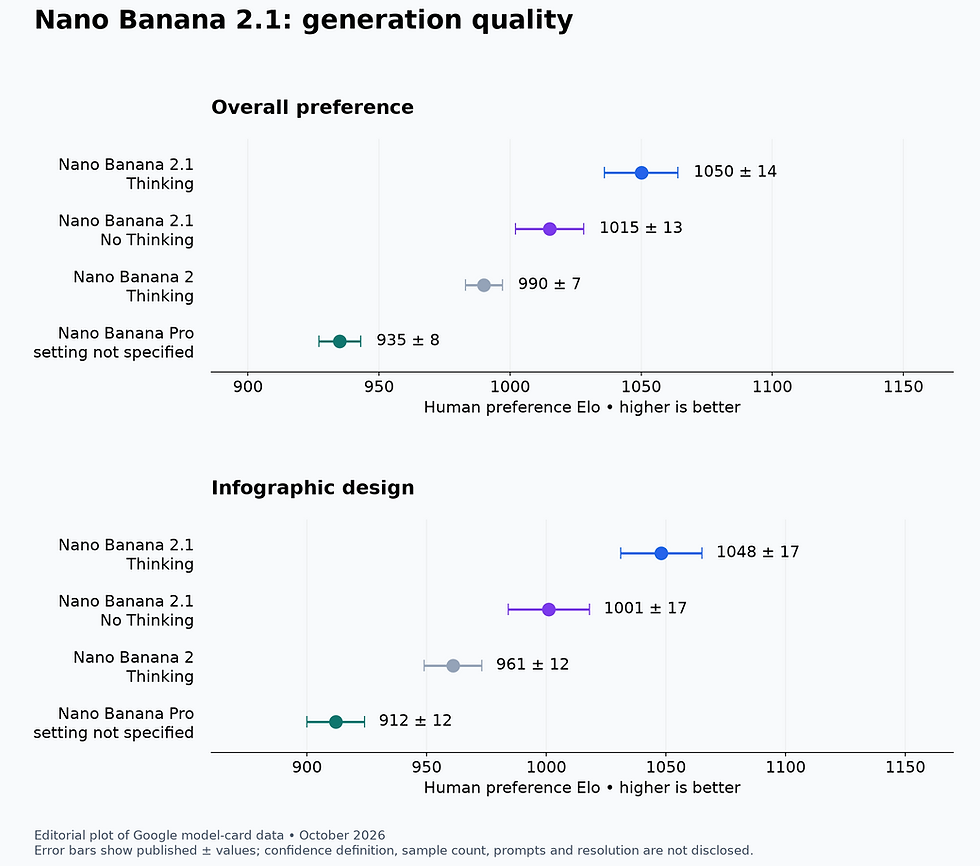
Redaktionelles Diagramm numerischer Daten aus Google DeepMinds Nano Banana 2.1 model card vom Oktober 2026. Ein höherer Elo-Wert steht für eine stärkere relative menschliche Präferenz in Googles Vergleichen; die Fehlerbalken zeigen die veröffentlichten ±-Bereiche, deren Konfidenzdefinition nicht angegeben ist. Dies ist kein originales Google-Bild, und Elo ist keine prozentuale Genauigkeit.
Bei der Gesamtpräferenz erreicht Nano Banana 2.1 Thinking 1050 ±14, verglichen mit 1015 ±13 ohne Thinking, 990 ±7 für Nano Banana 2 Thinking und 935 ±8 für Pro. Beim Infografik-Design lauten die entsprechenden Ergebnisse 1048 ±17, 1001 ±17, 961 ±12 und 912 ±12.
Die Rangfolge ist konsistent, und mehrere Abstände sind größer als die dargestellten Bereiche. Insbesondere liegen beide Nano-Banana-2.1-Modi beim Infografik-Design über Nano Banana 2, selbst unter Berücksichtigung der veröffentlichten Intervalle. Das ist aussagekräftige Evidenz für einen Präferenzvorteil innerhalb dieser Evaluierung. Es ist kein Beleg dafür, dass 2.1 jeden Prompt gewinnt, eine korrekte Infografik erzeugt oder in der Produktion weniger Wiederholungen benötigt.
Thinking scheint hier vorteilhaft zu sein. Sein Vorsprung von 35 Punkten bei der Gesamtpräferenz gegenüber No Thinking weist nicht überlappende dargestellte Intervalle auf: 1036–1064 gegenüber 1002–1028. Die Intervalle für das Infografik-Design berühren sich bei 1031; das Diagramm stützt somit einen Vorteil, aber keine präzise universelle Effektgröße. Google bezeichnet die Benchmark-Konfiguration zudem lediglich als „Thinking“. Das Unternehmen verrät nicht, ob der Lauf minimal, medium, high, eine adaptive Richtlinie oder eine andere interne Einstellung verwendete.
Diese Auslassung begrenzt Schlussfolgerungen zu Kosten und Latenz. Ein höherer Thinking-Wert lässt sich nicht in „immer high Thinking aktivieren“ übersetzen, ohne zu messen, wie sich jede verfügbare Einstellung auf einen konkreten Workflow auswirkt. Die Benchmark-Tabelle enthält keine Latenzmessungen, und diese Analyse sollte keine erfinden.
Das praktische Signal ist enger gefasst: Teams, deren Nutzer Komposition, visuelle Qualität oder Infografik-Layout bewerten, sollten Nano Banana 2.1 Thinking als ernsthaften Kandidaten einbeziehen. Teams, die risikoarme dekorative Assets erzeugen, könnten No Thinking als ausreichend empfinden; diese Entscheidung gehört jedoch in einen kontrollierten Test mit eigenen Prompts und Akzeptanzschwellen.
Die Konsistenz verbessert sich, doch das Ergebnis für einzelne Figuren liegt eng beieinander
Konsistenz ist bei wiederkehrenden Figuren, Kampagnenvarianten, Storyboards, Produkterklärungen und mehrstufiger Bearbeitung oft wertvoller als reine Attraktivität. Google trennt zwischen Konsistenz einzelner Figuren und mehrerer Figuren, und diese beiden Ergebnisse erzählen unterschiedliche Geschichten.

Redaktionelles Diagramm der Daten aus Google DeepMinds model card vom Oktober 2026 zur Konsistenz einzelner und mehrerer Figuren. Ein höherer Elo-Wert bedeutet eine stärkere relative menschliche Präferenz; veröffentlichte ±-Bereiche werden ohne angegebene Konfidenzdefinition gezeigt. Die nahezu überlappenden Werte von Nano Banana 2.1 Thinking und No Thinking bei der Konsistenz einzelner Figuren sind wichtig. Dies ist kein originales Google-Bild.
Bei der Konsistenz einzelner Figuren erreicht Nano Banana 2.1 Thinking 1028 ±14 und No Thinking 1021 ±14. Ihre dargestellten Intervalle überlappen sich erheblich, von 1014 bis 1035. Daher wäre es nicht gerechtfertigt, den Unterschied von sieben Punkten als erwiesenen praktischen Vorteil darzustellen. Beide 2.1-Konfigurationen liegen über Nano Banana 2 Thinking mit 981 ±10 und Pro mit 991 ±9, doch der Benchmark zeigt nicht, ob Fehler Gesichter, Kleidung, Körperproportionen, Accessoires oder Stilabweichungen betrafen.
Das Ergebnis für mehrere Figuren ist deutlicher differenziert. Thinking erreicht 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10 und Nano Banana 2 Thinking 978 ±10. Die Intervalle von 2.1 Thinking und No Thinking überlappen sich nicht. Das deutet darauf hin, dass zusätzliches Schlussfolgern hilfreicher sein könnte, wenn eine Szene verlangt, dass das System mehrere Identitäten und deren Beziehungen nachverfolgt.
Dennoch ist „unterstützt bis zu vier Figuren“ nicht dasselbe wie „bewahrt vier Identitäten zuverlässig“. Die API-Dokumentation besagt, dass die Fusion mehrerer Bilder bis zu 14 Referenzbilder akzeptiert, darunter bis zu vier Figuren und zehn Objekte. Das sind Eingabelimits, keine Garantien für Genauigkeit. Sie verraten nicht, wie sich die Leistung verändert, wenn Referenzen visuell ähnlich, widersprüchlich, beschnitten, niedrig aufgelöst oder ungleichmäßig beleuchtet sind.
Eine Produktionsevaluierung sollte jedes Subjekt getrennt bewerten. Sinnvolle Fehlerkategorien umfassen Gesichtsdrift, Übertragung von Kleidung, Übertragung von Attributen zwischen Figuren, fehlende Subjekte, unbeabsichtigte Duplikate, verändertes Alter und inkonsistente relative Körpergröße. Eine einzelne Gesamtpräferenzbewertung kann einen schweren Identitätsfehler verdecken, wenn der Rest des Bildes attraktiv aussieht.
Für einen Workflow mit einer Figur liefert das Diagramm kaum Hinweise darauf, dass Thinking bei jeder Anfrage erforderlich ist. Bei Szenen mit mehreren wiederkehrenden Personen macht sein größerer berichteter Vorsprung es vielversprechender – vorbehaltlich gemessener Kosten, Latenz und Raten von Identitätsfehlern.
Die Bearbeitungsergebnisse sprechen für 2.1, mit unterschiedlichen Risiken je Aufgabe
Bearbeitungs-Benchmarks sind besonders relevant, da eine plausibel aussehende Ausgabe dennoch unbrauchbar sein kann, wenn sie geschützte Bereiche verändert, Produktdetails verliert oder Referenzen falsch zusammenführt. Google berichtet Elo-Werte für allgemeine Bearbeitung, Konsistenz, masken- oder tintenbasierte Bearbeitung, Produktkonsistenz, Stilisierung und Bearbeitung mit mehreren Referenzen.

Redaktionelles Diagramm verifizierter numerischer Ergebnisse aus Google DeepMinds Nano Banana 2.1 model card vom Oktober 2026. Ein höherer Elo-Wert steht für eine stärkere relative menschliche Präferenz bei Masken-/Tintenbearbeitung, Produktkonsistenz und Bearbeitung mit mehreren Referenzen; veröffentlichte ±-Bereiche werden angezeigt, ohne angegebene Konfidenzdefinition. Dies ist kein originales Google-Bild und misst keine exakte Befolgung von Bearbeitungsanweisungen.
Die masken- oder tintenbasierte Bearbeitung ist das deutlichste Beispiel für einen gemeinsamen 2.1-Vorteil ohne nachgewiesenen Thinking-Vorteil. Thinking erreicht 1049 ±15 und No Thinking 1042 ±16; ihre Intervalle überlappen stark. Beide liegen über Nano Banana 2 Thinking mit 965 ±12 und Pro mit 927 ±12. Wenn Maskenbearbeitung eine Arbeitslast dominiert, sollte No Thinking beim Testen gleich viel Aufmerksamkeit erhalten, statt als grundsätzlich unterlegener Modus behandelt zu werden.
Googles eigene Einschränkungen relativieren das Ergebnis jedoch. Das Modell kann Anweisungen für maskierte Bearbeitungen nur teilweise befolgen, Kritzel- oder Tintenmarkierungen bewahren oder die Pose des Ausgangssubjekts beibehalten. Präferenz-Elo kann nicht belegen, dass Pixel außerhalb des erlaubten Bereichs unverändert blieben. Für Katalog- und regulierte Workflows ist daher eine separate Metrik zur Erhaltung unerlässlich.
Bei der Produktkonsistenz ist der Vergleich zwischen 2.1 No Thinking und den älteren Modellen weniger eindeutig. Die Werte betragen 1024 ±18 mit Thinking, 981 ±18 ohne Thinking, 955 ±22 für Nano Banana 2 Thinking und 965 ±14 für Pro. Das Intervall von No Thinking überlappt mit denen beider älterer Modelle. Das veröffentlichte Diagramm stützt daher Thinking als stärkste Konfiguration in dieser Evaluierung, belegt jedoch nicht die Behauptung, dass jede 2.1-Konfiguration die Produkttreue klar verbessert.
Die Bearbeitung mit mehreren Referenzen erzählt für 2.1 eine überzeugendere Geschichte: 1066 ±22 mit Thinking und 1041 ±20 ohne, gegenüber 988 ±13 für Nano Banana 2 Thinking und 989 ±12 für Pro. Dennoch überlappen sich die beiden 2.1-Intervalle, sodass die Differenz von 25 Punkten zwischen ihren zentralen Werten nicht überbewertet werden sollte.
Diese Aufgaben erfordern zudem unterschiedliche Akzeptanzregeln. Eine kreative Komposition kann geringfügige Änderungen der Geometrie tolerieren, während ein E-Commerce-Bild scheitern kann, wenn sich ein Logo, Anschluss, Knopf, Material oder die Packungsmenge verändert. Migrationsentscheidungen sollten daher je Bearbeitungsklasse getroffen werden, nicht auf Basis der pauschalen Schlussfolgerung, „Bearbeitung ist besser“.
Faktentreue ist vielversprechend, bleibt aber die schwächste Behauptung
Google berichtet Infografik-Faktizitätswerte von 0.521 für Nano Banana 2.1 Thinking, 0.328 ohne Thinking, 0.265 für Nano Banana Pro und 0.179 für Nano Banana 2 Thinking.

Redaktionelle Darstellung der AutoRater-Daten zur Faktentreue vom Oktober 2026 aus der Nano Banana 2.1 model card von Google DeepMind. Höher ist besser, doch dieser einseitige Wert eines automatisierten Raters ist kein Prozentsatz menschlicher Genauigkeit. Google veröffentlicht hierfür keine Unsicherheitsintervalle. Dies ist kein originales Google-Bild.
Das Ergebnis stützt eine begrenzte Schlussfolgerung: Unter Googles automatisierter Bewertung verbessert Thinking den Faktentreuewert von Nano Banana 2.1 deutlich, und der resultierende Wert übertrifft jene der aufgeführten Vergleichsmodelle. Es bedeutet nicht, dass 52.1 % der Infografiken faktisch korrekt sind. Die Model Card definiert den Wert nicht als Prozentsatz, veröffentlicht keine Unsicherheit, legt die Anzahl der Prompts nicht offen und liefert hier nicht genügend Details, um Fehlerraten zu berechnen.
Diese Unterscheidung ist wichtig, weil faktische Grafiken mehrere Fehlerquellen haben. Ein Diagramm kann korrekten Fließtext enthalten, aber falsche Werte darstellen. Es kann eine reale Quelle zitieren und dennoch Daten falsch zuordnen. Eine Karte kann Regionen vertauschen; eine Zeitleiste kann Ereignisse umkehren; ein Label kann dem falschen Objekt zugewiesen werden. Die automatisierte Bewertung kann einige dieser Fehler erfassen, aber die Tabelle legt ihre Abdeckung nicht ausreichend detailliert offen, um sie als Freigabekriterium zu behandeln.
Suchgestützte Verankerung kann aktuellere Informationen liefern, aber Retrieval garantiert keine getreue visuelle Übertragung. Die Model Card beschreibt außerdem einen Wissensstichtag von März 2026 für Gemini 3.6 Flash, wobei einige Bereiche möglicherweise auf Januar 2025 beschränkt sind und andere neuere Informationen erhalten. Bei zeitkritischen Grafiken sollte das Quellenmaterial ausdrücklich bereitgestellt oder abgerufen und anschließend mit dem gerenderten Bild abgeglichen werden.
Ein belastbarer Workflow trennt Quellenwahrheit von Darstellung. Pflegen Sie ein freigegebenes Faktenblatt mit Werten, Einheiten, Daten, Beschriftungen und Zitaten; erzeugen Sie die Visualisierung aus diesem Briefing; und vergleichen Sie anschließend jede gerenderte Aussage mit den freigegebenen Fakten. Hier hilft auch die Pflege nachvollziehbarer Quellfakten und Briefings für visuelle Inhalte, die Prüfung auf die zugrunde liegenden Belege statt auf die scheinbare Sicherheit des Bildes zu stützen.
Der Benchmark macht Thinking zum naheliegenden Kandidaten für Faktentreue, nicht zu einem autonomen Veröffentlichungssystem. Für medizinische, finanzielle, rechtliche, historische, wissenschaftliche und aktuelle Grafiken bleibt eine menschliche oder deterministische Prüfung erforderlich.
Ausgabe ist bei jeder Auflösung günstiger, Anfragen müssen es aber nicht sein
Bei den Standardtarifen der kostenpflichtigen API listet Google für die Bildausgabe von Nano Banana 2.1 $30 pro einer Million Bild-Output-Token. Nano Banana 2 kostet $60 pro einer Million. Diese Schlagzeile wirkt wie eine universelle Senkung um 50 %, doch unterschiedliche Token-Zuteilungen bei 4K und höhere Tarife außerhalb der Bildausgabe verkomplizieren die Gesamtrechnung.

Redaktionelle Berechnung auf Basis der Gemini API pricing von Google, Oktober 2026. Niedrigere Kosten ausschließlich für die Bildausgabe sind besser: Nano Banana 2.1 liegt bei 1K und 2K um 50 % und bei 4K um 25 % niedriger. Die Kosten schließen Eingaben, Text- oder Thinking-Ausgabe, Grounding, Wiederholungsversuche, Steuern und mögliche Batch-Rabatte aus. Dies ist kein originales Google-Bild.
Die transparente Berechnung lautet: Tarif multipliziert mit Bild-Output-Token:
Bei 1K kosten 1,120 Bild-Token $0.0336 für Nano Banana 2.1 und $0.0672 für Nano Banana 2. Bei 2K kosten 1,680 Token entsprechend $0.0504 und $0.1008. Bei 4K verwenden die Modelle unterschiedliche Token-Zuteilungen: 3,780 × $30 pro Million ergeben $0.1134 für 2.1, während 2,520 × $60 pro Million $0.1512 für Nano Banana 2 ergeben.
„Halber Preis“ trifft somit nur für Bild-Output-Token bei 1K und 2K zu. Bei 4K verwendet Nano Banana 2.1 mehr aufgeführte Bild-Token, wodurch die Einsparung ausschließlich bei der Ausgabe auf 25 % sinkt.
Andere Komponenten können sich in die entgegengesetzte Richtung entwickeln. Der Standardtarif für Eingaben bei Nano Banana 2.1 beträgt $1.50 pro einer Million Text-, Bild- oder Video-Token, gegenüber $0.50 pro einer Million Text- oder Bild-Token bei Nano Banana 2. Text- und Thinking-Ausgabe kostet bei 2.1 $7.50 pro einer Million Token, gegenüber $3 für Nano Banana 2. Eine vollständige Schätzung muss daher tatsächliche Input-Token, Textausgabe, Thinking-Verbrauch, gegebenenfalls Grounding-Gebühren, Wiederholungsversuche, Steuern und mögliche Batch-Rabatte einbeziehen.
Kein Gesamtbetrag für eine „typische Anfrage“ lässt sich verantwortungsvoll berechnen, ohne Prompt-Länge, Tokenisierung von Referenzbildern, Thinking-Nutzung, Auflösung und Wiederholungsrate anzunehmen. Ein günstigeres erfolgreiches Bild kann dennoch aus einer teureren Anfrage stammen, während eine bessere Akzeptanz beim ersten Durchlauf höhere Reasoning-Kosten ausgleichen kann. Messen Sie die Kosten pro akzeptiertem Asset, nicht lediglich den Preis pro erzeugtem Bild.
Ein vorgeschlagener Evaluierungsplan für die Migration
Das Folgende ist ein vorgeschlagenes Testdesign, keine Beschreibung von für diesen Artikel durchgeführten Tests.
Beginnen Sie mit einem stratifizierten Prompt-Set aus realer Arbeit. Trennen Sie Text-zu-Bild, Einzelcharaktere, mehrere Charaktere, Produktbearbeitung, maskierte Bearbeitung, Kompositionen mit mehreren Referenzen, textlastige Layouts und faktische Grafiken. Bewahren Sie Prompts, Referenzdateien, Seitenverhältnisse, Auflösungen und Sicherheitseinstellungen, damit jedes Modell dieselbe Aufgabe erhält.
Vergleichen Sie Nano Banana 2.1 mit minimalem, mittlerem und hohem Thinking mit Nano Banana 2 Thinking. Beziehen Sie Pro nur ein, wenn es eine tatsächliche Bereitstellungsoption ist; da das Benchmark-Diagramm die Einstellung von Pro nicht spezifiziert, sollten Sie nicht annehmen, dass dessen Compute- oder Reasoning-Konfiguration den anderen entspricht. Geben Sie jeder Bedingung im internen Test dasselbe Wiederholungsbudget, auch wenn Google nicht offenlegt, ob dies im Benchmark ebenfalls so gehandhabt wurde.
Definieren Sie Akzeptanzregeln, bevor Sie die Ergebnisse prüfen:
Bei Textrendering transkribieren Sie jedes erforderliche Wort und erfassen fehlenden, ersetzten, verschwommenen oder fehlerhaften Text.
Bei Identität bewerten Sie jeden Charakter unabhängig und erfassen das Übergreifen von Attributen, Duplikate, Auslassungen sowie Abweichungen bei Gesicht oder Kleidung.
Bei Produktarbeit vergleichen Sie geschützte Merkmale wie Form, Logo, Bedienelemente, Anzahl, Farbe, Material und Verpackungstext.
Bei maskierten Bearbeitungen messen Sie sowohl den Erfolg im angeforderten Bereich als auch unbeabsichtigte Änderungen außerhalb der Maske.
Bei räumlichen Prompts prüfen Sie links/rechts, Vordergrund/Hintergrund, Enthaltensein, Reihenfolge und relative Größe.
Bei faktischen Grafiken prüfen Sie jede Zahl, Einheit, jedes Datum, Label, Zitat und jede visuelle Kodierung gegen ein gesperrtes Quellenblatt.
Für den Betrieb erfassen Sie Timeouts, End-to-End-Latenz, Anzahl der Wiederholungen, Token-Verbrauch, Grounding-Gebühren und Kosten pro akzeptiertem Ergebnis.
Nutzen Sie verblindete menschliche Begutachtung für subjektive Qualität und deterministische Prüfungen, wo Exaktheit möglich ist. Berichten Sie Unsicherheit und bewahren Sie gepaarte Ergebnisse auf, da derselbe Prompt über Modelle hinweg aussagekräftiger ist als unverbundene Durchschnittswerte. Fassen Sie nicht alle Aufgaben in einem Wert zusammen, wenn Fehler unterschiedliche geschäftliche Folgen haben.
Testen Sie das Verhalten des Endpoints ebenso wie die Bildqualität. Bestätigen Sie die Grenzen von 131,072 Eingabe- und 32,768 Ausgabe-Token anhand der aktuellen API-Dokumentation, verifizieren Sie die Standardauflösung 1K und testen Sie 2K und 4K ausdrücklich. Testen Sie Eingaben mit 14 Referenzen nur bei Bedarf und bedenken Sie, dass Limits von vier Charakteren und zehn Objekten keine Bewahrung garantieren. Da Function Calling, Code-Ausführung und strukturierte Ausgaben nicht unterstützt werden, müssen Orchestrierung und Validierung außerhalb des Modells stattfinden.
Führen Sie schließlich vor der Umstellung des Produktionsverkehrs eine Shadow-Phase durch. Erfassen Sie Ablehnungsgründe und vergleichen Sie die Kosten pro akzeptiertem Asset. So wird sichtbar, ob Benchmark-Gewinne zu weniger Überarbeitungen führen, statt nur bessere erste Eindrücke zu erzeugen.
Wer migrieren sollte – und wer warten sollte
Nano Banana 2.1 ist der stärkere Kandidat, wenn ein Workflow von Infografikdesign, Szenen mit mehreren Charakteren, Kompositionen mit mehreren Referenzen, maskenbasierten Bearbeitungen oder niedrigeren Gebühren für die Bildausgabe abhängt. Thinking sollte bei faktischen Grafiken und komplexen Aufgaben mit mehreren Motiven Priorität haben. No Thinking bleibt für einfachere Generierung und Bearbeitung testenswert, insbesondere wenn sein veröffentlichtes Intervall Thinking überlappt oder Reasoning-Kosten wichtig sind.
Mit der Migration sollte gewartet werden, wenn exakter kleiner Text, lange Passagen, strenge Identitätsbewahrung, Bearbeitung geschützter Bereiche, räumliche Präzision oder verifizierte Fakten unverhandelbar sind und der Organisation ein externer Validierungsschritt fehlt. Dasselbe gilt, wenn bestehende Automatisierung von nicht unterstütztem Function Calling, Code-Ausführung oder strukturierter Ausgabe abhängt.
Abweichungen in der Dokumentation sollten konservativ behandelt werden: Folgen Sie den aktuellen Grenzen des gewählten Endpoints und messen Sie das beobachtete Verhalten, statt Kapazität aus der umfassenderen Modellarchitektur abzuleiten. Ebenso führt die aktuelle deprecations table Gemini 3.1 Flash Image als veraltet auf, nennt jedoch kein Abschaltdatum. Es gibt keine verifizierte Stilllegungsfrist zum 29. Oktober, die eine überstürzte Umstellung erzwingen würde.
Die Entscheidung ist daher konkret. Migrieren Sie, wenn Nano Banana 2.1 aufgabenspezifische Schwellenwerte für Genauigkeit erfüllt, die Kosten pro akzeptiertem Bild senkt und gemessene Anforderungen an Latenz und Timeouts erfüllt. Verwenden Sie Thinking nur dort, wo sein Gewinn bei der Akzeptanzrate die zusätzlichen Ausgabekosten rechtfertigt. Behalten Sie Nano Banana 2 oder einen anderen Fallback bei, bis 2.1 Shadow-Tests besteht. Und verlangen Sie bei faktischen, identitätssensiblen oder präzise bearbeiteten Assets eine Validierung, unabhängig davon, welches Modell im Benchmark führt.


