La actualización DeepSeek V4.1 Flash eleva las puntuaciones, pero la evidencia sigue siendo interna

Revisión de fuentes del 19 de octubre de 2026: DeepSeek-V4.1-Flash-1017 es la actualización del 17 de octubre del modelo V4.1 Flash publicado en septiembre. Las figuras siguientes se han elaborado de forma independiente a partir de la ficha del modelo, pero las mediciones son de DeepSeek; no son una reproducción independiente. Los precios de la API no cambiaron con esta actualización. La tabla comparativa no publica tamaños de muestra, intervalos de incertidumbre ni presupuestos de cómputo equiparados entre proveedores. — Fuente
DeepSeek lanzó una actualización de DeepSeek V4.1 Flash el 17 de octubre, con la que afirma obtener mayores puntuaciones en benchmarks, completar tareas más rápido y generar respuestas más cortas. El checkpoint, denominado DeepSeek-V4.1-Flash-1017, sustituye a la versión de septiembre en la aplicación web, la aplicación móvil y la API de DeepSeek.
El cambio importante no es una nueva familia de modelos ni una nueva arquitectura. DeepSeek describe 1017 como una actualización menor del modelo V4.1 Flash existente. Los desarrolladores siguen llamando a deepseek-flash, mientras el servicio dirige las solicitudes al nuevo checkpoint sin requerir una migración de API.
Esa sustitución discreta genera la tensión central. DeepSeek presenta un equilibrio más sólido entre rendimiento y coste, especialmente para agentes de programación y trabajo guiado por herramientas. Sin embargo, los resultados publicados siguen siendo comunicados por la empresa, y no se han divulgado varios detalles de evaluación necesarios para comparaciones precisas.
Las cifras de DeepSeek aun así merecen atención. Las mayores mejoras aparecen en trabajo de terminal, síntesis de programas, automatización y tareas que abarcan repositorios de software completos. Son las cargas de trabajo en las que Anthropic, OpenAI, Google, Moonshot AI y Zhipu AI compiten por la adopción de los desarrolladores.
Por tanto, la actualización presiona más que las clasificaciones de benchmarks. Desafía a los proveedores a demostrar que los modelos premium terminan tareas reales de forma más fiable, con menos tokens y menor intervención humana. DeepSeek ha mejorado su parte de ese argumento, pero las pruebas externas deben determinar ahora cuánto cambia la actualización los resultados de producción.
La actualización DeepSeek V4.1 Flash es un checkpoint, no una nueva arquitectura
DeepSeek ha actualizado el modelo detrás de un producto existente en lugar de lanzar otra generación de arquitectura.
El registro de cambios de octubre de la empresa indica que DeepSeek V4.1 Flash se ha actualizado a DeepSeek-V4.1-Flash-1017. Las aplicaciones web y móvil utilizan ahora la nueva versión, junto con el endpoint de la API.
Los usuarios actuales de la API no necesitan un nuevo identificador de modelo. Las solicitudes que usan deepseek-flash llegan al checkpoint más reciente. Según la documentación de DeepSeek, los identificadores heredados de modelos Flash anteriores también se dirigen a la versión actual.
Este método de entrega puede hacer que 1017 parezca más pequeño de lo que es. Un endpoint estable reduce el trabajo de migración, pero también implica que el comportamiento de la aplicación puede cambiar sin que cambie el nombre del modelo. Los equipos que evalúan la consistencia de las respuestas deberían registrar el checkpoint servido, no solo el identificador de la API.
El lanzamiento es distinto del lanzamiento original de V4.1 Flash el 10 de septiembre. Ese lanzamiento anterior introdujo la arquitectura de la familia de modelos, comprensión visual nativa, soporte para contextos más largos y un diseño de inferencia revisado. El checkpoint de octubre actualiza el modelo sobre esa base ya establecida.
La arquitectura utiliza un diseño de mezcla de expertos, o MoE. Este enfoque activa solo una parte de una red mucho mayor para cada token, con el objetivo de reducir el cómputo mientras preserva una amplia capacidad del modelo.
DeepSeek reveló una arquitectura base de 552.000 millones de parámetros para el modelo de septiembre. Indicó que 8.000 millones de parámetros están activos al procesar la entrada y 16.000 millones durante la generación de salida. Estas especificaciones describen la arquitectura V4.1, no una nueva configuración de parámetros introducida con 1017.
El lanzamiento original también describió un diseño causal de codificador-decodificador. En términos simples, el modelo asigna distinta capacidad activa a comprender los prompts y generar respuestas. DeepSeek presenta esa asimetría como una forma de mejorar el rendimiento y reducir las exigencias de memoria.
Su informe técnico describe compatibilidad con contextos de hasta un millón de tokens. Una ventana de contexto es la cantidad de material que un modelo puede considerar en una solicitud. La documentación actual de DeepSeek también indica un máximo de salida de 384.000 tokens.
Esos límites no llegaron con 1017. Tampoco la visión nativa, que ya formaba parte de V4.1 Flash. Tratar esas capacidades como novedades de octubre exageraría lo que cambió.
En cambio, 1017 parece ser una actualización de posentrenamiento y comportamiento. DeepSeek afirma que mejora el razonamiento, la programación, el trabajo de agentes y las tareas visuales, al tiempo que reduce el tiempo de ejecución y la longitud de las respuestas. La empresa no ha publicado un recuento de parámetros nuevo e independiente para este checkpoint.
La distribución abierta del modelo también importa. DeepSeek publicó el checkpoint a través de su repositorio de modelos bajo una licencia MIT. Esto da a investigadores y equipos de infraestructura acceso a los pesos, sujetos a las exigencias prácticas de servir un modelo tan grande.
Los pesos abiertos permiten una inspección más profunda. No hacen que la evaluación independiente sea inmediata ni barata. Reproducir benchmarks de agentes requiere infraestructura compatible, configuraciones de harness, acceso a herramientas, políticas de reintento y un cómputo considerable.
El resultado es un lanzamiento fácil de acceder mediante una API, pero más difícil de validar de forma exhaustiva. Esa brecha explica por qué la tabla de benchmarks de DeepSeek concentra actualmente la mayor parte de la historia.
Los benchmarks de programación de DeepSeek muestran dónde mejoró la actualización
Las mejoras reportadas más fuertes se concentran en tareas de programación y agentes, donde las ejecuciones más cortas pueden importar tanto como una mayor precisión.
El mayor cambio entre estas cuatro pruebas de programación corresponde a Terminal-Bench 4.0: pasa de 31.2 a 42.3, una mejora de 11.1 puntos, aproximadamente un 35.6% respecto a la puntuación anterior. DeepSWE v1.1 sube de 74.2 a 77.0. La comparación competitiva es mixta: la tabla del proveedor sitúa a Flash-1017 por encima del modelo identificado como Opus 5 en DeepSWE, pero por debajo en Terminal-Bench, ProgramBench y NL2Repo-Bench. La comparación conserva la denominación exacta de la fuente, Opus 5. Terminal-Bench utiliza Claude Code, mientras que DeepSWE utiliza Mini-SWE-V2. La tabla no demuestra una comparación con presupuestos iguales ni tasas de éxito en producción.

Gráfico editorial con datos de la ficha de DeepSeek del 17 de octubre de 2026. Una puntuación mayor es mejor. Terminal-Bench: Claude Code; DeepSWE: Mini-SWE-V2. La tabla no publica fecha de evaluación, tamaño de muestra, esfuerzo de razonamiento, reintentos ni presupuestos equiparados de tokens y tiempo. — Fuente
DeepSeek informa una puntuación de 42,3 en Terminal-Bench 4.0 para el checkpoint 1017. El modelo V4.1 Flash de septiembre obtuvo 31,2 en la comparación de la empresa. Esto representa un aumento de 11,1 puntos dentro de la configuración publicada por DeepSeek.
Terminal-Bench evalúa agentes que operan en entornos de línea de comandos. Estas tareas requieren más que escribir una función aislada. El modelo debe interpretar objetivos, usar herramientas, navegar archivos, ejecutar comandos y recuperarse de errores.
La empresa dice que probó Terminal-Bench 4.0 mediante el framework Claude Code. Ese detalle importa porque un framework de agentes determina las herramientas, instrucciones y bucle de interacción disponibles para el modelo subyacente.
En DeepSWE v1.1, DeepSeek informa un aumento de 74,2 a 77,0. Para esa evaluación utilizó el framework Mini-SWE-V2. Los benchmarks de ingeniería de software pueden ser muy sensibles a la configuración del repositorio, los permisos de herramientas y los intentos permitidos.
ProgramBench muestra un salto numérico mayor, de 20,3 a 29,1. NL2Repo-Bench sube de 65,4 a 68,2. Este último se centra en traducir solicitudes en lenguaje natural en cambios en repositorios de software.
El patrón sugiere que DeepSeek se dirigió a flujos de trabajo de programación sostenidos, y no solo a programación de respuestas cortas. Esta distinción importa para empresas que prueban agentes frente a colas de incidencias, tareas de revisión de código, migraciones y sesiones de depuración.
Los benchmarks de agentes muestran una dirección similar. DeepSeek informa 60,5 en Automation-Bench v1.0.6, frente a 54,8 para el checkpoint anterior. Agents’ Last Exam sube de 31,8 a 35,4.
Apex Bench v1.1 pasa de 64,6 a 72,1 en la tabla de la empresa. DeepSeek presenta estos resultados como evidencia de que la actualización puede manejar secuencias más largas que incluyen planificación, uso de herramientas y ejecución.
Las puntuaciones de agentes visuales también aumentaron. Chartography con herramientas subió de 78,9 a 83,0, mientras que BabyVision pasó de 89,6 a 92,5. ZeroBench-main con herramientas aumentó de 49,0 a 51,0.
DeepSeek afirma que ZeroBench-main utilizó Pass@5. Esta métrica permite hasta cinco intentos y registra si al menos uno tiene éxito. No debe interpretarse como directamente equivalente a una tasa de éxito en el primer intento.
La empresa también informa 42,6 en Humanity’s Last Exam sin herramientas. Indica 44,0 para un subconjunto de texto puro, aunque el resultado del subconjunto no debería sustituir la puntuación de la evaluación más amplia.
Las mejoras en benchmarks son coherentes en todas las comparaciones con modelos anteriores publicadas en la tabla. Ningún resultado listado muestra que el checkpoint 1017 quede por detrás de la versión de septiembre. Esa consistencia respalda la afirmación de DeepSeek de que la actualización es ampliamente mejor dentro de las evaluaciones elegidas.
Sin embargo, la tabla no revela los tamaños de muestra de varias comparaciones. También omite hardware, presupuestos de tokens, límites de tiempo, presupuestos de reintentos y configuraciones de esfuerzo de razonamiento. Estas variables pueden afectar materialmente las evaluaciones de agentes.
Un modelo al que se le permiten más llamadas a herramientas o más tokens de razonamiento puede terminar tareas que una configuración más estricta no logra completar. También puede consumir más tiempo y recursos mientras produce una puntuación mejor.
DeepSeek afirma que el nuevo checkpoint reduce tanto el tiempo de ejecución como la longitud de salida. Esta afirmación es central porque una salida más corta puede reducir la cantidad de texto generado que una aplicación debe procesar. Una finalización más rápida también puede mejorar la experiencia de usuario y el rendimiento de los agentes.
Sin embargo, los materiales de lanzamiento no ofrecen un porcentaje universal para ninguna de las dos reducciones. El tiempo de ejecución varía según la carga de trabajo, la infraestructura, la longitud del contexto y el framework de agentes. La longitud de salida cambia según los prompts y la complejidad de las tareas.
Por ello, la interpretación responsable es limitada. DeepSeek informa mejores puntuaciones, finalización más rápida y respuestas más cortas en sus harnesses evaluados. La mejora exacta en producción sigue dependiendo de la carga de trabajo.
Las respuestas más cortas son la verdadera presión competitiva
DeepSeek sostiene que el rendimiento útil de la IA debe medirse por tarea completada, no solo por puntuaciones brutas de inteligencia.
DeepSeek informa de aumentos de 54.8 a 60.5 en Automation-Bench v1.0.6, de 31.8 a 35.4 en Agents’ Last Exam y de 64.6 a 72.1 en Apex Bench v1.1. Flash-1017 supera el resultado de Opus 5 de la tabla en estas tres pruebas, aunque cada una evalúa un conjunto de tareas distinto. Estas puntuaciones justifican seguir evaluándolo para flujos de trabajo con agentes; no demuestran una ejecución fiable en un entorno sin restricciones. Los operadores deberían medir, en sus propias cargas, la finalización correcta de tareas, los reintentos totales, los errores de herramientas, el tiempo de revisión y el coste total de tokens. DeepSeek recomienda Harness 0.2.1-rc.1 o posterior para esta versión.

Gráfico editorial de tres evaluaciones de agentes distintas realizadas por DeepSeek para la versión del 17 de octubre de 2026; una puntuación mayor es mejor. La tabla no publica el esfuerzo exacto entre proveedores, los presupuestos de tokens y tiempo, el tamaño de muestra ni la fecha de evaluación. Los tres resultados no deben combinarse en una puntuación global. — Fuente
Los compradores de modelos se preocupan cada vez más por cuántos flujos de trabajo exitosos completa un sistema dentro de un presupuesto y un límite de tiempo. Una puntuación alta en un benchmark pierde valor cuando el modelo entra en bucles, escribe explicaciones innecesarias o llama repetidamente a herramientas.
Las tareas de agentes amplifican este problema. Un asistente de programación puede generar miles de tokens mientras explora el camino equivocado. También puede perder tiempo releyendo archivos o intentando correcciones que no abordan el problema subyacente.
La afirmación de DeepSeek sobre salidas más cortas apunta directamente a esa ineficiencia. Si 1017 alcanza el mismo resultado o uno mejor con menos tokens generados, puede reducir conjuntamente la latencia y el gasto operativo. Esto es más relevante que una prosa concisa por sí sola.
La empresa denomina el cambio una mejora de Pareto en rendimiento frente a coste. Una mejora de Pareto significa que una opción mejora en al menos una dimensión significativa sin empeorar en las demás que se están midiendo.
Aquí, DeepSeek afirma un rendimiento más sólido en benchmarks junto con menor tiempo de ejecución y una salida más corta. El argumento es que los desarrolladores ya no necesitan sacrificar tanta capacidad por velocidad o eficiencia.
La evidencia disponible respalda el lado del rendimiento dentro de la tabla de evaluación de DeepSeek. No establece por completo el coste por éxito porque la empresa no ha publicado mediciones detalladas de recursos a nivel de tarea.
Las especificaciones actuales del modelo muestran que Flash-1017 conserva la configuración de servicio existente. Los modos con razonamiento y sin razonamiento siguen disponibles, junto con llamadas a herramientas, salida JSON, visión y formatos de API compatibles.
El endpoint sin cambios también reduce la fricción de despliegue. Un equipo puede probar el nuevo comportamiento sin reescribir su integración. Esa ventaja puede acelerar la adopción, especialmente entre los desarrolladores que ya utilizan DeepSeek Flash.
También crea riesgo operativo. Las aplicaciones desarrolladas en torno a un tono, estructura de salida o comportamiento de rechazo estable pueden reaccionar mal a un cambio silencioso de checkpoint. Las pruebas de regresión se vuelven esenciales cuando el modelo alojado cambia detrás de un nombre persistente.
Para las plataformas de programación, la presión inmediata recae sobre los modelos vendidos en torno a una fiabilidad premium. La tabla de DeepSeek compara 1017 con K3, GLM-5.3, GPT-5.6 Sol y un modelo denominado Opus 5.
Esas etiquetas deben citarse exactamente como las proporciona DeepSeek. La tabla no evalúa todos los modelos actuales de cada empresa. Su etiqueta Opus 5 no debe convertirse silenciosamente en otra versión de Anthropic.
El checkpoint de DeepSeek supera a la referencia Opus 5 de la tabla en DeepSWE v1.1, Automation-Bench, Agents’ Last Exam y Apex Bench. Queda por detrás de esa referencia en Terminal-Bench, ProgramBench, NL2Repo-Bench y tres pruebas visuales incluidas.
Ese resultado desigual es más informativo que una simple afirmación de victoria. DeepSeek parece especialmente competitivo en varias evaluaciones de agentes, pero la propia tabla del proveedor no muestra que lidere todas las categorías.
La presión sobre los rivales procede del conjunto. DeepSeek combina pesos accesibles, una ruta de API estable, una amplia ventana de contexto, entrada multimodal y mejores puntuaciones de agentes. Cada atributo amplía el número de equipos dispuestos a probarlo.
El lanzamiento de septiembre ya planteaba la eficiencia como un objetivo arquitectónico. DeepSeek afirmó que V4.1 Flash utilizaba una cuarta parte de la memoria de alto ancho de banda y una octava parte del almacenamiento de estado sólido para su caché clave-valor.
Una caché clave-valor almacena información generada durante la inferencia para que el modelo no recalcule todo con cada nuevo token. Las cachés más pequeñas pueden reducir la carga de memoria de los prompts largos y las interacciones repetidas con agentes.
Esas afirmaciones arquitectónicas corresponden a V4.1 Flash como familia. La novedad de octubre es que DeepSeek afirma que el postentrenamiento hizo más eficaz el diseño existente. No anunció otro rediseño de la caché con 1017.
Esta distinción importa para los compradores. La arquitectura explica por qué un modelo podría ser económico de servir. El comportamiento del checkpoint determina si completa las tareas reales del comprador con precisión y eficiencia.
Por tanto, los equipos que evalúen la actualización deberían medir el trabajo completado, no solo los tokens generados. Deberían hacer seguimiento de los cambios exitosos, los resultados aceptados, las correcciones humanas, el tiempo transcurrido y los reintentos en flujos de trabajo representativos.
Esta evaluación puede integrarse en flujos de trabajo de IA más amplios. El paso esencial es conservar los prompts, el material de origen, los resultados y las decisiones de revisión para compararlos posteriormente.
Lo que la tabla de benchmarks no establece
Las cifras de DeepSeek son evidencia significativa de su dirección de ingeniería, pero no constituyen una confirmación independiente de la fiabilidad en producción.
Los resultados visuales con herramientas mejoran, pero no muestran un liderazgo en todas las pruebas. Chartography pasa de 78.9 a 83.0, BabyVision de 89.6 a 92.5 y ZeroBench-main de 49.0 a 51.0. Las puntuaciones de Opus 5 de la fuente siguen siendo superiores: 84.0, 94.1 y 52.0. Son evaluaciones con herramientas, por lo que no equivalen a precisión bruta con imágenes únicamente. ZeroBench-main utiliza Pass@5, que permite varios intentos; su resultado no debe presentarse como fiabilidad al primer intento. Los agentes visuales siguen necesitando permisos adecuados para las herramientas, recuperación de errores y revisión humana en acciones de consecuencias importantes.

Evaluaciones visuales con herramientas realizadas por DeepSeek para la versión del 17 de octubre de 2026; una puntuación mayor es mejor. ZeroBench-main es Pass@5. La tabla no publica otros límites de reintentos, tamaños de muestra, intervalos de incertidumbre, presupuestos equiparados ni fecha de evaluación. — Fuente
La principal limitación es la independencia de las fuentes. DeepSeek publicó la comparación y eligió los modelos, benchmarks, arneses y configuraciones. Las fuentes primarias revisadas para este artículo no aportan un resultado reproducido de forma independiente para el checkpoint exacto 1017.
Eso no hace que las puntuaciones sean falsas. Las evaluaciones de proveedores suelen ser la primera evidencia disponible tras el lanzamiento de un modelo. Pueden mostrar dónde invirtió una empresa y qué cargas de trabajo espera mejorar.
No pueden resolver todas las comparaciones. Los benchmarks de agentes contienen más elementos variables que las pruebas estándar de preguntas y respuestas. El prompt de sistema, las herramientas, el tiempo límite, el sandbox y la lógica de reintentos de un marco pueden cambiar la puntuación final.
DeepSeek revela algunas condiciones. Terminal-Bench utilizó Claude Code, DeepSWE utilizó Mini-SWE-V2 y ZeroBench-main utilizó Pass@5. La empresa también recomienda DeepSeek Harness versión 0.2.1-rc.1 o posterior.
Esa recomendación sugiere que la integración del arnés forma parte de la historia del rendimiento. DeepSeek afirma que optimizó el modelo para su propio arnés, Tencent CodeBuddy, WorkBuddy y otras plataformas.
Las mejoras del modelo y del arnés son ambas legítimas. Sin embargo, los compradores necesitan saber si las ganancias se trasladan entre entornos. Un checkpoint ajustado en torno a un bucle de agente podría rendir de forma distinta dentro de la capa de orquestación de otra empresa.
La ausencia de ajustes de razonamiento divulgados añade incertidumbre. DeepSeek admite varios niveles de esfuerzo de pensamiento, que afectan a cuánta computación interna recibe una solicitud. Un ajuste más alto puede mejorar los resultados al tiempo que aumenta la latencia o el uso de tokens.
Los detalles del hardware también importan para las afirmaciones sobre velocidad. El tiempo de ejecución en un servicio alojado no se traduce directamente a la inferencia autoalojada. La sobrecarga de red, el procesamiento por lotes, la cuantización y la elección de acelerador pueden dominar la latencia observada.
Los pesos abiertos hacen que estas cuestiones sean comprobables, pero el autoalojamiento no es automáticamente sencillo. Una arquitectura base de 552.000 millones de parámetros exige mucho almacenamiento y memoria, incluso cuando solo se activa una parte de la red por token.
La cuantización reduce la memoria al almacenar los pesos con menor precisión numérica. Puede hacer más práctico el despliegue, pero los resultados pueden diferir de la configuración oficial del checkpoint. Los equipos deberían validar la precisión después de cualquier conversión.
La seguridad plantea otra preocupación de producción. Los agentes de programación suelen leer repositorios, ejecutar comandos, instalar paquetes y modificar archivos. Una mejor puntuación de benchmark no demuestra que un modelo pueda recibir de forma segura permisos amplios.
Las organizaciones deberían aislar el trabajo de los agentes, restringir las credenciales, registrar las llamadas a herramientas y exigir revisión para los cambios sensibles. Estos controles se aplican a todos los modelos de programación, independientemente de su posición en los benchmarks.
La misma cautela se aplica a la ventana de contexto de un millón de tokens. Admitir un contexto amplio no garantiza una recuperación fiable desde todas las posiciones. Los prompts largos pueden introducir distracciones, instrucciones contradictorias y procesamiento innecesario.
La compatibilidad nativa de DeepSeek con visión también es anterior a la actualización de octubre. Las puntuaciones más altas de agentes visuales sugieren un uso mejorado de esa capacidad, pero no demuestran una fiabilidad equivalente en gráficos, interfaces, documentos e imágenes naturales.
El contexto histórico refuerza la necesidad de hacer afirmaciones moderadas. El lanzamiento de V4 de DeepSeek atrajo atención porque combinaba compatibilidad con contexto amplio y una arquitectura centrada en la eficiencia. Analistas independientes citados en cobertura anterior consideraron que la familia era competitiva frente a los principales modelos estadounidenses.
Esa competitividad más amplia no valida automáticamente las mejoras exactas del nuevo checkpoint. Los pesos 1017 requieren sus propias pruebas, especialmente en cargas de trabajo que se parezcan a implementaciones reales.
Una evaluación práctica debería comparar ambos checkpoints con prompts y herramientas idénticos. Debería conservar la temperatura, los ajustes de esfuerzo, los tiempos límite, el número de reintentos y los estados de los repositorios.
Los revisores también deberían puntuar la calidad de los resultados después de eliminar las ventajas de la verbosidad. Una respuesta más corta es útil cuando sigue siendo completa. Se convierte en una regresión si omite pruebas, advertencias, pasos de migración o explicaciones de fallos.
Para el trabajo de conocimiento, la concisión puede generar compromisos similares. Los resúmenes breves reducen el tiempo de lectura, pero las respuestas comprimidas pueden ocultar incertidumbre o descartar evidencia minoritaria. La revisión humana sigue siendo necesaria para decisiones relevantes.
Por tanto, el escepticismo adecuado es específico. DeepSeek ha publicado evidencia propia creíble de mejora. Todavía no ha demostrado ganancias universales de velocidad, un menor coste total por tarea ni una fiabilidad superior en entornos de producción independientes.
Tres señales mostrarán si Flash-1017 cambia el mercado
La reproducción independiente, el rendimiento entre distintos arneses y la adopción sostenida por desarrolladores determinarán si 1017 se convierte en algo más que un sólido lanzamiento de benchmark de un proveedor.
La actualización del 17 de octubre sustituye el checkpoint servido mediante el alias de API deepseek-flash y mantiene los precios. Según la consulta del 19 de octubre, un millón de tokens Flash cuesta, fuera de horas punta, 0.003 dólares de entrada en caché, 0.15 dólares de entrada sin caché y 0.60 dólares de salida; en horas punta, las tarifas son 0.006, 0.30 y 1.20 dólares. En una tarea expresamente hipotética con un millón de tokens de entrada sin caché, cuatro millones de entrada en caché y 100,000 de salida, el cargo por tokens del modelo sería de 0.222 dólares fuera de horas punta o 0.444 en horas punta. Este cálculo excluye búsqueda y recuperación, infraestructura, reintentos y revisión humana. Una salida más corta puede reducir el cargo de salida, pero la afirmación de DeepSeek sobre velocidad y coste no implica un ahorro fijo en todas las cargas.
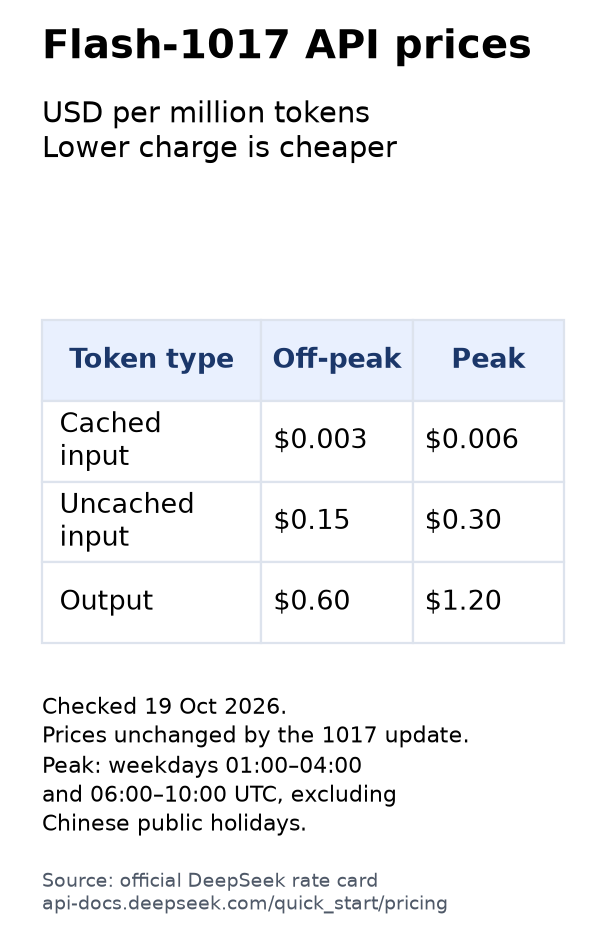
Tarifas oficiales de Flash-1017 consultadas el 19 de octubre de 2026, en dólares estadounidenses por millón de tokens; un cargo menor es más barato. Las horas punta son los días laborables de 01:00–04:00 y 06:00–10:00 UTC, excepto los festivos oficiales de China. Los precios de tokens del modelo son independientes de la búsqueda, la recuperación y otros costes operativos. — Fuente
La primera señal es la evaluación independiente del checkpoint 1017 exacto. Los investigadores deben probar los pesos publicados, en lugar del modelo de septiembre o un alias alojado con una versión incierta.
Esas pruebas deberían publicar los prompts, las versiones de los arneses, los ajustes de esfuerzo, el hardware, los límites de tiempo y las políticas de reintento. Los resultados deberían incluir precisión, tiempo transcurrido, tokens de salida y comportamiento ante tareas fallidas.
Reproducir la dirección de los resultados reportados por DeepSeek reforzaría el caso de la empresa. Grandes regresiones o ganancias muy dependientes de la configuración lo debilitarían. Los resultados mixtos sugerirían que 1017 beneficia algunos bucles de agentes más que otros.
La segunda señal es el rendimiento en múltiples arneses. DeepSeek optimizó específicamente para plataformas seleccionadas, lo que convierte la portabilidad en una cuestión central. El modelo debería conservar sus ganancias en agentes de programación alternativos y sistemas empresariales de orquestación.
Las pruebas entre arneses pueden separar la mejora del modelo de la mejora de integración. Ambas tienen valor, pero responden a preguntas de compra diferentes.
Una empresa que adopte DeepSeek Harness puede beneficiarse del sistema combinado. Una empresa que conserve un agente interno establecido necesita evidencia de que el checkpoint por sí solo mejora su flujo de trabajo.
Observe si las pruebas de terceros reproducen el aumento de Terminal-Bench sin modificar el acceso a las herramientas. Observe también si las respuestas más cortas siguen siendo completas cuando otro marco utiliza un prompt de sistema diferente.
Las ganancias consistentes respaldarían la afirmación de DeepSeek de contar con un checkpoint subyacente mejor. Las ganancias limitadas a los arneses preferidos harían que la elección de integración fuera una parte más importante de la decisión.
La tercera señal es la adopción sostenida por desarrolladores después del ciclo inicial de lanzamiento. Las descargas, integraciones, pruebas reproducibles y estudios de caso de producción importan más que la atención de la semana de lanzamiento.
Los pesos bajo licencia MIT reducen la fricción legal para la experimentación. Sin embargo, la escala del modelo eleva el umbral de infraestructura para un autoalojamiento serio. Muchos equipos seguirán eligiendo acceso alojado o proveedores especializados de inferencia.
Por tanto, la adopción debería medirse en ambas rutas. El uso alojado muestra si la experiencia de API es atractiva. Los despliegues autoalojados muestran si el acceso abierto crea alternativas prácticas para organizaciones con requisitos especializados.
La retención importa más que las pruebas. Los desarrolladores prueban frecuentemente nuevos modelos porque cambiar un identificador de API es sencillo. Conservan un modelo solo cuando mejora el trabajo aceptado sin crear nuevas cargas de revisión.
El resultado probable a corto plazo es una evaluación más amplia, no una reestructuración inmediata del mercado. DeepSeek ha dado a los equipos de agentes de programación una razón concreta para repetir sus evaluaciones. Sus mayores ganancias reportadas se alinean con tareas que los desarrolladores ya tienen dificultades para automatizar de forma fiable.
Los competidores aún tienen margen para responder con mejores modelos, marcos de agentes más sólidos, menor latencia, ejecución más segura o comportamiento más predecible. La propia tabla de DeepSeek muestra que el checkpoint 1017 no lidera todas las comparaciones.
El lanzamiento también demuestra una cadencia competitiva más rápida. En septiembre llegó una arquitectura importante, seguida cinco semanas después por un checkpoint centrado en el comportamiento. El enrutamiento estable de la API permite a DeepSeek distribuir esa mejora de inmediato.
Esa cadencia beneficia a los usuarios cuando las actualizaciones producen ganancias medibles. Complica la gobernanza cuando el comportamiento cambia más rápido que los ciclos de evaluación empresariales. Los equipos necesitan registros de versiones y suites periódicas de regresión para gestionar ambos efectos.
Para los desarrolladores, la decisión es sencilla. Prueben DeepSeek-V4.1-Flash-1017 con las tareas exactas que realizan sus usuarios. Midan los resultados aceptados, los reintentos, la latencia, la longitud de salida y las correcciones humanas.
Los compradores empresariales deberían pedir a los proveedores identificadores de checkpoint y avisos de cambios. También deberían exigir condiciones de evaluación reproducibles antes de tratar cualquier liderazgo en benchmarks como una conclusión de compra.
Los trabajadores del conocimiento deberían prestar atención a si las respuestas más cortas conservan la evidencia y los matices. Una respuesta más rápida aporta poco valor cuando alguien debe reconstruir después el razonamiento que falta.
La actualización DeepSeek V4.1 Flash ya ha cambiado el conjunto de comparación. Eleva las puntuaciones de programación y agentes del checkpoint anterior mientras mantiene la misma ruta de acceso y familia de modelos.
Lo que ocurra después depende de evidencia fuera del laboratorio de DeepSeek. Ejecute comparaciones controladas, conserve el registro completo de evaluación y observe si las pruebas independientes reproducen la combinación declarada de precisión, velocidad y concisión.


