Nano Banana 2.1: Lo que revelan los benchmarks de imagen de Google


Google lanzó Nano Banana 2.1 el 6 de octubre de 2026. Este análisis, fechado el 14 de octubre, lo aborda como una continuación de aquel lanzamiento, no como un nuevo estreno hoy.
Los resultados publicados constituyen un argumento creíble de que Nano Banana 2.1 mejora respecto a Nano Banana 2 en varias tareas de generación y edición de imágenes. Las mayores ventajas comunicadas aparecen en el diseño de infografías, la consistencia entre varios personajes, la edición basada en máscaras y el trabajo con múltiples referencias. Activar Thinking suele producir las puntuaciones más altas, aunque su valor varía según la tarea.
Estos hallazgos requieren límites claros. La mayoría de las puntuaciones son valoraciones Elo basadas en preferencias, no porcentajes de imágenes correctas. Google proporciona márgenes de error para los resultados Elo, pero no define su nivel de confianza. No revela los tamaños de muestra, los prompts de los benchmarks, las resoluciones de imagen, los presupuestos de reintentos, la configuración detallada de Thinking ni las condiciones de cómputo equivalentes en la tabla de la ficha del modelo. El resultado de factualidad procede de un evaluador automatizado, no de una medición humana de precisión.
Por consiguiente, los benchmarks son evidencia útil sobre el rendimiento relativo bajo la evaluación de Google, pero no establecen la fiabilidad en producción, la latencia ni el retorno de la inversión. Los equipos que estén considerando una migración aún necesitan pruebas específicas para sus cargas de trabajo, con entradas controladas, criterios de fallo y costes completos por solicitud.
Lo que Google lanzó realmente el 6 de octubre
Nano Banana 2.1 es el modelo actualizado de Google, de clase Flash, para generación de imágenes y edición conversacional. El código estable del modelo en Gemini API es gemini-nano-banana-2.1. Google lo describe como una actualización de Gemini 3.1 Flash Image, también llamado Nano Banana 2, y como una alternativa más eficiente a Gemini 3 Pro Image, conocido habitualmente como Nano Banana Pro. El changelog de Gemini API registra su lanzamiento de disponibilidad general el 6 de octubre de 2026.
Según la ficha del modelo Nano Banana 2.1, el modelo se basa en Gemini 3.6 Flash y acepta texto e imágenes, mientras devuelve imágenes y texto. Google lo posiciona para la creación controlada de imágenes, la edición, los gráficos con mucho texto, el renderizado localizado y los flujos de trabajo iterativos. Su evaluación combina juicios humanos de preferencia lado a lado para generación y edición con una única evaluación automatizada de factualidad.
La ficha también identifica limitaciones concretas: el texto pequeño o extenso puede desenfocarse o degradarse; la identidad puede desviarse; las ediciones enmascaradas pueden conservar trazos de tinta o seguir las instrucciones solo parcialmente; las poses pueden persistir de forma inesperada; pueden confundirse relaciones espaciales como izquierda y derecha; y el conocimiento del mundo, el razonamiento 3D y la factualidad siguen siendo imperfectos. También se reconocen lentitud ocasional y tiempos de espera agotados. No son notas al pie, sino riesgos operativos: cada uno requiere una prueba de aceptación y una política de respaldo antes del despliegue.
La documentación del modelo API de Google añade detalles de implementación. La salida predeterminada es 1K y puede solicitarse hasta 4K. Thinking ofrece minimal, medium—el valor predeterminado—y high. El modelo admite grounding con búsqueda, pero no llamadas a funciones, ejecución de código ni salidas estructuradas.
La tarjeta del modelo indica un contexto de hasta un millón de tokens y una salida de texto de hasta 64K, mientras que la página de la API de Gemini implementada indica 131,072 tokens de entrada y 32,768 tokens de salida. Los documentos públicos no explican la relación entre estos límites diferentes. Los implementadores deben seguir los límites documentados del endpoint específico al que llaman, en lugar de asumir que las cifras mayores de la tarjeta del modelo están disponibles a través de esa API.
El Elo de generación muestra una ventaja, no una tasa de precisión
Google informa de dos comparaciones de texto a imagen evaluadas por humanos: preferencia general y diseño de infografías. En ambas, Nano Banana 2.1 con Thinking ocupa el primer lugar, seguido de Nano Banana 2.1 sin Thinking, Nano Banana 2 Thinking y Nano Banana Pro.
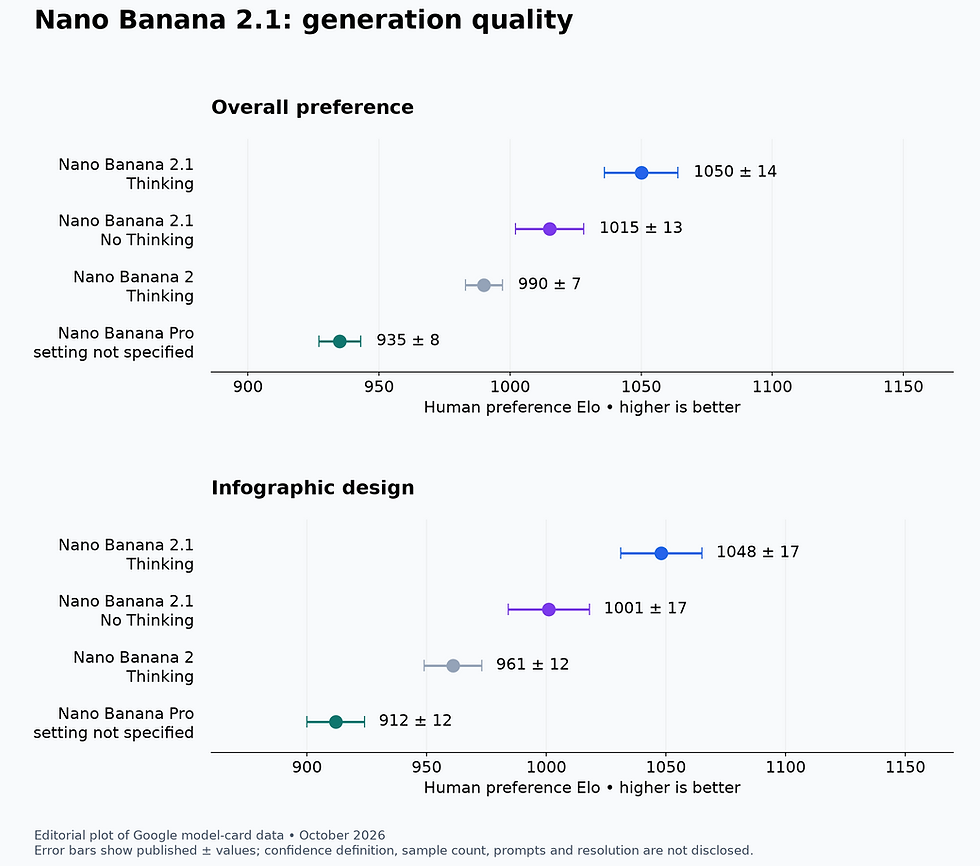
Gráfico editorial de datos numéricos publicados en la ficha del modelo Nano Banana 2.1 de Google DeepMind, octubre de 2026. Un Elo más alto indica una preferencia humana relativa más fuerte en las comparaciones de Google; las barras de error muestran los rangos ± publicados, cuya definición de confianza no se indica. No es una imagen original de Google, y Elo no equivale a precisión porcentual.
En preferencia general, Nano Banana 2.1 Thinking obtiene 1050 ±14, frente a 1015 ±13 sin Thinking, 990 ±7 para Nano Banana 2 Thinking y 935 ±8 para Pro. En diseño de infografías, los resultados correspondientes son 1048 ±17, 1001 ±17, 961 ±12 y 912 ±12.
El orden es coherente y varias brechas son mayores que los rangos mostrados. En particular, ambos modos de Nano Banana 2.1 se sitúan por encima de Nano Banana 2 en diseño de infografías incluso teniendo en cuenta sus intervalos publicados. Es evidencia significativa de una ventaja de preferencia dentro de esta evaluación. No demuestra que 2.1 vaya a ganar con todos los prompts, producir una infografía correcta o requerir menos reintentos en producción.
Thinking parece beneficioso en este caso. Su ventaja de 35 puntos en preferencia general sobre No Thinking presenta intervalos mostrados sin solapamiento: 1036–1064 frente a 1002–1028. Los intervalos de diseño de infografías coinciden en 1031, por lo que el gráfico respalda una ventaja, pero no un tamaño de efecto universal preciso. Google también etiqueta la configuración del benchmark únicamente como “Thinking”. No revela si la ejecución utilizó minimal, medium, high, una política adaptativa u otra configuración interna.
Esta omisión limita las conclusiones sobre costes y latencia. Una puntuación superior con Thinking no puede traducirse en “activar siempre high Thinking” sin medir cómo afecta cada ajuste disponible a un flujo de trabajo concreto. La tabla del benchmark no contiene mediciones de latencia, y este análisis no debe inventarlas.
La señal práctica es más limitada: los equipos cuyos usuarios valoran la composición, el acabado visual o la disposición de infografías deberían incluir Nano Banana 2.1 Thinking como un candidato serio. Los equipos que generen recursos decorativos de bajo riesgo podrían considerar suficiente No Thinking, pero esa decisión corresponde a una prueba controlada con sus propios prompts y umbrales de aceptación.
La consistencia mejora, pero el resultado con un solo personaje es ajustado
La consistencia suele ser más valiosa que el atractivo visual bruto en personajes recurrentes, variantes de campaña, storyboards, explicaciones de producto y edición en varios turnos. Google separa la consistencia de un solo personaje de la consistencia de varios personajes, y ambos resultados cuentan historias distintas.

Gráfico editorial de los datos de la ficha del modelo de Google DeepMind de octubre de 2026 sobre consistencia de uno y varios personajes. Un Elo más alto significa una preferencia humana relativa mayor; los rangos ± publicados se muestran sin una definición de confianza indicada. El casi solapamiento entre Nano Banana 2.1 Thinking y No Thinking para la consistencia de un solo personaje es importante. No es una imagen original de Google.
En consistencia de un solo personaje, Nano Banana 2.1 Thinking alcanza 1028 ±14 y No Thinking llega a 1021 ±14. Sus intervalos mostrados se solapan de forma considerable, de 1014 a 1035. Por tanto, no estaría justificado presentar la diferencia de siete puntos como una ventaja práctica consolidada. Ambas configuraciones de 2.1 superan a Nano Banana 2 Thinking con 981 ±10 y a Pro con 991 ±9, pero el benchmark no muestra si los fallos afectaron a rostros, ropa, proporciones corporales, accesorios o desviaciones de estilo.
El resultado con varios personajes está más diferenciado. Thinking obtiene 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10 y Nano Banana 2 Thinking 978 ±10. Los intervalos de 2.1 Thinking y No Thinking no se solapan. Esto sugiere que el razonamiento adicional puede ser más útil cuando una escena exige que el sistema siga varias identidades y sus relaciones.
Aun así, “admite hasta cuatro personajes” no equivale a “preserva cuatro identidades de forma fiable”. La documentación de API indica que la fusión de varias imágenes acepta hasta 14 imágenes de referencia, incluidos hasta cuatro personajes y diez objetos. Son límites de entrada, no garantías de fidelidad. No revelan cómo cambia el rendimiento cuando las referencias se vuelven visualmente similares, contradictorias, recortadas, de baja resolución o iluminadas de forma desigual.
Una evaluación de producción debería puntuar a cada sujeto por separado. Entre las etiquetas de fallo útiles se incluyen desviación facial, transferencia de vestuario, filtración de atributos entre personajes, sujetos ausentes, duplicación no deseada, cambios de edad y altura relativa inconsistente. Un único voto de preferencia general puede ocultar un defecto grave de identidad si el resto de la imagen resulta atractivo.
Para un flujo de trabajo de un solo personaje, el gráfico aporta poca evidencia de que Thinking sea necesario en cada solicitud. Para escenas con varias personas recurrentes, su mayor ventaja comunicada lo hace más prometedor, aunque sigue sujeto a costes, latencia y tasas de fallo de identidad medidos.
Los resultados de edición favorecen a 2.1, con riesgos distintos según la tarea
Los benchmarks de edición son especialmente relevantes porque una salida de aspecto plausible aún puede ser inutilizable si modifica regiones protegidas, pierde detalles del producto o combina referencias de forma incorrecta. Google informa de puntuaciones Elo para edición general, consistencia, edición basada en máscaras o tinta, consistencia de producto, estilización y edición con múltiples referencias.

Gráfico editorial de resultados numéricos verificados de la ficha del modelo Nano Banana 2.1 de Google DeepMind, octubre de 2026. Un Elo más alto indica una preferencia humana relativa más fuerte para la edición con máscara/tinta, la consistencia de producto y la edición con múltiples referencias; se muestran los rangos ± publicados, sin una definición de confianza indicada. No es una imagen original de Google y no mide el cumplimiento exacto de las ediciones.
La edición basada en máscaras o tinta es el ejemplo más claro de una ventaja compartida de 2.1 sin una ventaja demostrada de Thinking. Thinking obtiene 1049 ±15 y No Thinking 1042 ±16; sus intervalos se solapan ampliamente. Ambos superan a Nano Banana 2 Thinking con 965 ±12 y a Pro con 927 ±12. Si la edición con máscaras domina una carga de trabajo, No Thinking puede merecer la misma atención durante las pruebas en lugar de tratarse como un modo intrínsecamente inferior.
Sin embargo, las propias limitaciones de Google matizan el resultado. El modelo puede seguir las instrucciones de edición enmascarada solo parcialmente, conservar marcas de garabatos o tinta, o mantener la pose del sujeto de origen. El Elo de preferencia no puede establecer que los píxeles fuera del área permitida hayan permanecido sin cambios. Para flujos de trabajo de catálogo y regulados, es esencial una métrica independiente de preservación.
La consistencia de producto muestra una comparación menos concluyente entre 2.1 No Thinking y los modelos anteriores. Las puntuaciones son 1024 ±18 con Thinking, 981 ±18 sin él, 955 ±22 para Nano Banana 2 Thinking y 965 ±14 para Pro. El intervalo de No Thinking se solapa con los de ambos modelos anteriores. Por tanto, el gráfico publicado respalda a Thinking como la configuración más sólida en esta evaluación, pero no permite afirmar que todas las configuraciones de 2.1 mejoren claramente la fidelidad del producto.
La edición con múltiples referencias cuenta una historia más sólida para 2.1: 1066 ±22 con Thinking y 1041 ±20 sin él, frente a 988 ±13 para Nano Banana 2 Thinking y 989 ±12 para Pro. Sin embargo, los dos intervalos de 2.1 se superponen, por lo que no debe exagerarse la diferencia de 25 puntos entre sus puntuaciones centrales.
Estas tareas también requieren reglas de aceptación distintas. Un compuesto creativo puede tolerar pequeños cambios de geometría, mientras que una imagen de comercio electrónico puede fallar si cambia un logotipo, puerto, botón, material o cantidad del paquete. Por tanto, las decisiones de migración deben tomarse por clase de edición, no a partir de una conclusión general de que “la edición es mejor”.
La factualidad es prometedora, pero sigue siendo la afirmación más débil
Google informa puntuaciones de factualidad de infografías de 0.521 para Nano Banana 2.1 Thinking, 0.328 sin Thinking, 0.265 para Nano Banana Pro y 0.179 para Nano Banana 2 Thinking.

Gráfico editorial de datos de factualidad de AutoRater de octubre de 2026 procedentes de la tarjeta de modelo de Nano Banana 2.1 de Google DeepMind. Un valor más alto es mejor, pero esta puntuación automatizada unilateral no equivale a un porcentaje de precisión humana. Google no publica rangos de incertidumbre aquí. Esta no es una imagen original de Google.
El resultado respalda una conclusión limitada: según la evaluación automatizada de Google, Thinking mejora sustancialmente la puntuación de factualidad de Nano Banana 2.1, y la puntuación resultante supera las de los comparadores enumerados. No significa que el 52.1% de las infografías sea factualmente correcto. La tarjeta del modelo no define la puntuación como un porcentaje, no publica su incertidumbre, no revela el número de prompts ni proporciona aquí suficiente detalle para calcular tasas de error.
La distinción importa porque los gráficos factuales presentan múltiples superficies de fallo. Un gráfico puede contener texto correcto pero representar valores erróneos. Puede citar una fuente real mientras desajusta las fechas. Un mapa puede intercambiar regiones; una cronología puede invertir acontecimientos; una etiqueta puede asignarse al objeto equivocado. La puntuación automatizada puede detectar algunos de estos errores, pero la tabla no revela su cobertura con suficiente detalle como para tratarla como una puerta de control de publicación.
La fundamentación mediante búsqueda puede aportar información más reciente, pero la recuperación no garantiza una transcripción visual fiel. La tarjeta del modelo también describe una fecha de corte de conocimiento de marzo de 2026 para Gemini 3.6 Flash, con algunos dominios potencialmente limitados a enero de 2025 y otros que reciben información más reciente. Para gráficos sensibles al tiempo, el material fuente debe suministrarse o recuperarse explícitamente y luego verificarse frente a la imagen renderizada.
Un flujo de trabajo defendible separa la verdad de la fuente de la presentación. Mantenga una hoja de datos aprobada con valores, unidades, fechas, etiquetas y citas; genere el elemento visual a partir de ese encargo; y después compare cada afirmación renderizada con los hechos aprobados. Aquí es también donde mantener hechos y encargos de fuentes trazables para contenido visual ayuda a que la revisión se base en la evidencia subyacente, en lugar de en la aparente seguridad de la imagen.
El benchmark convierte a Thinking en el candidato obvio para factualidad, no en un sistema de publicación autónomo. La verificación humana o determinista sigue siendo necesaria para gráficos médicos, financieros, legales, históricos, científicos y de actualidad.
La salida es más barata en todas las resoluciones, pero las solicitudes podrían no serlo
Con las tarifas Standard de API de pago, Google indica que la salida de imágenes de Nano Banana 2.1 cuesta $30 por millón de tokens de imagen de salida. Nano Banana 2 cuesta $60 por millón. Ese titular parece una reducción universal del 50%, pero las distintas asignaciones de tokens en 4K y las tarifas no relacionadas con imágenes más altas complican el total.

Cálculo editorial a partir de los precios de Gemini API de Google, octubre de 2026. Un menor coste solo de salida de imagen es mejor: Nano Banana 2.1 es un 50% más barato en 1K y 2K, y un 25% más barato en 4K. Los costes excluyen entrada, salida de texto o Thinking, grounding, reintentos, impuestos y posibles descuentos Batch. Esta no es una imagen original de Google.
El cálculo transparente es tarifa multiplicada por tokens de imagen de salida:
En 1K, 1,120 tokens de imagen cuestan $0.0336 para Nano Banana 2.1 y $0.0672 para Nano Banana 2. En 2K, 1,680 tokens cuestan $0.0504 y $0.1008 respectivamente. En 4K, los modelos utilizan distintas asignaciones de tokens: 3,780 × $30 por millón da $0.1134 para 2.1, mientras que 2,520 × $60 por millón da $0.1512 para Nano Banana 2.
Por tanto, “a mitad de precio” solo es exacto para tokens de salida de imagen en 1K y 2K. En 4K, Nano Banana 2.1 utiliza más tokens de imagen indicados, lo que reduce el ahorro exclusivo de salida al 25%.
Otros componentes pueden moverse en sentido contrario. El precio Standard de entrada para Nano Banana 2.1 es de $1.50 por millón de tokens de texto, imagen o vídeo, frente a $0.50 por millón de tokens de texto o imagen para Nano Banana 2. La salida de texto y Thinking cuesta $7.50 por millón de tokens para 2.1, frente a $3 para Nano Banana 2. Por tanto, una estimación completa debe incluir los tokens de entrada reales, la salida textual, el consumo de Thinking, los cargos de grounding cuando corresponda, los reintentos, los impuestos y cualquier descuento Batch.
No se puede calcular de forma responsable un total de “solicitud típica” sin asumir la longitud del prompt, la tokenización de imágenes de referencia, el uso de Thinking, la resolución y la tasa de reintentos. Una imagen aceptada más barata puede provenir de una solicitud más cara, mientras que una mejor aceptación en el primer intento puede compensar mayores cargos de razonamiento. Mida el coste por activo aceptado, no solo el precio por imagen generada.
Un plan de evaluación sugerido para la migración
Lo siguiente es un diseño de prueba propuesto, no una descripción de pruebas realizadas para este artículo.
Comience con un conjunto estratificado de prompts extraído de trabajo real. Separe texto a imagen, un solo personaje, múltiples personajes, edición de productos, edición con máscara, composición con múltiples referencias, diseños con mucho texto y gráficos factuales. Conserve prompts, archivos de referencia, relaciones de aspecto, resoluciones y configuraciones de seguridad para que cada modelo reciba la misma tarea.
Compare Nano Banana 2.1 con Thinking mínimo, medio y alto con Nano Banana 2 Thinking. Incluya Pro solo si es una opción de despliegue real; dado que el gráfico de benchmark no especifica la configuración de Pro, no suponga que su configuración de cómputo o razonamiento coincide con la de los demás. Asigne a cada condición el mismo presupuesto de reintentos en la prueba interna, aunque Google no revele si lo hizo en su benchmark.
Defina las reglas de aceptación antes de examinar los resultados:
Para la renderización de texto, transcriba cada palabra obligatoria y registre texto ausente, sustituido, borroso o malformado.
Para la identidad, puntúe cada personaje de forma independiente y registre filtración de atributos, duplicación, omisión y desviación de rostro o vestuario.
Para el trabajo de producto, compare características protegidas como forma, logotipo, controles, cantidad, color, material y texto del paquete.
Para las ediciones con máscara, mida tanto el éxito en la región solicitada como los cambios no intencionados fuera de la máscara.
Para prompts espaciales, pruebe izquierda/derecha, primer plano/fondo, contención, orden y tamaño relativo.
Para gráficos factuales, verifique cada número, unidad, fecha, etiqueta, cita y codificación visual frente a una hoja de fuentes bloqueada.
Para operaciones, registre tiempos de espera agotados, latencia de extremo a extremo, número de reintentos, uso de tokens, cargos de grounding y coste por resultado aceptado.
Use revisión humana ciega para la calidad subjetiva y comprobaciones deterministas siempre que sea posible la exactitud. Informe la incertidumbre y conserve los resultados emparejados, ya que el mismo prompt ejecutado entre modelos es más informativo que promedios no relacionados. No reduzca todas las tareas a una sola puntuación si los fallos tienen consecuencias empresariales diferentes.
Pruebe el comportamiento del endpoint además de la calidad de imagen. Confirme los límites de 131,072 de entrada y 32,768 de salida frente a la documentación actual de la API, verifique la resolución predeterminada de 1K y pruebe explícitamente 2K y 4K. Pruebe entradas de 14 referencias solo si son necesarias, recordando que los límites de cuatro personajes y diez objetos no prometen preservación. Como function calling, ejecución de código y salidas estructuradas no son compatibles, la orquestación y la validación deben realizarse fuera del modelo.
Por último, ejecute una fase de sombra antes de cambiar el tráfico de producción. Capture los motivos de rechazo y compare el coste por activo aceptado. Esto revela si las ganancias del benchmark se traducen en menos revisiones, en lugar de simplemente mejores primeras impresiones.
Quién debería migrar y quién debería esperar
Nano Banana 2.1 es el candidato más fuerte cuando un flujo de trabajo depende del diseño de infografías, escenas con múltiples personajes, composición con múltiples referencias, ediciones basadas en máscara o menores cargos de salida de imagen. Thinking merece prioridad para gráficos factuales y tareas complejas con múltiples sujetos. Sin Thinking sigue valiendo la pena probarlo para generación y edición más simples, especialmente cuando su intervalo publicado se superpone con Thinking o cuando importa el coste de razonamiento.
La migración debería esperar cuando el texto pequeño exacto, los pasajes largos, la preservación estricta de identidad, la edición de regiones protegidas, la precisión espacial o los hechos verificados sean innegociables y la organización carezca de un paso de validación externo. Lo mismo aplica cuando la automatización existente depende de function calling, ejecución de código o salida estructurada no compatibles.
Las discrepancias en la documentación deben tratarse de forma conservadora: siga los límites actuales del endpoint elegido y mida el comportamiento observado, en lugar de inferir capacidad a partir de la arquitectura más amplia del modelo. Del mismo modo, la actual tabla de deprecaciones enumera Gemini 3.1 Flash Image como obsoleto, pero no anuncia fecha de cierre. No existe una fecha límite de retirada verificada para el 29 de octubre que obligue a una transición apresurada.
Por tanto, la decisión es concreta. Migre si Nano Banana 2.1 supera los umbrales de fidelidad específicos de cada tarea, reduce el coste por imagen aceptada y cumple los requisitos medidos de latencia y tiempos de espera. Use Thinking solo cuando su mejora en la tasa de aceptación justifique su coste adicional de salida. Mantenga Nano Banana 2 u otra alternativa hasta que 2.1 supere las pruebas de sombra. Y para activos factuales, sensibles a la identidad o editados con precisión, exija validación independientemente de qué modelo lidere el benchmark.


