Nano Banana 2.1 : ce que révèlent les benchmarks d’images de Google


Google a publié Nano Banana 2.1 le 6 octobre 2026. Cette analyse, datée du 14 octobre, le considère comme la suite de cette publication — et non comme un nouveau lancement aujourd’hui.
Les résultats publiés étayent de manière crédible l’idée que Nano Banana 2.1 améliore Nano Banana 2 dans plusieurs tâches de génération et d’édition d’images. Les plus grands avantages signalés concernent la conception d’infographies, la cohérence entre plusieurs personnages, l’édition fondée sur les masques et le travail à partir de références multiples. L’activation de Thinking produit généralement les meilleurs scores, bien que son intérêt varie selon la tâche.
Ces conclusions doivent être soigneusement circonscrites. La plupart des scores sont des évaluations Elo fondées sur les préférences, et non des pourcentages d’images correctes. Google fournit des marges d’erreur pour les résultats Elo, mais n’en définit pas le niveau de confiance. L’entreprise ne divulgue pas le nombre d’échantillons, les prompts de benchmark, les résolutions d’images, les budgets de tentatives, les paramètres détaillés de Thinking ni les conditions de calcul équivalentes dans le tableau de la fiche du modèle. Le résultat sur la factualité provient d’un évaluateur automatisé plutôt que d’une mesure de précision humaine.
Par conséquent, les benchmarks constituent des éléments utiles sur les performances relatives dans l’évaluation menée par Google, mais ils n’établissent ni la fiabilité en production, ni la latence, ni le retour sur investissement. Les équipes envisageant une migration doivent encore effectuer des tests propres à leurs charges de travail, avec des entrées contrôlées, des critères d’échec et les coûts complets par requête.
Ce que Google a réellement publié le 6 octobre
Nano Banana 2.1 est le modèle actualisé de Google, de classe Flash, pour la génération d’images et l’édition conversationnelle. Le code stable du modèle dans l’API Gemini est gemini-nano-banana-2.1. Google le présente comme une mise à jour de Gemini 3.1 Flash Image, également appelé Nano Banana 2, et comme une alternative plus efficace à Gemini 3 Pro Image, couramment appelé Nano Banana Pro. Le journal des modifications de l’API Gemini consigne sa disponibilité générale le 6 octobre 2026.
Selon la fiche de modèle Nano Banana 2.1, le modèle repose sur Gemini 3.6 Flash et accepte du texte et des images, tout en renvoyant des images et du texte. Google le positionne pour la création d’images contrôlée, l’édition, les visuels riches en texte, le rendu localisé et les flux de travail itératifs. Son évaluation combine des jugements humains de préférence côte à côte pour la génération et l’édition, avec une seule évaluation automatisée de la factualité.
La fiche identifie également des limites concrètes : les textes petits ou longs peuvent devenir flous ou se dégrader ; l’identité peut dériver ; les modifications masquées peuvent conserver des traces d’encre ou ne suivre que partiellement les instructions ; les poses peuvent persister de manière inattendue ; les relations spatiales telles que gauche et droite peuvent être confondues ; et les connaissances sur le monde, le raisonnement 3D et la factualité restent imparfaits. Des lenteurs et des délais d’expiration occasionnels sont également reconnus. Il s’agit de risques opérationnels, et non de notes de bas de page : chacun nécessite un test d’acceptation et une politique de repli avant le déploiement.
La documentation du modèle pour l’API de Google ajoute des détails d’implémentation. La sortie est définie par défaut sur 1K et peut être demandée jusqu’à 4K. Thinking propose minimal, medium — la valeur par défaut — et high. Le modèle prend en charge le grounding par recherche, mais pas l’appel de fonctions, l’exécution de code ni les sorties structurées.
La fiche du modèle indique un contexte allant jusqu’à un million de jetons et une sortie de texte allant jusqu’à 64K, tandis que la page de l’API Gemini déployée indique 131,072 jetons d’entrée et 32,768 jetons de sortie. Les documents publics n’expliquent pas la relation entre ces différentes limites. Les déployeurs doivent suivre les limites documentées du point de terminaison spécifique qu’ils appellent, plutôt que de supposer que les chiffres plus élevés de la fiche du modèle sont disponibles via cette API.
L’Elo de génération indique une avance, pas un taux de précision
Google rapporte deux comparaisons texte-vers-image évaluées par des humains : la préférence globale et la conception d’infographies. Dans les deux cas, Nano Banana 2.1 avec Thinking se classe premier, suivi de Nano Banana 2.1 sans Thinking, de Nano Banana 2 Thinking et de Nano Banana Pro.
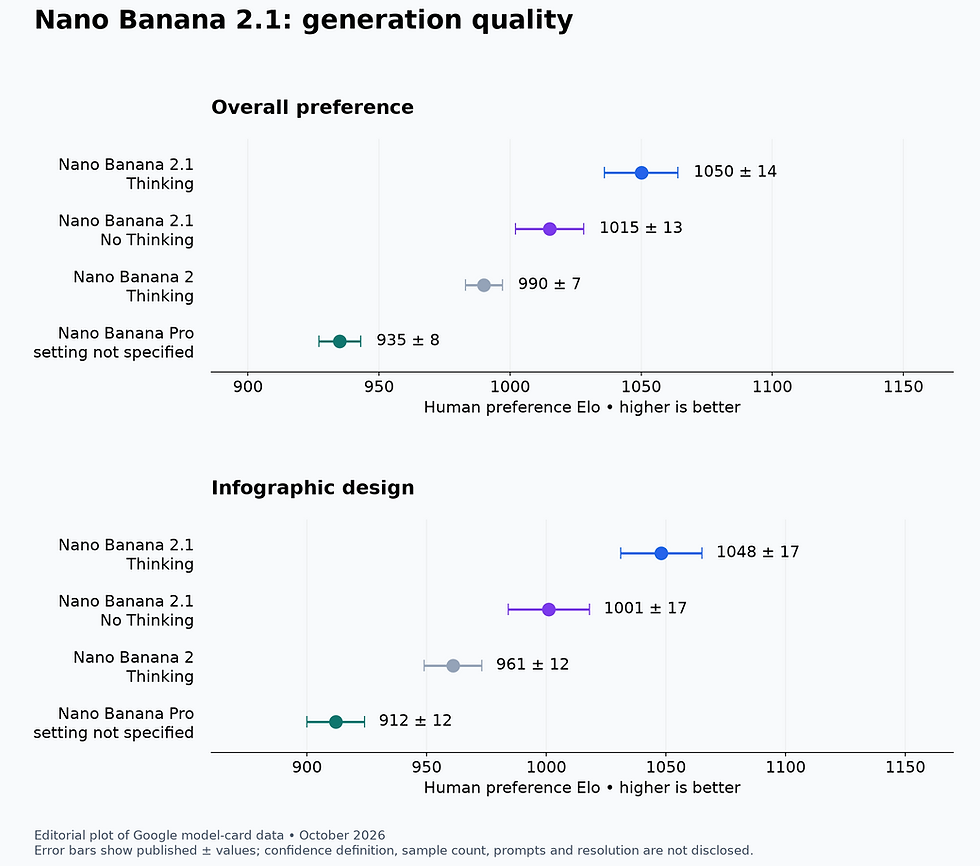
Graphique éditorial de données numériques publiées dans la fiche de modèle Nano Banana 2.1 de Google DeepMind, octobre 2026. Un Elo plus élevé indique une préférence humaine relative plus forte dans les comparaisons de Google ; les barres d’erreur montrent les marges ± publiées, dont la définition du niveau de confiance n’est pas précisée. Il ne s’agit pas d’une image originale de Google, et l’Elo n’est pas une précision en pourcentage.
Pour la préférence globale, Nano Banana 2.1 Thinking obtient 1050 ±14, contre 1015 ±13 sans Thinking, 990 ±7 pour Nano Banana 2 Thinking et 935 ±8 pour Pro. Pour la conception d’infographies, les résultats correspondants sont 1048 ±17, 1001 ±17, 961 ±12 et 912 ±12.
L’ordre est cohérent, et plusieurs écarts dépassent les plages affichées. En particulier, les deux modes de Nano Banana 2.1 se situent au-dessus de Nano Banana 2 en conception d’infographies, même en tenant compte de leurs intervalles publiés. Il s’agit d’un indice significatif d’un avantage de préférence dans cette évaluation. Cela ne prouve pas que 2.1 remportera chaque prompt, produira une infographie correcte ou nécessitera moins de tentatives en production.
Thinking semble bénéfique ici. Son avance de 35 points en préférence globale sur No Thinking présente des intervalles affichés qui ne se chevauchent pas : 1036–1064 contre 1002–1028. Les intervalles de conception d’infographies se touchent à 1031 ; le graphique étaye donc un avantage, mais pas une taille d’effet universelle précise. Google étiquette également la configuration de benchmark simplement comme « Thinking ». L’entreprise ne révèle pas si l’exécution utilisait minimal, medium, high, une politique adaptative ou un autre paramètre interne.
Cette omission limite les conclusions sur les coûts et la latence. Un score Thinking plus élevé ne peut pas être traduit par « activez toujours Thinking au niveau high » sans mesurer l’effet de chaque paramètre disponible sur un flux de travail donné. Le tableau de benchmark ne contient aucune mesure de latence, et cette analyse ne doit pas en inventer.
Le signal pratique est plus circonscrit : les équipes dont les utilisateurs jugent la composition, le rendu visuel ou la mise en page d’infographies devraient considérer Nano Banana 2.1 Thinking comme un candidat sérieux. Les équipes générant des ressources décoratives à faible risque peuvent juger No Thinking suffisant, mais cette décision relève d’un test contrôlé fondé sur leurs propres prompts et seuils d’acceptation.
La cohérence s’améliore, mais le résultat à un seul personnage est serré
La cohérence est souvent plus précieuse que l’attrait visuel brut pour les personnages récurrents, les déclinaisons de campagne, les storyboards, les présentations de produits et l’édition en plusieurs tours. Google distingue la cohérence d’un seul personnage de celle de plusieurs personnages, et ces deux résultats racontent des histoires différentes.

Graphique éditorial des données de la fiche de modèle d’octobre 2026 de Google DeepMind](https://deepmind.google/models/model-cards/nano-banana-2-1/) sur la cohérence à un personnage et à plusieurs personnages. Un Elo plus élevé signifie une préférence humaine relative plus forte ; les marges ± publiées sont affichées sans définition précisée du niveau de confiance. Le chevauchement presque total entre Nano Banana 2.1 Thinking et No Thinking pour la cohérence à un personnage est important. Il ne s’agit pas d’une image originale de Google.
Pour la cohérence à un personnage, Nano Banana 2.1 Thinking atteint 1028 ±14 et No Thinking atteint 1021 ±14. Leurs intervalles affichés se chevauchent largement, de 1014 à 1035. Il serait donc injustifié de présenter l’écart de sept points comme un avantage pratique établi. Les deux configurations 2.1 obtiennent de meilleurs scores que Nano Banana 2 Thinking à 981 ±10 et Pro à 991 ±9, mais le benchmark ne montre pas si les échecs concernaient les visages, les vêtements, les proportions corporelles, les accessoires ou la dérive stylistique.
Le résultat à plusieurs personnages est plus différencié. Thinking obtient 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10 et Nano Banana 2 Thinking 978 ±10. Les intervalles de 2.1 Thinking et No Thinking ne se chevauchent pas. Cela suggère qu’un raisonnement supplémentaire peut être plus utile lorsqu’une scène impose au système de suivre plusieurs identités et leurs relations.
Toutefois, « prend en charge jusqu’à quatre personnages » ne signifie pas « préserve de manière fiable quatre identités ». La documentation de l’API indique que la fusion de plusieurs images accepte jusqu’à 14 images de référence, dont jusqu’à quatre personnages et dix objets. Il s’agit de limites d’entrée, et non de garanties de fidélité. Elles ne révèlent pas comment les performances évoluent lorsque les références deviennent visuellement similaires, contradictoires, recadrées, de faible résolution ou inégalement éclairées.
Une évaluation en production devrait noter chaque sujet séparément. Parmi les libellés d’échec utiles figurent la dérive du visage, le transfert de tenue, la fuite d’attributs entre personnages, les sujets manquants, la duplication involontaire, le changement d’âge et l’incohérence de hauteur relative. Un unique vote de préférence globale peut masquer un grave défaut d’identité si le reste de l’image est attrayant.
Pour un flux de travail à un personnage, le graphique apporte peu d’éléments indiquant que Thinking est nécessaire à chaque requête. Pour les scènes comprenant plusieurs personnes récurrentes, son avance signalée plus importante le rend plus prometteur — mais toujours sous réserve de mesurer les coûts, la latence et les taux d’échec d’identité.
Les résultats d’édition favorisent 2.1, avec des risques différents selon la tâche
Les benchmarks d’édition sont particulièrement pertinents, car une sortie visuellement plausible peut rester inutilisable si elle modifie des régions protégées, perd des détails de produit ou mélange incorrectement les références. Google rapporte des scores Elo pour l’édition générale, la cohérence, l’édition par masque ou encre, la cohérence produit, la stylisation et l’édition à références multiples.

Graphique éditorial de résultats numériques vérifiés issus de la fiche de modèle Nano Banana 2.1 de Google DeepMind, octobre 2026. Un Elo plus élevé indique une préférence humaine relative plus forte pour l’édition par masque/encre, la cohérence produit et l’édition à références multiples ; les marges ± publiées sont affichées, sans définition précisée du niveau de confiance. Il ne s’agit pas d’une image originale de Google et cela ne mesure pas la conformité exacte des modifications.
L’édition par masque ou encre est l’exemple le plus clair d’un avantage partagé de 2.1, sans avantage démontré de Thinking. Thinking obtient 1049 ±15 et No Thinking 1042 ±16 ; leurs intervalles se chevauchent fortement. Les deux devancent Nano Banana 2 Thinking à 965 ±12 et Pro à 927 ±12. Si l’édition par masque domine une charge de travail, No Thinking mérite peut-être une attention égale lors des tests plutôt que d’être traité comme un mode intrinsèquement inférieur.
Cependant, les propres limites de Google nuancent ce résultat. Le modèle peut ne suivre que partiellement les instructions d’édition masquée, préserver des marques de gribouillage ou d’encre, ou conserver la pose du sujet source. L’Elo de préférence ne peut pas établir que les pixels situés en dehors de la zone autorisée sont restés inchangés. Pour les flux de travail de catalogue et réglementés, une métrique distincte de préservation est indispensable.
La cohérence produit montre une comparaison moins décisive entre 2.1 No Thinking et les modèles plus anciens. Les scores sont de 1024 ±18 avec Thinking, 981 ±18 sans lui, 955 ±22 pour Nano Banana 2 Thinking et 965 ±14 pour Pro. L’intervalle de No Thinking chevauche ceux des deux modèles plus anciens. Le graphique publié étaye donc Thinking comme la configuration la plus performante dans cette évaluation, mais il ne permet pas d’affirmer que chaque configuration 2.1 améliore clairement la fidélité des produits.
L’édition multi-référence raconte une histoire plus convaincante pour 2.1 : 1066 ±22 avec Thinking et 1041 ±20 sans, contre 988 ±13 pour Nano Banana 2 Thinking et 989 ±12 pour Pro. Pourtant, les deux intervalles de 2.1 se chevauchent ; l’écart de 25 points entre leurs scores centraux ne doit donc pas être exagéré.
Ces tâches nécessitent également des règles d’acceptation différentes. Un composite créatif peut tolérer de légères modifications géométriques, tandis qu’une image de commerce électronique peut échouer si un logo, un port, un bouton, un matériau ou une quantité dans l’emballage change. Les décisions de migration doivent donc être prises par catégorie d’édition, et non à partir de la conclusion globale selon laquelle « l’édition est meilleure ».
La factualité est prometteuse, mais reste l’affirmation la plus fragile
Google rapporte des scores de factualité d’infographies de 0.521 pour Nano Banana 2.1 Thinking, 0.328 sans Thinking, 0.265 pour Nano Banana Pro et 0.179 pour Nano Banana 2 Thinking.

Graphique éditorial des données de factualité AutoRater d’octobre 2026 issues de la fiche modèle Nano Banana 2.1 de Google DeepMind. Un score plus élevé est préférable, mais ce score unilatéral attribué par un évaluateur automatisé n’est pas un pourcentage d’exactitude humaine. Google ne publie ici aucune plage d’incertitude. Il ne s’agit pas d’une image Google originale.
Le résultat permet une conclusion limitée : selon l’évaluation automatisée de Google, Thinking améliore sensiblement le score de factualité de Nano Banana 2.1, et le score obtenu dépasse ceux des comparateurs indiqués. Cela ne signifie pas que 52.1 % des infographies sont factuellement correctes. La fiche modèle ne définit pas ce score comme un pourcentage, ne publie pas son incertitude, ne révèle pas le nombre de prompts et ne fournit pas ici suffisamment de détails pour calculer des taux d’erreur.
Cette distinction est importante car les graphiques factuels présentent de multiples sources d’échec. Un graphique peut contenir un texte correct tout en traçant de mauvaises valeurs. Il peut citer une source réelle tout en associant des dates erronées. Une carte peut intervertir des régions ; une chronologie peut inverser des événements ; une étiquette peut être attribuée au mauvais objet. La notation automatisée peut détecter certaines de ces erreurs, mais le tableau ne révèle pas sa couverture avec suffisamment de précision pour le considérer comme un critère de publication.
L’ancrage par recherche peut fournir des informations plus récentes, mais la récupération ne garantit pas une transcription visuelle fidèle. La fiche modèle indique également une date limite de connaissances fixée à mars 2026 pour Gemini 3.6 Flash, certains domaines pouvant être limités à janvier 2025 et d’autres bénéficiant d’informations plus récentes. Pour les graphiques sensibles au temps, le matériel source doit être explicitement fourni ou récupéré, puis vérifié par rapport à l’image rendue.
Un flux de travail défendable sépare la véracité des sources de la présentation. Maintenez une fiche de faits approuvée contenant les valeurs, unités, dates, libellés et citations ; générez le visuel à partir de ce brief ; puis comparez chaque affirmation rendue aux faits approuvés. C’est également là que la conservation de faits sources et de briefs traçables pour le contenu visuel aide à ancrer la révision dans les preuves sous-jacentes plutôt que dans l’apparente assurance de l’image.
Le benchmark fait de Thinking le candidat évident pour la factualité, mais pas un système de publication autonome. Une vérification humaine ou déterministe reste nécessaire pour les graphiques médicaux, financiers, juridiques, historiques, scientifiques et d’actualité.
La sortie est moins chère à toutes les résolutions, mais les requêtes ne le sont pas forcément
Aux tarifs API payants Standard, Google indique un coût de sortie d’image Nano Banana 2.1 de 30 $ par million de tokens d’image de sortie. Nano Banana 2 coûte 60 $ par million. Ce titre suggère une réduction universelle de 50 %, mais les allocations de tokens différentes en 4K ainsi que les tarifs plus élevés pour les composants non liés à l’image compliquent le coût total.

Calcul éditorial à partir de la tarification de l’API Gemini, octobre 2026. Un coût de sortie d’image uniquement plus faible est préférable : Nano Banana 2.1 est inférieur de 50 % en 1K et 2K, et de 25 % en 4K. Les coûts excluent les entrées, les sorties textuelles ou Thinking, l’ancrage, les nouvelles tentatives, les taxes et d’éventuelles remises Batch. Il ne s’agit pas d’une image Google originale.
Le calcul transparent correspond au tarif multiplié par les tokens d’image de sortie :
En 1K, 1,120 tokens d’image coûtent 0.0336 $ pour Nano Banana 2.1 et 0.0672 $ pour Nano Banana 2. En 2K, 1,680 tokens coûtent respectivement 0.0504 $ et 0.1008 $. En 4K, les modèles utilisent des allocations de tokens différentes : 3,780 × 30 $ par million donnent 0.1134 $ pour 2.1, tandis que 2,520 × 60 $ par million donnent 0.1512 $ pour Nano Banana 2.
Ainsi, « moitié prix » n’est exact que pour les tokens de sortie d’image en 1K et 2K. En 4K, Nano Banana 2.1 utilise davantage de tokens d’image répertoriés, ce qui ramène l’économie sur la sortie seule à 25 %.
D’autres composantes peuvent évoluer dans le sens opposé. Le tarif Standard des entrées pour Nano Banana 2.1 est de 1.50 $ par million de tokens de texte, d’image ou de vidéo, contre 0.50 $ par million de tokens de texte ou d’image pour Nano Banana 2. La sortie de texte et Thinking coûte 7.50 $ par million de tokens pour 2.1, contre 3 $ pour Nano Banana 2. Une estimation complète doit donc inclure les tokens d’entrée réellement utilisés, les sorties textuelles, la consommation de Thinking, les frais d’ancrage le cas échéant, les nouvelles tentatives, les taxes et toute remise Batch.
Aucun total de « requête typique » ne peut être calculé de manière responsable sans supposer la longueur du prompt, la tokenisation des images de référence, l’utilisation de Thinking, la résolution et le taux de nouvelles tentatives. Une image réussie moins chère peut tout de même provenir d’une requête plus coûteuse, tandis qu’un meilleur taux d’acceptation dès le premier essai peut compenser des frais de raisonnement plus élevés. Mesurez le coût par ressource acceptée, et non seulement le prix par image générée.
Un plan d’évaluation suggéré pour la migration
Ce qui suit est une proposition de protocole de test, et non une description des tests réalisés pour cet article.
Commencez par un ensemble de prompts stratifié issu du travail réel. Séparez la génération texte-vers-image, les personnages uniques, les scènes à plusieurs personnages, l’édition de produits, l’édition masquée, la composition multi-référence, les mises en page riches en texte et les graphiques factuels. Conservez les prompts, fichiers de référence, rapports d’aspect, résolutions et paramètres de sécurité afin que chaque modèle reçoive la même tâche.
Comparez Nano Banana 2.1 avec Thinking minimal, moyen et élevé à Nano Banana 2 Thinking. Incluez Pro uniquement s’il constitue une véritable option de déploiement ; comme le graphique de benchmark ne précise pas le réglage de Pro, ne supposez pas que sa configuration de calcul ou de raisonnement correspond à celle des autres. Accordez à chaque condition le même budget de nouvelles tentatives dans le test interne, même si Google ne précise pas si son benchmark l’a fait.
Définissez les règles d’acceptation avant d’examiner les sorties :
Pour le rendu de texte, transcrivez chaque mot requis et consignez les textes manquants, substitués, flous ou mal formés.
Pour l’identité, évaluez chaque personnage indépendamment et consignez les fuites d’attributs, duplications, omissions et dérives du visage ou de la tenue.
Pour le travail sur les produits, comparez les caractéristiques protégées telles que la forme, le logo, les commandes, le nombre, la couleur, le matériau et le texte de l’emballage.
Pour les modifications masquées, mesurez à la fois la réussite dans la zone demandée et les changements non intentionnels hors du masque.
Pour les prompts spatiaux, testez gauche/droite, premier plan/arrière-plan, inclusion, ordre et taille relative.
Pour les graphiques factuels, vérifiez chaque nombre, unité, date, libellé, citation et encodage visuel par rapport à une fiche source verrouillée.
Pour les opérations, consignez les délais d’expiration, la latence de bout en bout, le nombre de nouvelles tentatives, l’utilisation des tokens, les frais d’ancrage et le coût par résultat accepté.
Utilisez une évaluation humaine en aveugle pour la qualité subjective et des contrôles déterministes partout où l’exactitude est possible. Signalez l’incertitude et conservez les résultats appariés, car l’exécution du même prompt sur plusieurs modèles est plus informative que des moyennes non liées. Ne réduisez pas toutes les tâches à un score unique si les échecs ont des conséquences commerciales différentes.
Testez le comportement des endpoints ainsi que la qualité des images. Confirmez les limites actuelles de 131,072 tokens d’entrée et 32,768 tokens de sortie dans la documentation API, vérifiez la résolution 1K par défaut et exercez explicitement 2K et 4K. Testez les entrées à 14 références uniquement si nécessaire, en gardant à l’esprit que les limites de quatre personnages et de dix objets ne garantissent pas leur préservation. Comme l’appel de fonctions, l’exécution de code et les sorties structurées ne sont pas pris en charge, l’orchestration et la validation doivent avoir lieu en dehors du modèle.
Enfin, exécutez une phase fantôme avant de basculer le trafic de production. Capturez les motifs de rejet et comparez le coût par ressource acceptée. Cela révèle si les gains de benchmark se traduisent par moins de révisions, plutôt que par de simples premières impressions plus flatteuses.
Qui devrait migrer — et qui devrait attendre
Nano Banana 2.1 est le candidat le plus solide lorsqu’un flux de travail dépend de la conception d’infographies, de scènes à plusieurs personnages, de composition multi-référence, de modifications basées sur des masques ou de frais de sortie d’image réduits. Thinking mérite la priorité pour les graphiques factuels et les tâches complexes à plusieurs sujets. L’absence de Thinking mérite encore d’être testée pour la génération et l’édition plus simples, notamment lorsque son intervalle publié chevauche celui de Thinking ou lorsque le coût du raisonnement importe.
La migration devrait attendre lorsque le petit texte exact, les longs passages, la préservation stricte de l’identité, l’édition de zones protégées, la précision spatiale ou les faits vérifiés ne sont pas négociables et que l’organisation ne dispose pas d’une étape de validation externe. Il en va de même lorsque l’automatisation existante dépend de l’appel de fonctions, de l’exécution de code ou de sorties structurées non prises en charge.
Les divergences dans la documentation doivent être traitées avec prudence : suivez les limites actuelles de l’endpoint choisi et mesurez le comportement observé plutôt que de déduire la capacité à partir de l’architecture plus large du modèle. De même, l’actuel tableau des dépréciations répertorie Gemini 3.1 Flash Image comme obsolète, mais n’annonce aucune date d’arrêt. Il n’existe aucune échéance de retrait vérifiée au 29 octobre qui justifierait un basculement précipité.
La décision est donc concrète. Migrez si Nano Banana 2.1 franchit les seuils de fidélité spécifiques aux tâches, réduit le coût par image acceptée et respecte les exigences mesurées de latence et de délai d’expiration. Utilisez Thinking uniquement lorsque son gain de taux d’acceptation justifie son coût de sortie supplémentaire. Conservez Nano Banana 2 ou une autre solution de repli jusqu’à ce que 2.1 réussisse les tests fantômes. Et pour les ressources factuelles, sensibles à l’identité ou modifiées avec précision, exigez une validation, quel que soit le modèle en tête du benchmark.


