L'aggiornamento DeepSeek V4.1 Flash alza i punteggi, ma le prove restano interne

Verifica delle fonti del 19 ottobre 2026: DeepSeek-V4.1-Flash-1017 è l’aggiornamento del 17 ottobre del modello V4.1 Flash pubblicato a settembre. I grafici seguenti sono stati realizzati autonomamente a partire dalla scheda del modello, ma le misurazioni sono di DeepSeek e non costituiscono una riproduzione indipendente. L’aggiornamento non ha modificato i prezzi dell’API. La tabella comparativa non specifica dimensioni dei campioni, intervalli di incertezza o budget di calcolo equivalenti fra fornitori. — Fonte
DeepSeek ha rilasciato un aggiornamento di DeepSeek V4.1 Flash il 17 ottobre, rivendicando punteggi benchmark più alti, completamento delle attività più rapido e output più brevi. Il checkpoint, denominato DeepSeek-V4.1-Flash-1017, sostituisce la versione di settembre nelle app web e mobile di DeepSeek e nell'API.
Il cambiamento importante non è una nuova famiglia di modelli né una nuova architettura. DeepSeek descrive 1017 come un aggiornamento minore dell'attuale modello V4.1 Flash. Gli sviluppatori continuano a chiamare deepseek-flash, mentre il servizio instrada le richieste verso il nuovo checkpoint senza richiedere una migrazione dell'API.
Questa sostituzione silenziosa crea la tensione centrale. DeepSeek presenta un migliore equilibrio tra prestazioni e costi, soprattutto per gli agenti di coding e il lavoro guidato dagli strumenti. Tuttavia, i risultati pubblicati restano riportati dall'azienda e non sono stati divulgati diversi dettagli di valutazione necessari per confronti ravvicinati.
I dati di DeepSeek meritano comunque attenzione. I maggiori miglioramenti sembrano riguardare il lavoro da terminale, la sintesi di programmi, l'automazione e le attività che attraversano interi repository software. Sono i carichi di lavoro nei quali Anthropic, OpenAI, Google, Moonshot AI e Zhipu AI competono per l'adozione da parte degli sviluppatori.
L'aggiornamento quindi mette sotto pressione più delle classifiche benchmark. Sfida i fornitori a dimostrare che i modelli premium completano attività reali in modo più affidabile, con meno token e meno intervento umano. DeepSeek ha migliorato la propria posizione in questa discussione, ma i test esterni devono ora stabilire quanto l'aggiornamento cambi i risultati in produzione.
L'aggiornamento DeepSeek V4.1 Flash è un checkpoint, non una nuova architettura
DeepSeek ha aggiornato il modello dietro un prodotto esistente invece di lanciare un'altra generazione architetturale.
Il changelog di ottobre dell'azienda afferma che DeepSeek V4.1 Flash è stato aggiornato a DeepSeek-V4.1-Flash-1017. Le applicazioni web e mobile ora usano la nuova versione, insieme all'endpoint API.
Gli utenti API esistenti non necessitano di un nuovo identificatore del modello. Le richieste che usano deepseek-flash raggiungono il checkpoint più recente. Anche gli identificatori legacy per i precedenti modelli Flash vengono instradati alla versione corrente, secondo la documentazione di DeepSeek.
Questo metodo di distribuzione può far apparire 1017 più piccolo di quanto non sia. Un endpoint stabile riduce il lavoro di migrazione, ma significa anche che il comportamento dell'applicazione può cambiare senza una modifica del nome del modello. I team che valutano la coerenza degli output dovrebbero registrare il checkpoint servito, non soltanto l'identificatore API.
Il rilascio è distinto dal lancio originale di V4.1 Flash del 10 settembre. Quel precedente rilascio ha introdotto l'architettura della famiglia di modelli, la comprensione visiva nativa, il supporto per contesti più lunghi e un design di inferenza rivisto. Il checkpoint di ottobre aggiorna il modello all'interno di questa base già consolidata.
L'architettura usa un design mixture-of-experts, o MoE. Questo approccio attiva soltanto una parte di una rete molto più grande per ciascun token, con l'obiettivo di ridurre il calcolo preservando un'ampia capacità del modello.
DeepSeek ha comunicato una struttura portante da 552 miliardi di parametri per il modello di settembre. Ha dichiarato che 8 miliardi di parametri sono attivi durante l'elaborazione dell'input e 16 miliardi durante la generazione dell'output. Queste specifiche descrivono l'architettura V4.1, non una nuova configurazione di parametri introdotta con 1017.
Il rilascio originale descriveva anche un design encoder-decoder causale. In termini semplici, il modello assegna capacità attiva diversa alla comprensione dei prompt e alla generazione delle risposte. DeepSeek presenta questa asimmetria come un modo per migliorare il throughput e ridurre le richieste di memoria.
Il suo report tecnico descrive il supporto per contesti fino a un milione di token. Una finestra di contesto è la quantità di materiale che un modello può considerare in una singola richiesta. L'attuale documentazione di DeepSeek elenca inoltre un limite massimo di output di 384.000 token.
Questi limiti non sono arrivati con 1017. Nemmeno la visione nativa, che faceva già parte di V4.1 Flash. Trattare tali capacità come aggiunte di ottobre sovrastimerebbe ciò che è cambiato.
Piuttosto, 1017 sembra essere un aggiornamento di post-training e comportamento. DeepSeek afferma che migliora il ragionamento, il coding, il lavoro degli agenti e le attività visive, riducendo al contempo i tempi di esecuzione e la lunghezza delle risposte. L'azienda non ha pubblicato un nuovo conteggio separato dei parametri per questo checkpoint.
Anche la distribuzione del modello aperto è rilevante. DeepSeek ha rilasciato il checkpoint tramite il suo repository del modello con licenza MIT. Ciò offre a ricercatori e team infrastrutturali accesso ai pesi, soggetto alle esigenze pratiche di servire un modello così grande.
I pesi aperti rendono possibile un'ispezione più approfondita. Non rendono la valutazione indipendente immediata né economica. Riprodurre benchmark per agenti richiede infrastruttura compatibile, configurazioni dell'harness, accesso agli strumenti, politiche di retry e notevole capacità di calcolo.
Il risultato è un rilascio facile da usare tramite API ma più difficile da validare in modo completo. Questo divario spiega perché la tabella benchmark di DeepSeek sostiene attualmente gran parte della narrazione.
I benchmark di coding di DeepSeek mostrano dove è migliorato l'aggiornamento
I miglioramenti riportati più forti si concentrano nelle attività di coding e degli agenti, dove esecuzioni più brevi possono contare quanto una maggiore accuratezza.
La variazione maggiore fra questi quattro test di programmazione riguarda Terminal-Bench 4.0, che passa da 31.2 a 42.3: un aumento di 11.1 punti, pari a circa il 35.6% rispetto al punteggio precedente. DeepSWE v1.1 sale da 74.2 a 77.0. Il confronto competitivo è misto: nella tabella del fornitore Flash-1017 supera il modello indicato come Opus 5 su DeepSWE, ma resta sotto su Terminal-Bench, ProgramBench e NL2Repo-Bench. Il confronto mantiene la denominazione esatta della fonte, Opus 5. Terminal-Bench utilizza Claude Code, mentre DeepSWE utilizza Mini-SWE-V2. La tabella non dimostra confronti a parità di budget né tassi di successo in produzione.

Grafico redazionale basato sui dati della scheda DeepSeek del 17 ottobre 2026. Un punteggio dichiarato più alto è migliore. Terminal-Bench: Claude Code; DeepSWE: Mini-SWE-V2. La tabella non specifica data della valutazione, dimensioni dei campioni, intensità del ragionamento, nuovi tentativi o budget equiparati di token e tempo. — Fonte
DeepSeek riporta un punteggio Terminal-Bench 4.0 di 42,3 per il checkpoint 1017. Il modello V4.1 Flash di settembre ha ottenuto 31,2 nel confronto dell'azienda. Ciò rappresenta un aumento di 11,1 punti nella configurazione pubblicata da DeepSeek.
Terminal-Bench valuta agenti che operano in ambienti a riga di comando. Queste attività richiedono più che scrivere una funzione isolata. Il modello deve interpretare gli obiettivi, usare strumenti, navigare tra i file, eseguire comandi e recuperare dagli errori.
L'azienda afferma di aver testato Terminal-Bench 4.0 attraverso il framework Claude Code. Questo dettaglio è importante perché un framework per agenti determina gli strumenti, le istruzioni e il ciclo di interazione disponibili per il modello sottostante.
Su DeepSWE v1.1, DeepSeek riporta un aumento da 74,2 a 77,0. Per questa valutazione ha usato il framework Mini-SWE-V2. I benchmark di ingegneria del software possono essere molto sensibili alla configurazione del repository, ai permessi degli strumenti e ai tentativi consentiti.
ProgramBench mostra un salto numerico più ampio, da 20,3 a 29,1. NL2Repo-Bench sale da 65,4 a 68,2. Quest'ultimo si concentra sulla traduzione di richieste in linguaggio naturale in modifiche applicate a repository software.
Il quadro suggerisce che DeepSeek abbia puntato a flussi di lavoro di coding prolungati, non soltanto alla programmazione con risposte brevi. Questa distinzione è importante per le aziende che testano agenti su code di issue, attività di code review, migrazioni e sessioni di debugging.
I benchmark per agenti mostrano una direzione simile. DeepSeek riporta 60,5 su Automation-Bench v1.0.6, rispetto a 54,8 per il checkpoint precedente. Agents’ Last Exam sale da 31,8 a 35,4.
Apex Bench v1.1 passa da 64,6 a 72,1 nella tabella dell'azienda. DeepSeek presenta questi risultati come prova del fatto che l'aggiornamento possa gestire sequenze più lunghe che coinvolgono pianificazione, uso di strumenti ed esecuzione.
Sono aumentati anche i punteggi degli agenti visivi. Chartography con strumenti è salito da 78,9 a 83,0, mentre BabyVision è passato da 89,6 a 92,5. ZeroBench-main con strumenti è aumentato da 49,0 a 51,0.
DeepSeek afferma che ZeroBench-main ha usato Pass@5. Questa metrica consente fino a cinque tentativi e registra se almeno uno ha successo. Non dovrebbe essere interpretata come direttamente equivalente a un tasso di successo al primo tentativo.
L'azienda riporta inoltre 42,6 su Humanity’s Last Exam senza strumenti. Elenca 44,0 per un sottoinsieme esclusivamente testuale, anche se il risultato del sottoinsieme non dovrebbe sostituire il punteggio della valutazione più ampia.
I miglioramenti benchmark sono coerenti in ogni confronto con i modelli precedenti pubblicato nella tabella. Nessun risultato elencato mostra il checkpoint 1017 dietro alla versione di settembre. Questa coerenza sostiene l'affermazione di DeepSeek secondo cui l'aggiornamento è complessivamente migliore nell'ambito delle valutazioni scelte.
Tuttavia, la tabella non divulga le dimensioni dei campioni per diversi confronti. Omette inoltre hardware, budget di token, limiti di tempo, budget di retry e impostazioni dello sforzo di ragionamento. Queste variabili possono influenzare materialmente le valutazioni degli agenti.
Un modello a cui sono consentite più chiamate agli strumenti o più token di ragionamento può completare attività che una configurazione più restrittiva non riesce a portare a termine. Può anche consumare più tempo e risorse pur producendo un punteggio migliore.
DeepSeek afferma che il nuovo checkpoint riduce sia i tempi di esecuzione sia la lunghezza degli output. Questa affermazione è centrale perché un output più breve può ridurre la quantità di testo generato che un'applicazione deve elaborare. Un completamento più rapido può inoltre migliorare l'esperienza utente e il throughput degli agenti.
Tuttavia, i materiali di rilascio non forniscono una percentuale universale per nessuna delle due riduzioni. I tempi di esecuzione variano in base al carico di lavoro, all'infrastruttura, alla lunghezza del contesto e al framework degli agenti. La lunghezza dell'output cambia con i prompt e la complessità dell'attività.
La lettura responsabile è quindi circoscritta. DeepSeek riporta punteggi migliori, completamento più rapido e risposte più brevi nei suoi harness valutati. Il miglioramento esatto in produzione resta dipendente dal carico di lavoro.
Output più brevi sono la vera pressione competitiva
DeepSeek sostiene che le prestazioni utili dell'AI dovrebbero essere misurate per attività completata, non soltanto tramite punteggi grezzi di intelligenza.
DeepSeek riporta aumenti da 54.8 a 60.5 su Automation-Bench v1.0.6, da 31.8 a 35.4 su Agents’ Last Exam e da 64.6 a 72.1 su Apex Bench v1.1. Flash-1017 supera il risultato di Opus 5 della tabella in tutti e tre i test, anche se ogni benchmark misura un insieme di compiti diverso. Questi punteggi giustificano ulteriori valutazioni nei flussi di lavoro con agenti, ma non dimostrano un’esecuzione affidabile in un ambiente senza restrizioni. Gli operatori dovrebbero misurare, sui propri carichi, il completamento corretto dei compiti, il totale dei nuovi tentativi, gli errori degli strumenti, il tempo di revisione e il costo totale dei token. DeepSeek raccomanda Harness 0.2.1-rc.1 o successivo per questa versione.

Grafico redazionale di tre diversi benchmark per agenti misurati da DeepSeek per la versione del 17 ottobre 2026; valori più alti sono migliori. La tabella non specifica intensità esatta fra fornitori, budget di token e tempo, dimensioni dei campioni o data della valutazione. I tre risultati non vanno sommati in un punteggio complessivo. — Fonte
Gli acquirenti di modelli si interessano sempre più a quanti flussi di lavoro riusciti un sistema completi entro un budget e un limite di tempo. Un punteggio benchmark elevato perde valore quando il modello entra in loop, scrive spiegazioni inutili o richiama ripetutamente gli strumenti.
Le attività degli agenti amplificano questo problema. Un assistente di coding può generare migliaia di token mentre esplora il percorso sbagliato. Può anche sprecare tempo rileggendo file o tentando correzioni che non affrontano il problema sottostante.
L'affermazione di DeepSeek sugli output più brevi prende direttamente di mira questa inefficienza. Se 1017 raggiunge lo stesso risultato o un risultato migliore con meno token generati, può ridurre insieme latenza e costi operativi. È una conseguenza più rilevante della sola prosa concisa.
L'azienda definisce il cambiamento un miglioramento Pareto di prestazioni e costi. Un miglioramento Pareto significa che un'opzione migliora in almeno una dimensione significativa senza peggiorare nelle altre misurate.
Qui, DeepSeek rivendica prestazioni benchmark più forti insieme a tempi di esecuzione più bassi e output più brevi. L'argomento è che gli sviluppatori non debbano più sacrificare altrettanta capacità per ottenere velocità o efficienza.
Le prove disponibili sostengono il lato delle prestazioni nella tabella di valutazione di DeepSeek. Non dimostrano pienamente il lato del costo per successo perché l'azienda non ha pubblicato misurazioni dettagliate delle risorse a livello di singola attività.
Le attuali specifiche del modello mostrano che Flash-1017 mantiene la configurazione di servizio esistente. Restano disponibili sia le modalità thinking sia non-thinking, insieme a chiamate agli strumenti, output JSON, visione e formati API compatibili.
L'endpoint invariato riduce inoltre l'attrito di distribuzione. Un team può testare il nuovo comportamento senza riscrivere l'integrazione. Questo vantaggio può accelerare l'adozione, soprattutto per gli sviluppatori che già usano DeepSeek Flash.
Crea però anche un rischio operativo. Le applicazioni costruite attorno a tono, struttura dell'output o comportamento di rifiuto stabili possono reagire male a una modifica silenziosa del checkpoint. I test di regressione diventano essenziali ogni volta che il modello ospitato cambia dietro un nome persistente.
Per le piattaforme di coding, la pressione immediata ricade sui modelli venduti attorno a un'affidabilità premium. La tabella di DeepSeek confronta 1017 con K3, GLM-5.3, GPT-5.6 Sol e un modello etichettato Opus 5.
Tali etichette devono essere riportate esattamente come le fornisce DeepSeek. La tabella non valuta ogni modello attuale di ciascuna azienda. La sua etichetta Opus 5 non dovrebbe essere convertita silenziosamente in un'altra release di Anthropic.
Il checkpoint di DeepSeek supera il riferimento Opus 5 della tabella su DeepSWE v1.1, Automation-Bench, Agents’ Last Exam e Apex Bench. Rimane invece indietro rispetto a quel riferimento su Terminal-Bench, ProgramBench, NL2Repo-Bench e tre test visivi elencati.
Questo risultato misto è più informativo di una semplice dichiarazione di vittoria. DeepSeek appare particolarmente competitivo in diverse valutazioni degli agenti, ma la tabella del fornitore stesso non mostra una leadership in ogni categoria.
La pressione sui concorrenti deriva dal pacchetto complessivo. DeepSeek combina pesi accessibili, un percorso API stabile, un'ampia finestra di contesto, input multimodale e punteggi degli agenti in miglioramento. Ogni attributo amplia il numero di team disposti a testarlo.
La release di settembre aveva già presentato l'efficienza come obiettivo architetturale. DeepSeek ha dichiarato che V4.1 Flash utilizzava un quarto della memoria ad alta larghezza di banda e un ottavo dell'archiviazione a stato solido per la sua cache chiave-valore.
Una cache chiave-valore conserva le informazioni generate durante l'inferenza, affinché il modello non ricalcoli tutto per ciascun nuovo token. Cache più piccole possono ridurre il carico di memoria di prompt lunghi e interazioni ripetute degli agenti.
Queste affermazioni architetturali riguardano V4.1 Flash come famiglia. La storia di ottobre è che DeepSeek afferma che il post-training abbia reso più efficace il design esistente. Non ha annunciato un'altra riprogettazione della cache con 1017.
Questa distinzione è importante per gli acquirenti. L'architettura spiega perché un modello potrebbe essere economico da servire. Il comportamento del checkpoint determina se completa in modo accurato ed efficiente le attività effettive dell'acquirente.
I team che valutano l'aggiornamento dovrebbero quindi misurare il lavoro completato, non solo i token generati. Dovrebbero monitorare modifiche riuscite, output accettati, correzioni umane, tempo trascorso e tentativi ripetuti su flussi di lavoro rappresentativi.
Questa valutazione può integrarsi in più ampi flussi di lavoro AI. Il passaggio essenziale è conservare prompt, materiale di origine, output e decisioni di revisione per confronti successivi.
Ciò che la tabella dei benchmark non dimostra
I numeri di DeepSeek sono prove significative della sua direzione ingegneristica, ma non costituiscono una conferma indipendente dell'affidabilità in produzione.
I risultati visivi con strumenti migliorano, ma non mostrano un vantaggio in ogni test. Chartography passa da 78.9 a 83.0, BabyVision da 89.6 a 92.5 e ZeroBench-main da 49.0 a 51.0. I risultati di Opus 5 nella fonte restano più alti: 84.0, 94.1 e 52.0. Queste valutazioni consentono l’uso di strumenti, quindi i numeri non rappresentano la precisione grezza su sole immagini. ZeroBench-main utilizza Pass@5, che ammette più tentativi; il risultato non va presentato come affidabilità al primo tentativo. Per azioni con conseguenze importanti, gli agenti visivi richiedono ancora autorizzazioni adeguate per gli strumenti, recupero dagli errori e revisione umana.

Valutazioni visive con strumenti effettuate da DeepSeek per la versione del 17 ottobre 2026; valori più alti sono migliori. ZeroBench-main è Pass@5. La tabella non specifica altri limiti ai tentativi, dimensioni dei campioni, intervalli di incertezza, budget equivalenti o data della valutazione. — Fonte
Il limite principale è l’indipendenza delle fonti. DeepSeek ha pubblicato il confronto e scelto modelli, benchmark, harness e configurazioni. Le fonti primarie esaminate per questo articolo non forniscono un risultato riprodotto in modo indipendente per l’esatto checkpoint 1017.
Questo non rende falsi i punteggi. Le valutazioni dei fornitori sono spesso la prima evidenza disponibile dopo il rilascio di un modello. Possono mostrare dove un'azienda ha investito e quali carichi di lavoro prevede di migliorare.
Non possono risolvere ogni confronto. I benchmark per agenti contengono più componenti variabili dei test standard di domanda e risposta. Il system prompt, gli strumenti, il timeout, la sandbox e la logica di tentativo di un framework possono modificare il punteggio finale.
DeepSeek divulga alcune condizioni. Terminal-Bench ha usato Claude Code, DeepSWE ha usato Mini-SWE-V2 e ZeroBench-main ha usato Pass@5. L'azienda raccomanda inoltre DeepSeek Harness versione 0.2.1-rc.1 o successiva.
Questa raccomandazione suggerisce che l'integrazione dell'harness faccia parte della storia delle prestazioni. DeepSeek afferma di aver ottimizzato il modello per il proprio harness, Tencent CodeBuddy, WorkBuddy e altre piattaforme.
I miglioramenti del modello e dell'harness sono entrambi legittimi. Tuttavia, gli acquirenti devono sapere se i miglioramenti si trasferiscono tra ambienti diversi. Un checkpoint ottimizzato attorno a un ciclo di agente potrebbe comportarsi diversamente nel livello di orchestrazione di un'altra azienda.
L'assenza di impostazioni di ragionamento divulgate aggiunge incertezza. DeepSeek supporta più livelli di sforzo di ragionamento, che influenzano la quantità di calcolo interno assegnata a una richiesta. Un'impostazione più alta può migliorare i risultati aumentando al contempo latenza o utilizzo di token.
Anche i dettagli hardware contano per le dichiarazioni sulla velocità. Il runtime su un servizio ospitato non si traduce direttamente nell'inferenza self-hosted. Overhead di rete, batching, quantizzazione e scelta dell'acceleratore possono dominare la latenza osservata.
I pesi aperti rendono queste questioni verificabili, ma l'hosting autonomo non è automaticamente semplice. Un backbone da 552 miliardi di parametri crea requisiti impegnativi di archiviazione e memoria, anche quando per token si attiva solo una parte della rete.
La quantizzazione riduce la memoria memorizzando i pesi a una precisione numerica inferiore. Può rendere il deployment più pratico, ma i risultati possono differire dalla configurazione ufficiale del checkpoint. I team dovrebbero validare l'accuratezza dopo qualsiasi conversione.
La sicurezza rappresenta un'altra preoccupazione in produzione. Gli agenti di coding spesso leggono repository, eseguono comandi, installano pacchetti e modificano file. Un punteggio benchmark migliore non dimostra che un modello possa ricevere in sicurezza autorizzazioni ampie.
Le organizzazioni dovrebbero isolare il lavoro degli agenti, limitare le credenziali, registrare le chiamate agli strumenti e richiedere una revisione per modifiche sensibili. Questi controlli si applicano a ogni modello di coding, indipendentemente dalla posizione nei benchmark.
La stessa cautela vale per la finestra di contesto da un milione di token. Il supporto a un contesto ampio non garantisce un recupero affidabile da ogni posizione. Prompt lunghi possono introdurre distrazioni, istruzioni in conflitto e elaborazione non necessaria.
Anche il supporto nativo alla visione di DeepSeek precede l'aggiornamento di ottobre. I punteggi più alti degli agenti visivi suggeriscono un uso migliore di questa capacità, ma non dimostrano un'affidabilità equivalente tra grafici, interfacce, documenti e immagini naturali.
Il contesto storico rafforza la necessità di affermazioni misurate. Il lancio di V4 da parte di DeepSeek ha attirato attenzione perché combinava il supporto a un contesto ampio con un'architettura orientata all'efficienza. Analisti indipendenti citati in coperture precedenti hanno ritenuto la famiglia competitiva rispetto ai principali modelli americani.
Questa competitività più ampia non convalida automaticamente i miglioramenti esatti del nuovo checkpoint. I pesi 1017 richiedono test propri, soprattutto su carichi di lavoro che assomigliano ai deployment reali.
Una valutazione pratica dovrebbe confrontare entrambi i checkpoint con prompt e strumenti identici. Dovrebbe preservare temperatura, impostazioni di sforzo, timeout, numero di tentativi e stati dei repository.
I revisori dovrebbero inoltre valutare la qualità dell'output dopo aver rimosso i vantaggi della prolissità. Una risposta più breve è utile quando rimane completa. Diventa una regressione se omette test, avvertenze, passaggi di migrazione o spiegazioni degli errori.
Nel lavoro basato sulla conoscenza, la concisione può produrre compromessi simili. Riassunti brevi riducono il tempo di lettura, ma risposte compresse possono nascondere incertezza o scartare prove minoritarie. La revisione umana resta necessaria per decisioni rilevanti.
Il giusto scetticismo è quindi specifico. DeepSeek ha pubblicato prove credibili di prima parte di un miglioramento. Non ha ancora dimostrato guadagni universali di velocità, un costo totale delle attività inferiore o un'affidabilità superiore in ambienti di produzione indipendenti.
Tre segnali mostreranno se Flash-1017 cambia il mercato
La riproduzione indipendente, le prestazioni tra harness diversi e l'adozione sostenuta da parte degli sviluppatori determineranno se 1017 diventerà qualcosa di più di una forte release di benchmark del fornitore.
L’aggiornamento del 17 ottobre sostituisce il checkpoint fornito tramite l’alias API deepseek-flash, mantenendo i prezzi. Alla verifica del 19 ottobre, un milione di token Flash costa fuori punta 0.003 dollari per l’input in cache, 0.15 per l’input senza cache e 0.60 per l’output; nelle ore di punta i prezzi sono 0.006, 0.30 e 1.20 dollari. Per un compito esplicitamente ipotetico con un milione di token di input senza cache, quattro milioni in cache e 100000 token di output, il solo addebito per i token del modello è 0.222 dollari fuori punta o 0.444 nelle ore di punta. Il calcolo esclude ricerca e recupero, infrastruttura, nuovi tentativi e revisione umana. Un output più breve può ridurre la relativa spesa, ma l’affermazione di DeepSeek su velocità e costi non implica un risparmio fisso per ogni carico di lavoro.
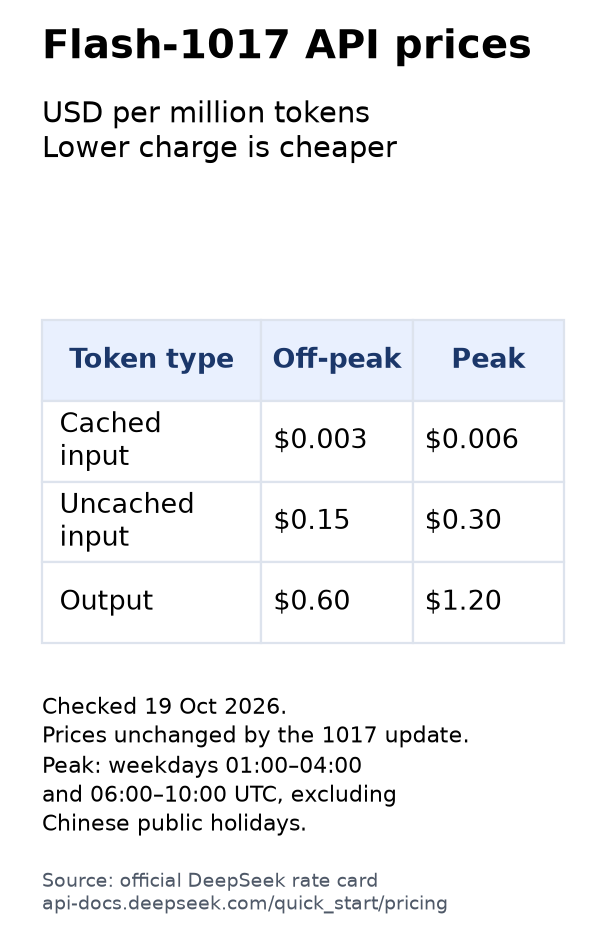
Tariffe ufficiali di Flash-1017 verificate il 19 ottobre 2026, in dollari statunitensi per milione di token; una tariffa inferiore è più economica. Le ore di punta sono nei giorni lavorativi 01:00–04:00 e 06:00–10:00 UTC, escluse le festività ufficiali cinesi. I prezzi dei token del modello sono separati da ricerca, recupero e altri costi operativi. — Fonte
Il primo segnale è una valutazione indipendente dell'esatto checkpoint 1017. I ricercatori devono testare i pesi rilasciati anziché il modello di settembre o un alias ospitato dalla versione incerta.
Tali test dovrebbero pubblicare prompt, versioni dell'harness, impostazioni di sforzo, hardware, limiti di tempo e politiche di tentativo. I risultati dovrebbero includere accuratezza, tempo trascorso, token in output e comportamento delle attività non riuscite.
Una conferma della direzione riportata da DeepSeek rafforzerebbe la tesi dell'azienda. Grandi regressioni o guadagni fortemente dipendenti dalla configurazione la indebolirebbero. Risultati misti suggerirebbero che 1017 avvantaggia alcuni cicli degli agenti più di altri.
Il secondo segnale sono le prestazioni su più harness. DeepSeek ha ottimizzato specificamente per piattaforme selezionate, rendendo la portabilità una questione centrale. Il modello dovrebbe mantenere i propri guadagni in agenti di coding alternativi e sistemi aziendali di orchestrazione.
I test tra harness diversi possono separare il miglioramento del modello dal miglioramento dell'integrazione. Entrambi hanno valore, ma rispondono a domande di acquisto differenti.
Un'azienda che adotta DeepSeek Harness può beneficiare del sistema combinato. Un'azienda che mantiene un agente interno consolidato necessita di prove che il solo checkpoint migliori il proprio flusso di lavoro.
Osservate se test di terze parti riproducono l'aumento di Terminal-Bench senza modificare l'accesso agli strumenti. Osservate anche se output più brevi restano completi quando un altro framework usa un system prompt differente.
Guadagni coerenti sosterrebbero l'affermazione di DeepSeek di un checkpoint sottostante migliore. Guadagni limitati agli harness preferiti renderebbero la scelta dell'integrazione una parte più rilevante della decisione.
Il terzo segnale è l'adozione sostenuta da parte degli sviluppatori dopo il ciclo iniziale di rilascio. Download, integrazioni, test riproducibili e casi di studio in produzione contano più dell'attenzione della settimana del lancio.
I pesi con licenza MIT riducono le frizioni legali per la sperimentazione. Tuttavia, la scala del modello alza la soglia infrastrutturale per un serio hosting autonomo. Molti team continueranno a scegliere l'accesso ospitato o fornitori specializzati di inferenza.
L'adozione dovrebbe quindi essere misurata su entrambe le vie. L'utilizzo ospitato mostra se l'esperienza API è attraente. I deployment self-hosted mostrano se l'accesso aperto crea alternative pratiche per organizzazioni con requisiti specializzati.
La retention conta più delle prove. Gli sviluppatori testano frequentemente nuovi modelli perché cambiare un identificatore API è semplice. Mantengono un modello solo quando migliora il lavoro accettato senza creare nuovi oneri di revisione.
L'esito probabile nel breve termine è un ampliamento dei test, non un immediato rimescolamento del mercato. DeepSeek ha dato ai team degli agenti di coding una ragione concreta per rieseguire le proprie valutazioni. I suoi guadagni riportati più forti sono allineati a compiti che gli sviluppatori faticano già ad automatizzare in modo affidabile.
I concorrenti hanno ancora margine per rispondere con modelli migliori, framework per agenti più solidi, latenza inferiore, esecuzione più sicura o comportamento più prevedibile. La stessa tabella di DeepSeek mostra che il checkpoint 1017 non guida ogni confronto.
La release dimostra inoltre una cadenza competitiva più rapida. Un'importante architettura è arrivata a settembre, seguita cinque settimane dopo da un checkpoint incentrato sul comportamento. Il routing API stabile consente a DeepSeek di distribuire quel miglioramento immediatamente.
Questa cadenza avvantaggia gli utenti quando gli aggiornamenti producono guadagni misurabili. Complica la governance quando il comportamento cambia più rapidamente dei cicli di valutazione aziendali. I team necessitano di registri delle versioni e suite di regressione ricorrenti per gestire entrambi gli effetti.
Per gli sviluppatori, la decisione è semplice. Testate DeepSeek-V4.1-Flash-1017 sulle attività esatte svolte dai vostri utenti. Misurate risultati accettati, tentativi, latenza, lunghezza dell'output e correzioni umane.
Gli acquirenti aziendali dovrebbero chiedere ai fornitori identificatori dei checkpoint e avvisi sulle modifiche. Dovrebbero inoltre richiedere condizioni di valutazione riproducibili prima di trattare qualsiasi leadership in un benchmark come una conclusione d'acquisto.
I knowledge worker dovrebbero prestare attenzione al fatto che risposte più brevi preservino prove e sfumature. Una risposta più veloce crea poco valore quando qualcuno deve ricostruire in seguito il ragionamento mancante.
L'aggiornamento DeepSeek V4.1 Flash ha già cambiato l'insieme dei confronti. Eleva i punteggi di coding e agenti del checkpoint precedente mantenendo lo stesso percorso di accesso e la stessa famiglia di modelli.
Ciò che accadrà ora dipende dalle prove esterne al laboratorio di DeepSeek. Eseguite confronti controllati, conservate il record completo della valutazione e osservate se test indipendenti riproducono la combinazione dichiarata di accuratezza, velocità e concisione.


