Nano Banana 2.1: cosa rivelano i benchmark sulle immagini di Google


Google ha rilasciato Nano Banana 2.1 il 6 ottobre 2026. Questa analisi, datata 14 ottobre, lo considera come un seguito di quel rilascio, non come un nuovo lancio odierno.
I risultati pubblicati costituiscono un'argomentazione credibile a favore del fatto che Nano Banana 2.1 migliori Nano Banana 2 in diverse attività di generazione e modifica delle immagini. I vantaggi riportati più rilevanti emergono nella progettazione di infografiche, nella coerenza di più personaggi, nella modifica basata su maschere e nel lavoro con più riferimenti. L'abilitazione di Thinking produce in genere i punteggi più elevati, sebbene il suo valore vari a seconda dell'attività.
Questi risultati richiedono confini interpretativi rigorosi. La maggior parte dei punteggi è costituita da valutazioni Elo basate sulle preferenze, non da percentuali di immagini corrette. Google fornisce intervalli di errore per i risultati Elo, ma non ne definisce il livello di confidenza. Non divulga conteggi dei campioni, prompt dei benchmark, risoluzioni delle immagini, budget per i tentativi, impostazioni dettagliate di Thinking o condizioni di calcolo equivalenti nella tabella della model card. Il risultato relativo alla factuality proviene da un valutatore automatizzato anziché da una misurazione dell'accuratezza umana.
Di conseguenza, i benchmark sono prove utili delle prestazioni relative nell'ambito della valutazione di Google, ma non stabiliscono affidabilità in produzione, latenza o ritorno sull'investimento. I team che valutano una migrazione necessitano comunque di test specifici per il carico di lavoro, con input controllati, criteri di fallimento e costi completi per richiesta.
Cosa ha effettivamente rilasciato Google il 6 ottobre
Nano Banana 2.1 è il modello aggiornato di Google, nella classe Flash, per la generazione di immagini e il conversational editing. Il codice del modello Gemini API stabile è gemini-nano-banana-2.1. Google lo descrive come un aggiornamento di Gemini 3.1 Flash Image, chiamato anche Nano Banana 2, e come una controparte più efficiente di Gemini 3 Pro Image, comunemente chiamato Nano Banana Pro. Il changelog di Gemini API registra il suo rilascio in disponibilità generale il 6 ottobre 2026.
Secondo la model card di Nano Banana 2.1, il modello si basa su Gemini 3.6 Flash e accetta testo e immagini, restituendo immagini e testo. Google lo posiziona per la creazione controllata di immagini, la modifica, la grafica ricca di testo, il rendering localizzato e i flussi di lavoro iterativi. La sua valutazione combina giudizi umani di preferenza affiancati per generazione e modifica con una singola valutazione automatizzata della factuality.
La card identifica inoltre limiti concreti: il testo piccolo o lungo può sfocarsi o degradarsi; l'identità può variare; le modifiche mascherate possono conservare tratti d'inchiostro o seguire solo parzialmente le istruzioni; le pose possono persistere in modo inatteso; relazioni spaziali come sinistra e destra possono essere confuse; e conoscenza del mondo, ragionamento 3D e factuality restano imperfetti. Vengono riconosciuti anche occasionali rallentamenti e timeout. Non sono note a piè di pagina, bensì rischi operativi: ciascuno richiede un test di accettazione e una politica di fallback prima della distribuzione.
La documentazione del modello API di Google aggiunge dettagli di implementazione. L'output è predefinito a 1K e può essere richiesto fino a 4K. Thinking offre minimal, medium—l'impostazione predefinita—e high. Il modello supporta il search grounding, ma non il function calling, l'esecuzione di codice o gli output strutturati.
La scheda del modello indica un contesto fino a un milione di token e un output di testo fino a 64K, mentre la pagina dell'API Gemini distribuita indica 131,072 token di input e 32,768 token di output. I documenti pubblici non spiegano la relazione tra questi diversi limiti. I responsabili della distribuzione dovrebbero seguire i limiti documentati dello specifico endpoint che chiamano, anziché presumere che le cifre più elevate della scheda del modello siano disponibili tramite tale API.
L'Elo della generazione indica un vantaggio, non un tasso di accuratezza
Google riporta due confronti text-to-image valutati da esseri umani: preferenza complessiva e progettazione di infografiche. In entrambi, Nano Banana 2.1 con Thinking si classifica al primo posto, seguito da Nano Banana 2.1 senza Thinking, Nano Banana 2 Thinking e Nano Banana Pro.
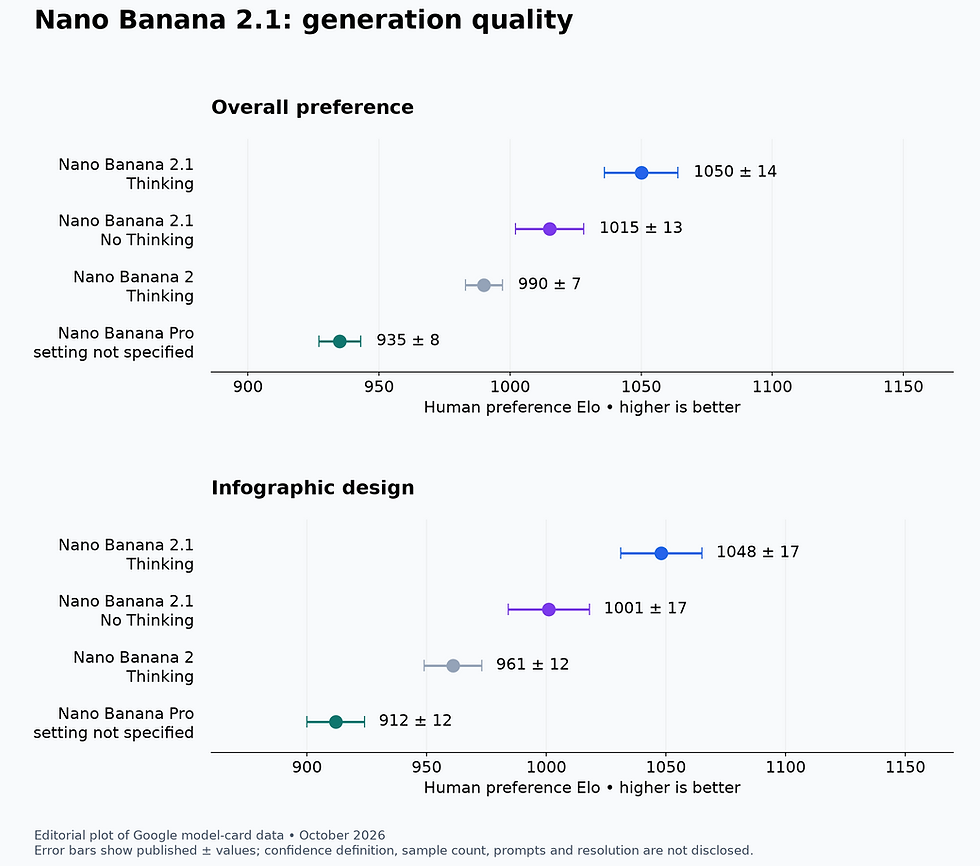
Grafico editoriale di dati numerici pubblicati nella model card di Nano Banana 2.1 di Google DeepMind, ottobre 2026. Un Elo più alto indica una preferenza umana relativa più forte nei confronti di Google; le barre di errore mostrano gli intervalli ± pubblicati, la cui definizione di confidenza non è indicata. Non è un'immagine originale di Google e l'Elo non è accuratezza percentuale.
Per la preferenza complessiva, Nano Banana 2.1 Thinking ottiene 1050 ±14, rispetto a 1015 ±13 senza Thinking, 990 ±7 per Nano Banana 2 Thinking e 935 ±8 per Pro. Per la progettazione di infografiche, i risultati corrispondenti sono 1048 ±17, 1001 ±17, 961 ±12 e 912 ±12.
L'ordinamento è coerente e diverse differenze sono più ampie degli intervalli visualizzati. In particolare, entrambe le modalità Nano Banana 2.1 si collocano sopra Nano Banana 2 nella progettazione di infografiche anche considerando gli intervalli pubblicati. Ciò costituisce una prova significativa di un vantaggio in termini di preferenza nell'ambito di questa valutazione. Non dimostra che 2.1 vincerà per ogni prompt, produrrà un'infografica corretta o richiederà meno tentativi in produzione.
Thinking sembra vantaggioso in questo caso. Il suo vantaggio di 35 punti nella preferenza complessiva rispetto a No Thinking presenta intervalli visualizzati non sovrapposti: 1036–1064 contro 1002–1028. Gli intervalli per la progettazione di infografiche si toccano a 1031, quindi il grafico supporta un vantaggio ma non una dimensione dell'effetto universale e precisa. Google etichetta inoltre la configurazione del benchmark solo come “Thinking”. Non rivela se l'esecuzione abbia utilizzato minimal, medium, high, una policy adattiva o un'altra impostazione interna.
Questa omissione limita le conclusioni su costi e latenza. Un punteggio Thinking più elevato non può essere tradotto in “abilitare sempre high Thinking” senza misurare in che modo ogni impostazione disponibile influenzi uno specifico flusso di lavoro. La tabella dei benchmark non contiene misurazioni della latenza e questa analisi non dovrebbe inventarne.
Il segnale pratico è più ristretto: i team i cui utenti valutano composizione, rifinitura visiva o layout delle infografiche dovrebbero includere Nano Banana 2.1 Thinking come candidato serio. I team che generano asset decorativi a basso rischio potrebbero ritenere sufficiente No Thinking, ma questa decisione spetta a un test controllato con i propri prompt e soglie di accettazione.
La coerenza migliora, ma il risultato per il singolo personaggio è ravvicinato
La coerenza è spesso più preziosa della pura attrattiva visiva nei personaggi ricorrenti, nelle varianti di campagna, negli storyboard, nelle spiegazioni di prodotto e nella modifica multi-turno. Google separa la coerenza del singolo personaggio da quella di più personaggi, e questi due risultati raccontano storie diverse.

Grafico editoriale dei dati della model card di Google DeepMind dell'ottobre 2026 per la coerenza di singoli e più personaggi. Un Elo più alto significa maggiore preferenza umana relativa; gli intervalli ± pubblicati sono mostrati senza una definizione di confidenza indicata. La quasi sovrapposizione tra Nano Banana 2.1 Thinking e No Thinking per la coerenza del singolo personaggio è importante. Non è un'immagine originale di Google.
Per la coerenza del singolo personaggio, Nano Banana 2.1 Thinking raggiunge 1028 ±14 e No Thinking raggiunge 1021 ±14. I loro intervalli visualizzati si sovrappongono in misura sostanziale, da 1014 a 1035. Sarebbe quindi ingiustificato presentare la differenza di sette punti come un vantaggio pratico consolidato. Entrambe le configurazioni 2.1 ottengono punteggi superiori a Nano Banana 2 Thinking, con 981 ±10, e a Pro, con 991 ±9, ma il benchmark non mostra se i fallimenti riguardassero volti, abbigliamento, proporzioni corporee, accessori o variazioni di stile.
Il risultato per più personaggi è più differenziato. Thinking ottiene 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10 e Nano Banana 2 Thinking 978 ±10. Gli intervalli di 2.1 Thinking e No Thinking non si sovrappongono. Questo suggerisce che il ragionamento aggiuntivo possa essere più utile quando una scena richiede al sistema di seguire diverse identità e le loro relazioni.
Anche così, “supporta fino a quattro personaggi” non equivale a “preserva quattro identità in modo affidabile”. La documentazione API afferma che la fusione multi-immagine accetta fino a 14 immagini di riferimento, comprese fino a quattro personaggi e dieci oggetti. Sono limiti di input, non garanzie di fedeltà. Non rivelano come cambino le prestazioni quando i riferimenti diventano visivamente simili, contraddittori, ritagliati, a bassa risoluzione o illuminati in modo disomogeneo.
Una valutazione in produzione dovrebbe assegnare un punteggio a ciascun soggetto separatamente. Etichette di fallimento utili includono variazione del volto, trasferimento dell'abbigliamento, contaminazione di attributi tra personaggi, soggetti mancanti, duplicazioni indesiderate, variazione dell'età e altezza relativa incoerente. Un singolo voto di preferenza complessiva può nascondere un grave difetto d'identità se il resto dell'immagine appare attraente.
Per un flusso di lavoro con un solo personaggio, il grafico fornisce poche prove che Thinking sia necessario per ogni richiesta. Per scene con più persone ricorrenti, il suo vantaggio riportato più ampio lo rende più promettente, ma resta soggetto a costi misurati, latenza e tassi di fallimento dell'identità.
I risultati di editing favoriscono 2.1, con rischi diversi a seconda dell'attività
I benchmark di editing sono particolarmente rilevanti perché un output dall'aspetto plausibile può essere comunque inutilizzabile se modifica regioni protette, perde dettagli del prodotto o fonde i riferimenti in modo errato. Google riporta punteggi Elo per editing generale, coerenza, editing basato su maschere o inchiostro, coerenza del prodotto, stilizzazione e editing con più riferimenti.

Grafico editoriale di risultati numerici verificati dalla model card di Nano Banana 2.1 di Google DeepMind, ottobre 2026. Un Elo più alto indica una preferenza umana relativa più forte per l'editing con maschere/inchiostro, la coerenza del prodotto e l'editing con più riferimenti; vengono visualizzati gli intervalli ± pubblicati, senza una definizione di confidenza indicata. Non è un'immagine originale di Google e non misura l'esatta conformità alle modifiche.
L'editing basato su maschere o inchiostro è l'esempio più chiaro di un vantaggio condiviso di 2.1 senza un vantaggio Thinking dimostrato. Thinking ottiene 1049 ±15 e No Thinking 1042 ±16; i loro intervalli si sovrappongono ampiamente. Entrambi superano Nano Banana 2 Thinking, con 965 ±12, e Pro, con 927 ±12. Se l'editing tramite maschere domina un carico di lavoro, No Thinking può meritare pari attenzione durante i test, anziché essere considerato una modalità intrinsecamente inferiore.
Tuttavia, i limiti dichiarati da Google qualificano il risultato. Il modello può seguire solo parzialmente le istruzioni di modifica mascherata, conservare segni di scarabocchi o inchiostro, oppure mantenere la posa del soggetto di origine. L'Elo di preferenza non può stabilire che i pixel al di fuori dell'area consentita siano rimasti invariati. Per i flussi di lavoro di catalogo e regolamentati, è essenziale una metrica di preservazione separata.
La coerenza del prodotto mostra un confronto meno decisivo tra 2.1 No Thinking e i modelli precedenti. I punteggi sono 1024 ±18 con Thinking, 981 ±18 senza, 955 ±22 per Nano Banana 2 Thinking e 965 ±14 per Pro. L'intervallo di No Thinking si sovrappone a quelli di entrambi i modelli precedenti. Il grafico pubblicato supporta quindi Thinking come configurazione più forte in questa valutazione, ma non giustifica l'affermazione che ogni configurazione 2.1 migliori chiaramente la fedeltà del prodotto.
L’editing con più riferimenti racconta una storia più solida per 2.1: 1066 ±22 con Thinking e 1041 ±20 senza, contro 988 ±13 per Nano Banana 2 Thinking e 989 ±12 per Pro. Tuttavia, i due intervalli di 2.1 si sovrappongono, quindi il divario di 25 punti tra i loro punteggi centrali non va enfatizzato eccessivamente.
Queste attività richiedono inoltre criteri di accettazione differenti. Un compositing creativo può tollerare piccole variazioni geometriche, mentre un’immagine ecommerce può non superare la verifica se cambiano un logo, una porta, un pulsante, un materiale o la quantità nella confezione. Le decisioni di migrazione dovrebbero quindi essere prese per classe di modifica, non sulla base di una conclusione aggregata secondo cui “l’editing è migliore”.
La fattualità è promettente, ma resta l’affermazione più debole
Google riporta punteggi di fattualità delle infografiche pari a 0.521 per Nano Banana 2.1 Thinking, 0.328 senza Thinking, 0.265 per Nano Banana Pro e 0.179 per Nano Banana 2 Thinking.

Grafico editoriale dei dati AutoRater sulla fattualità di ottobre 2026 dalla model card di Nano Banana 2.1 di Google DeepMind. Un valore più alto è migliore, ma questo punteggio di valutazione automatizzata unilaterale non è una percentuale di accuratezza umana. Google non pubblica qui intervalli di incertezza. Questa non è un’immagine originale di Google.
Il risultato supporta una conclusione limitata: secondo la valutazione automatizzata di Google, Thinking migliora sostanzialmente il punteggio di fattualità di Nano Banana 2.1, e il punteggio risultante supera quelli dei comparatori elencati. Non significa che il 52,1% delle infografiche sia fattualmente corretto. La model card non definisce il punteggio come percentuale, non ne pubblica l’incertezza, non divulga il numero di prompt e non fornisce qui dettagli sufficienti per calcolare i tassi di errore.
Questa distinzione conta perché la grafica fattuale presenta molteplici superfici di errore. Un grafico può contenere testo corretto ma rappresentare valori errati. Può citare una fonte reale ma associare date non corrispondenti. Una mappa può scambiare regioni; una cronologia può invertire gli eventi; un’etichetta può essere assegnata all’oggetto sbagliato. Il punteggio automatizzato può cogliere alcuni di questi errori, ma la tabella non ne divulga la copertura con dettagli sufficienti per trattarlo come un criterio di rilascio.
Il grounding tramite ricerca può fornire informazioni più recenti, ma il recupero non garantisce una trascrizione visiva fedele. La model card descrive inoltre un cutoff della conoscenza a marzo 2026 per Gemini 3.6 Flash, con alcuni domini potenzialmente limitati a gennaio 2025 e altri che ricevono informazioni più recenti. Per la grafica sensibile al fattore tempo, il materiale sorgente dovrebbe essere fornito o recuperato esplicitamente, quindi verificato rispetto all’immagine renderizzata.
Un flusso di lavoro difendibile separa la verità della fonte dalla presentazione. Mantenete una scheda dei fatti approvata contenente valori, unità, date, etichette e citazioni; generate la visualizzazione a partire da quel brief; quindi confrontate ogni affermazione renderizzata con i fatti approvati. È anche qui che mantenere fatti e brief delle fonti tracciabili per i contenuti visivi aiuta a mantenere la revisione ancorata alle prove sottostanti, anziché all’apparente sicurezza dell’immagine.
Il benchmark rende Thinking l’ovvio candidato per la fattualità, non un sistema di pubblicazione autonomo. La verifica umana o deterministica resta necessaria per grafica medica, finanziaria, legale, storica, scientifica e relativa agli eventi correnti.
L’output è più economico a ogni risoluzione, ma le richieste potrebbero non esserlo
Alle tariffe API a pagamento Standard, Google indica per l’output di immagini di Nano Banana 2.1 un costo di $30 per milione di token immagine in output. Nano Banana 2 costa $60 per milione. Questo titolo suggerisce una riduzione universale del 50%, ma le diverse allocazioni di token a 4K e le tariffe più elevate per i contenuti non immagine complicano il totale.

Calcolo editoriale basato sui prezzi dell’API Gemini di Google, ottobre 2026. Un costo inferiore per il solo output immagine è migliore: Nano Banana 2.1 è inferiore del 50% a 1K e 2K e del 25% a 4K. I costi escludono input, output di testo o Thinking, grounding, nuovi tentativi, imposte e possibili sconti Batch. Questa non è un’immagine originale di Google.
Il calcolo trasparente è tariffa moltiplicata per token immagine in output:
A 1K, 1.120 token immagine costano $0,0336 per Nano Banana 2.1 e $0,0672 per Nano Banana 2. A 2K, 1.680 token costano rispettivamente $0,0504 e $0,1008. A 4K, i modelli usano diverse allocazioni di token: 3.780 × $30 per milione produce $0,1134 per 2.1, mentre 2.520 × $60 per milione produce $0,1512 per Nano Banana 2.
Pertanto, “metà prezzo” è accurato solo per i token di output immagine a 1K e 2K. A 4K, Nano Banana 2.1 usa più token immagine elencati, riducendo il risparmio sul solo output al 25%.
Altre componenti possono muoversi nella direzione opposta. Il prezzo Standard dell’input per Nano Banana 2.1 è $1,50 per milione di token di testo, immagini o video, contro $0,50 per milione di token di testo o immagini per Nano Banana 2. L’output di testo e Thinking costa $7,50 per milione di token per 2.1 contro $3 per Nano Banana 2. Una stima completa deve quindi includere i token di input effettivi, l’output testuale, il consumo di Thinking, i costi di grounding ove applicabili, i nuovi tentativi, le imposte e qualsiasi sconto Batch.
Nessun totale di “richiesta tipica” può essere calcolato responsabilmente senza assumere lunghezza del prompt, tokenizzazione delle immagini di riferimento, uso di Thinking, risoluzione e tasso di nuovi tentativi. Un’immagine riuscita più economica può comunque derivare da una richiesta più costosa, mentre una migliore accettazione al primo passaggio può compensare costi di ragionamento più elevati. Misurate il costo per asset accettato, non solo il prezzo per immagine generata.
Un piano di valutazione suggerito per la migrazione
Quello che segue è un progetto di test proposto, non una descrizione dei test eseguiti per questo articolo.
Iniziate con un set stratificato di prompt tratto dal lavoro reale. Separate testo-immagine, personaggio singolo, più personaggi, editing di prodotti, editing con maschera, composizione con più riferimenti, layout ricchi di testo e grafica fattuale. Conservate prompt, file di riferimento, rapporti d’aspetto, risoluzioni e impostazioni di sicurezza affinché ogni modello riceva lo stesso compito.
Confrontate Nano Banana 2.1 con Thinking minimo, medio e alto con Nano Banana 2 Thinking. Includete Pro solo se è una reale opzione di deployment; poiché il grafico di benchmark non specifica l’impostazione di Pro, non presumete che la sua configurazione di calcolo o ragionamento corrisponda alle altre. Assegnate a ogni condizione lo stesso budget di nuovi tentativi nel test interno, anche se Google non divulga se il suo benchmark abbia fatto lo stesso.
Definite le regole di accettazione prima di esaminare gli output:
Per il rendering del testo, trascrivete ogni parola richiesta e registrate testo mancante, sostituito, sfocato o malformato.
Per l’identità, valutate ogni personaggio in modo indipendente e registrate contaminazione di attributi, duplicazione, omissione e deriva del volto o dell’abbigliamento.
Per il lavoro sui prodotti, confrontate caratteristiche protette quali forma, logo, controlli, quantità, colore, materiale e testo della confezione.
Per le modifiche con maschera, misurate sia il successo nella regione richiesta sia le modifiche indesiderate al di fuori della maschera.
Per i prompt spaziali, testate sinistra/destra, primo piano/sfondo, contenimento, ordinamento e dimensione relativa.
Per la grafica fattuale, verificate ogni numero, unità, data, etichetta, citazione e codifica visiva rispetto a una scheda sorgente bloccata.
Per le operazioni, registrate timeout, latenza end-to-end, numero di nuovi tentativi, uso dei token, costi di grounding e costo per risultato accettato.
Usate una revisione umana in cieco per la qualità soggettiva e controlli deterministici ovunque sia possibile l’esattezza. Riportate l’incertezza e conservate gli esiti appaiati, poiché la stessa esecuzione di prompt tra modelli è più informativa di medie non correlate. Non condensate tutte le attività in un unico punteggio se gli errori hanno conseguenze aziendali diverse.
Testate il comportamento dell’endpoint oltre alla qualità dell’immagine. Confermate i limiti di 131.072 input e 32.768 output rispetto alla documentazione API corrente, verificate la risoluzione predefinita di 1K ed esercitate esplicitamente 2K e 4K. Testate input con 14 riferimenti solo se necessario, ricordando che i limiti di quattro personaggi e dieci oggetti non promettono la conservazione. Poiché function calling, esecuzione del codice e output strutturati non sono supportati, l’orchestrazione e la convalida devono avvenire al di fuori del modello.
Infine, eseguite una fase shadow prima di cambiare il traffico di produzione. Acquisite le ragioni del rifiuto e confrontate il costo per asset accettato. Questo rivela se i guadagni del benchmark si traducono in meno revisioni anziché soltanto in prime impressioni esteticamente migliori.
Chi dovrebbe migrare — e chi dovrebbe aspettare
Nano Banana 2.1 è il candidato più forte quando un flusso di lavoro dipende dalla progettazione di infografiche, da scene con più personaggi, dalla composizione con più riferimenti, dalle modifiche basate su maschere o da costi inferiori per l’output immagine. Thinking merita priorità per grafica fattuale e attività complesse con più soggetti. Anche No Thinking merita di essere testato per generazione ed editing più semplici, specialmente quando il suo intervallo pubblicato si sovrappone a Thinking o quando il costo del ragionamento conta.
La migrazione dovrebbe attendere quando testo piccolo esatto, passaggi lunghi, rigorosa conservazione dell’identità, editing di regioni protette, precisione spaziale o fatti verificati non sono negoziabili e l’organizzazione non dispone di una fase di convalida esterna. Lo stesso vale quando l’automazione esistente dipende da function calling, esecuzione del codice o output strutturato non supportati.
Le discrepanze nella documentazione dovrebbero essere gestite in modo prudente: seguite i limiti correnti dell’endpoint scelto e misurate il comportamento osservato, anziché inferire la capacità dall’architettura più ampia del modello. Analogamente, l’attuale tabella delle deprecazioni elenca Gemini 3.1 Flash Image come deprecato, ma non annuncia una data di spegnimento. Non esiste una scadenza verificata del 29 ottobre che imponga un passaggio affrettato.
La decisione è quindi concreta. Eseguite la migrazione se Nano Banana 2.1 supera soglie di fedeltà specifiche per attività, riduce il costo per immagine accettata e soddisfa requisiti misurati di latenza e timeout. Usate Thinking solo dove il suo guadagno nel tasso di accettazione giustifica il costo aggiuntivo di output. Mantenete Nano Banana 2 o un’altra soluzione di fallback finché 2.1 non supera i test shadow. E per asset fattuali, sensibili all’identità o modificati con precisione, richiedete la convalida indipendentemente dal modello che guida il benchmark.


