Aktualizacja DeepSeek V4.1 Flash podnosi wyniki, ale dowody pozostają wewnątrz firmy

Weryfikacja źródeł z 19 października 2026 r.: DeepSeek-V4.1-Flash-1017 to aktualizacja z 17 października modelu V4.1 Flash wydanego we wrześniu. Poniższe wykresy opracowano niezależnie na podstawie karty modelu, ale same pomiary pochodzą od DeepSeek i nie są niezależną reprodukcją wyników. Aktualizacja nie zmieniła cen API. Tabela porównawcza nie ujawnia liczebności prób, przedziałów niepewności ani wyrównanych budżetów obliczeniowych różnych dostawców. — Źródło
DeepSeek wydał 17 października aktualizację DeepSeek V4.1 Flash, deklarując wyższe wyniki benchmarków, szybsze wykonywanie zadań i krótsze odpowiedzi. Punkt kontrolny o nazwie DeepSeek-V4.1-Flash-1017 zastępuje wrześniową wersję w aplikacji webowej DeepSeek, aplikacji mobilnej i API.
Najważniejszą zmianą nie jest nowa rodzina modeli ani architektura. DeepSeek opisuje 1017 jako niewielką aktualizację istniejącego modelu V4.1 Flash. Deweloperzy nadal wywołują deepseek-flash, a usługa kieruje żądania do nowego punktu kontrolnego bez konieczności migracji API.
Ta dyskretna podmiana tworzy główne napięcie. DeepSeek przedstawia lepszy stosunek wydajności do kosztów, szczególnie w przypadku agentów kodujących i pracy opartej na narzędziach. Opublikowane wyniki pozostają jednak raportowane przez firmę, a nie ujawniono kilku szczegółów ewaluacji potrzebnych do ścisłych porównań.
Liczby DeepSeek nadal zasługują na uwagę. Największe zyski widoczne są w pracy z terminalem, syntezie programów, automatyzacji i zadaniach obejmujących całe repozytoria oprogramowania. To obciążenia, w których Anthropic, OpenAI, Google, Moonshot AI i Zhipu AI rywalizują o przyjęcie przez deweloperów.
Aktualizacja wywiera więc presję na więcej niż rankingi benchmarków. Stanowi wyzwanie dla dostawców, by pokazali, że modele premium wykonują rzeczywiste zadania bardziej niezawodnie, przy mniejszej liczbie tokenów i mniejszej interwencji człowieka. DeepSeek wzmocnił swoją stronę tego argumentu, ale zewnętrzne testy muszą teraz określić, w jakim stopniu aktualizacja zmienia wyniki produkcyjne.
Aktualizacja DeepSeek V4.1 Flash to punkt kontrolny, a nie nowa architektura
DeepSeek ulepszył model stojący za istniejącym produktem, zamiast wprowadzać kolejną generację architektury.
W dzienniku zmian z października firma informuje, że DeepSeek V4.1 Flash został zaktualizowany do DeepSeek-V4.1-Flash-1017. Aplikacje webowa i mobilna korzystają teraz z nowej wersji, podobnie jak punkt końcowy API.
Obecni użytkownicy API nie potrzebują nowego identyfikatora modelu. Żądania wykorzystujące deepseek-flash trafiają do najnowszego punktu kontrolnego. Zgodnie z dokumentacją DeepSeek starsze identyfikatory wcześniejszych modeli Flash również kierują do bieżącej wersji.
Taki sposób dostarczania może sprawiać, że 1017 wygląda na mniejszą zmianę, niż jest w rzeczywistości. Stabilny punkt końcowy ogranicza nakład pracy związany z migracją, ale oznacza też, że zachowanie aplikacji może się zmienić bez zmiany nazwy modelu. Zespoły oceniające spójność wyników powinny rejestrować obsługiwany punkt kontrolny, a nie tylko identyfikator API.
Wydanie różni się od pierwotnej premiery V4.1 Flash z 10 września. Tamto wydanie wprowadziło architekturę rodziny modeli, natywne rozumienie obrazu, obsługę dłuższego kontekstu i zmieniony projekt inferencji. Październikowy punkt kontrolny aktualizuje model w ramach tego już ustanowionego fundamentu.
Architektura wykorzystuje projekt mixture-of-experts, czyli MoE. Takie podejście aktywuje tylko część znacznie większej sieci dla każdego tokenu, dążąc do zmniejszenia zapotrzebowania obliczeniowego przy zachowaniu szerokiej pojemności modelu.
DeepSeek ujawnił liczący 552 miliardy parametrów rdzeń dla wrześniowego modelu. Firma podała, że podczas przetwarzania wejścia aktywnych jest 8 miliardów parametrów, a podczas generowania wyjścia — 16 miliardów. Specyfikacje te opisują architekturę V4.1, a nie nową konfigurację parametrów wprowadzoną wraz z 1017.
Pierwotne wydanie opisywało także przyczynową architekturę encoder-decoder. Mówiąc prościej, model przydziela różną aktywną pojemność do rozumienia promptów i generowania odpowiedzi. DeepSeek przedstawia tę asymetrię jako sposób na poprawę przepustowości i zmniejszenie wymagań pamięciowych.
Jego raport techniczny opisuje obsługę kontekstów sięgających miliona tokenów. Okno kontekstowe to ilość materiału, którą model może uwzględnić w pojedynczym żądaniu. Aktualna dokumentacja DeepSeek wymienia również maksymalny limit wyjścia wynoszący 384 000 tokenów.
Limity te nie pojawiły się wraz z 1017. Nie pojawiło się wtedy także natywne rozumienie obrazu, które już wcześniej było częścią V4.1 Flash. Traktowanie tych możliwości jako październikowych dodatków zawyżałoby skalę zmian.
Zamiast tego 1017 wydaje się aktualizacją po treningu i zachowania modelu. DeepSeek twierdzi, że poprawia ona rozumowanie, kodowanie, pracę agentów i zadania wizualne, jednocześnie skracając czas działania i długość odpowiedzi. Firma nie opublikowała osobnej nowej liczby parametrów dla tego punktu kontrolnego.
Znaczenie ma również dystrybucja otwartego modelu. DeepSeek udostępnił punkt kontrolny przez swoje repozytorium modeli na licencji MIT. Daje to badaczom i zespołom infrastruktury dostęp do wag, z zastrzeżeniem praktycznych wymagań obsługi tak dużego modelu.
Otwarte wagi umożliwiają głębszą kontrolę. Nie sprawiają jednak, że niezależna ewaluacja staje się natychmiastowa lub tania. Odtworzenie benchmarków agentowych wymaga kompatybilnej infrastruktury, konfiguracji harnessów, dostępu do narzędzi, polityk ponawiania prób i znacznych zasobów obliczeniowych.
Rezultatem jest wydanie łatwo dostępne przez API, ale trudniejsze do kompleksowej walidacji. Ta luka wyjaśnia, dlaczego tabela benchmarków DeepSeek obecnie niesie główną część tej historii.
Benchmarki kodowania DeepSeek pokazują, gdzie aktualizacja przyniosła poprawę
Najsilniejsze raportowane wzrosty koncentrują się na zadaniach kodowania i agentowych, gdzie krótsze wykonanie może mieć równie duże znaczenie jak wyższa dokładność.
Największa zmiana w tych czterech testach programowania dotyczy Terminal-Bench 4.0: wynik rośnie z 31.2 do 42.3. To wzrost o 11.1 punktu, czyli około 35.6% względem poprzedniego wyniku. DeepSWE v1.1 poprawia się z 74.2 do 77.0. Obraz konkurencji jest niejednoznaczny: tabela dostawcy umieszcza Flash-1017 powyżej modelu oznaczonego Opus 5 w DeepSWE, ale poniżej w Terminal-Bench, ProgramBench i NL2Repo-Bench. Porównanie zachowuje dokładną nazwę ze źródła, Opus 5. Terminal-Bench używa Claude Code, a DeepSWE — Mini-SWE-V2. Tabela nie dowodzi porównania przy równych budżetach ani skuteczności w środowisku produkcyjnym.

Wykres redakcyjny na podstawie danych z karty DeepSeek z 17 października 2026 r. Wyższy zgłoszony wynik jest lepszy. Terminal-Bench: Claude Code; DeepSWE: Mini-SWE-V2. Tabela nie ujawnia daty oceny, liczebności prób, intensywności rozumowania, liczby ponowień ani wyrównanych budżetów tokenów i czasu. — Źródło
DeepSeek raportuje wynik 42.3 w Terminal-Bench 4.0 dla punktu kontrolnego 1017. Wrześniowy model V4.1 Flash uzyskał 31.2 w porównaniu firmy. Oznacza to wzrost o 11.1 punktu w opublikowanej przez DeepSeek konfiguracji.
Terminal-Bench ocenia agentów działających w środowiskach wiersza poleceń. Zadania te wymagają więcej niż napisania odizolowanej funkcji. Model musi interpretować cele, używać narzędzi, poruszać się po plikach, wykonywać polecenia i odzyskiwać sprawność po błędach.
Firma podaje, że testowała Terminal-Bench 4.0 za pośrednictwem frameworka Claude Code. Ten szczegół ma znaczenie, ponieważ framework agentowy kształtuje narzędzia, instrukcje i pętlę interakcji dostępne dla bazowego modelu.
W DeepSWE v1.1 DeepSeek raportuje wzrost z 74.2 do 77.0. Do tej ewaluacji użyto frameworka Mini-SWE-V2. Benchmarki inżynierii oprogramowania mogą być bardzo wrażliwe na konfigurację repozytorium, uprawnienia narzędzi i liczbę dozwolonych prób.
ProgramBench pokazuje większy skok liczbowy, z 20.3 do 29.1. NL2Repo-Bench rośnie z 65.4 do 68.2. Ten drugi koncentruje się na przekładaniu żądań w języku naturalnym na zmiany w repozytoriach oprogramowania.
Wzorzec sugeruje, że DeepSeek celował w długotrwałe przepływy pracy związane z kodowaniem, a nie wyłącznie w programowanie o krótkich odpowiedziach. To rozróżnienie ma znaczenie dla firm testujących agentów na kolejkach zgłoszeń, zadaniach przeglądu kodu, migracjach i sesjach debugowania.
Benchmarki agentowe pokazują podobny kierunek. DeepSeek raportuje 60.5 w Automation-Bench v1.0.6, wobec 54.8 dla poprzedniego punktu kontrolnego. Agents’ Last Exam wzrasta z 31.8 do 35.4.
Apex Bench v1.1 przesuwa się z 64.6 do 72.1 w tabeli firmy. DeepSeek przedstawia te wyniki jako dowód, że aktualizacja może obsługiwać dłuższe sekwencje obejmujące planowanie, użycie narzędzi i wykonanie.
Wzrosły także wyniki agentów wizualnych. Chartography z narzędziami wzrosło z 78.9 do 83.0, a BabyVision z 89.6 do 92.5. ZeroBench-main z narzędziami wzrosło z 49.0 do 51.0.
DeepSeek podaje, że ZeroBench-main używał Pass@5. Ta metryka dopuszcza do pięciu prób i odnotowuje, czy przynajmniej jedna zakończyła się sukcesem. Nie należy jej odczytywać jako bezpośredniego odpowiednika wskaźnika sukcesu przy pierwszej próbie.
Firma raportuje również 42.6 w Humanity’s Last Exam bez narzędzi. Wymienia 44.0 dla podzbioru czysto tekstowego, choć wynik podzbioru nie powinien zastępować wyniku szerszej ewaluacji.
Zyski benchmarkowe są spójne we wszystkich porównaniach z poprzednim modelem opublikowanych w tabeli. Żaden wymieniony wynik nie pokazuje, by punkt kontrolny 1017 pozostawał za wrześniową wersją. Ta spójność wspiera twierdzenie DeepSeek, że aktualizacja jest ogólnie lepsza w ramach wybranych przez firmę ewaluacji.
Tabela nie ujawnia jednak wielkości próbek dla kilku porównań. Pomija także sprzęt, budżety tokenów, limity czasu, budżety ponawiania prób i ustawienia intensywności rozumowania. Zmienne te mogą istotnie wpływać na ewaluacje agentów.
Model, któremu zezwolono na więcej wywołań narzędzi lub więcej tokenów rozumowania, może ukończyć zadania, których nie realizuje przy bardziej restrykcyjnej konfiguracji. Może też zużyć więcej czasu i zasobów, osiągając lepszy wynik.
DeepSeek twierdzi, że nowy punkt kontrolny skraca zarówno czas działania, jak i długość wyjścia. To kluczowe twierdzenie, ponieważ krótsze wyjście może ograniczyć ilość generowanego tekstu, który aplikacja musi przetworzyć. Szybsze ukończenie może też poprawić doświadczenie użytkownika i przepustowość agentów.
Materiały dotyczące wydania nie podają jednak jednego uniwersalnego procentu dla żadnej z tych redukcji. Czas działania zależy od obciążenia, infrastruktury, długości kontekstu i frameworka agentowego. Długość wyjścia zmienia się wraz z promptami i złożonością zadania.
Odpowiedzialna interpretacja jest więc wąska. DeepSeek raportuje lepsze wyniki, szybsze wykonanie i krótsze odpowiedzi w swoich ocenianych harnessach. Dokładna poprawa w środowisku produkcyjnym pozostaje zależna od obciążenia.
Krótsze odpowiedzi są prawdziwą presją konkurencyjną
DeepSeek argumentuje, że użyteczną wydajność AI należy mierzyć liczbą ukończonych zadań, a nie wyłącznie surowymi wynikami inteligencji.
DeepSeek podaje wzrost z 54.8 do 60.5 w Automation-Bench v1.0.6, z 31.8 do 35.4 w Agents’ Last Exam oraz z 64.6 do 72.1 w Apex Bench v1.1. Flash-1017 przewyższa wynik Opus 5 z tabeli we wszystkich trzech testach, choć każdy benchmark mierzy inny zestaw zadań. Wyniki uzasadniają dalszą ocenę zastosowań agentowych, ale nie dowodzą niezawodnego działania w środowisku bez ograniczeń. Operatorzy powinni mierzyć na własnych zadaniach skuteczne ukończenia, łączną liczbę ponowień, błędy narzędzi, czas weryfikacji i całkowity koszt tokenów. DeepSeek zaleca dla tego wydania Harness 0.2.1-rc.1 lub nowszy.

Wykres redakcyjny trzech odrębnych benchmarków agentowych przeprowadzonych przez DeepSeek dla wydania z 17 października 2026 r.; wyższy wynik jest lepszy. Tabela nie ujawnia dokładnego wysiłku obliczeniowego różnych dostawców, budżetów tokenów i czasu, liczebności prób ani daty oceny. Trzech wyników nie należy łączyć w jeden wynik ogólny. — Źródło
Kupujący modele coraz częściej zwracają uwagę na to, ile udanych przepływów pracy system realizuje w ramach budżetu i limitu czasu. Wysoki wynik benchmarku traci wartość, gdy model zapętla się, tworzy niepotrzebne wyjaśnienia lub wielokrotnie wywołuje narzędzia.
Zadania agentowe wzmacniają ten problem. Asystent programistyczny może wygenerować tysiące tokenów, eksplorując niewłaściwą ścieżkę. Może też tracić czas na ponowne czytanie plików lub próby poprawek, które nie rozwiązują podstawowego problemu.
Twierdzenie DeepSeek o krótszym wyjściu jest bezpośrednio wymierzone w tę nieefektywność. Jeśli 1017 osiąga ten sam lub lepszy rezultat przy mniejszej liczbie wygenerowanych tokenów, może jednocześnie ograniczyć opóźnienia i koszty operacyjne. To ma większe znaczenie niż sama zwięzłość prozy.
Firma nazywa tę zmianę poprawą Pareto w relacji wydajności do kosztu. Poprawa Pareto oznacza, że jedna opcja staje się lepsza w co najmniej jednym istotnym wymiarze, nie pogarszając się w innych mierzonych wymiarach.
W tym przypadku DeepSeek deklaruje wyższą wydajność benchmarkową przy krótszym czasie działania i krótszym wyjściu. Argument polega na tym, że deweloperzy nie muszą już w takim stopniu wymieniać możliwości na szybkość lub efektywność.
Dostępne dowody wspierają stronę wydajnościową w ramach tabeli ewaluacyjnej DeepSeek. Nie potwierdzają w pełni strony kosztu na udane zadanie, ponieważ firma nie opublikowała szczegółowych pomiarów zasobów na poziomie zadań.
Aktualne specyfikacje modelu pokazują, że Flash-1017 zachowuje istniejącą konfigurację usługi. Zarówno tryby z rozumowaniem, jak i bez niego pozostają dostępne, podobnie jak wywołania narzędzi, wyjście JSON, przetwarzanie obrazu i kompatybilne formaty API.
Niezmieniony punkt końcowy ogranicza również tarcie wdrożeniowe. Zespół może przetestować nowe zachowanie bez przepisywania integracji. Ta zaleta może przyspieszyć wdrożenie, zwłaszcza wśród deweloperów już korzystających z DeepSeek Flash.
Tworzy także ryzyko operacyjne. Aplikacje zbudowane wokół stabilnego tonu, struktury wyjścia lub zachowania odmowy mogą źle reagować na dyskretną zmianę punktu kontrolnego. Testy regresji stają się niezbędne, gdy hostowany model zmienia się za stałą nazwą.
W przypadku platform programistycznych natychmiastowa presja dotyczy modeli sprzedawanych jako premium pod względem niezawodności. Tabela DeepSeek porównuje 1017 z K3, GLM-5.3, GPT-5.6 Sol i modelem oznaczonym jako Opus 5.
Etykiety te muszą być raportowane dokładnie tak, jak podaje je DeepSeek. Tabela nie ocenia każdego aktualnego modelu każdej firmy. Jej oznaczenia Opus 5 nie należy po cichu zamieniać na inne wydanie Anthropic.
Punkt kontrolny DeepSeek przewyższa referencję Opus 5 z tabeli w DeepSWE v1.1, Automation-Bench, Agents’ Last Exam i Apex Bench. Ustępuje tej referencji w Terminal-Bench, ProgramBench, NL2Repo-Bench oraz trzech wymienionych testach wizualnych.
Ten mieszany wynik jest bardziej miarodajny niż proste stwierdzenie o zwycięstwie. DeepSeek wygląda na szczególnie konkurencyjny w kilku ocenach agentów, lecz własna tabela producenta nie pokazuje, by prowadził w każdej kategorii.
Presja na rywali wynika z całego pakietu. DeepSeek łączy dostępne wagi, stabilną ścieżkę API, duże okno kontekstowe, wejście multimodalne i rosnące wyniki agentów. Każdy z tych elementów zwiększa liczbę zespołów skłonnych go przetestować.
Wrześniowa premiera przedstawiała już wydajność jako cel architektoniczny. DeepSeek podał, że V4.1 Flash wykorzystywał jedną czwartą pamięci o wysokiej przepustowości i jedną ósmą pamięci masowej SSD na swój cache klucz-wartość.
Cache klucz-wartość przechowuje informacje wygenerowane podczas inferencji, dzięki czemu model nie musi ponownie obliczać wszystkiego dla każdego nowego tokena. Mniejsze cache mogą zmniejszać obciążenie pamięci przy długich promptach i powtarzanych interakcjach z agentami.
Te twierdzenia architektoniczne dotyczą rodziny V4.1 Flash. Październikowa historia polega na tym, że DeepSeek twierdzi, iż post-training zwiększył skuteczność istniejącej architektury. Firma nie ogłosiła kolejnego przeprojektowania cache wraz z 1017.
To rozróżnienie jest istotne dla kupujących. Architektura wyjaśnia, dlaczego obsługa modelu może być ekonomiczna. Zachowanie punktu kontrolnego decyduje o tym, czy dokładnie i wydajnie realizuje on rzeczywiste zadania nabywcy.
Zespoły oceniające aktualizację powinny zatem mierzyć ukończoną pracę, a nie tylko wygenerowane tokeny. Powinny śledzić udane zmiany, zaakceptowane wyniki, poprawki wprowadzane przez ludzi, czas realizacji i ponowne próby w reprezentatywnych przepływach pracy.
Taka ocena może zostać włączona do szerszych przepływów pracy AI. Kluczowym krokiem jest zachowanie promptów, materiałów źródłowych, wyników i decyzji recenzenckich do późniejszego porównania.
Czego tabela benchmarków nie dowodzi
Wyniki DeepSeek są istotnym dowodem kierunku rozwoju inżynieryjnego firmy, lecz nie stanowią niezależnego potwierdzenia niezawodności produkcyjnej.
Wyniki zadań wizualnych z narzędziami poprawiają się, lecz nie pokazują przewagi we wszystkich testach. Chartography rośnie z 78.9 do 83.0, BabyVision z 89.6 do 92.5, a ZeroBench-main z 49.0 do 51.0. Wyniki Opus 5 w źródle pozostają wyższe: 84.0, 94.1 i 52.0. Są to oceny z dostępem do narzędzi, więc nie oznaczają surowej dokładności na samych obrazach. ZeroBench-main używa Pass@5, co pozwala na wiele prób; nie należy przedstawiać tego wyniku jako niezawodności pierwszej próby. Przy działaniach o istotnych konsekwencjach agenty wizualne nadal wymagają odpowiednich uprawnień narzędzi, obsługi błędów i kontroli człowieka.

Oceny wizualne z narzędziami przeprowadzone przez DeepSeek dla wydania z 17 października 2026 r.; wyższy wynik jest lepszy. ZeroBench-main stosuje Pass@5. Tabela nie ujawnia pozostałych limitów prób, liczebności prób, przedziałów niepewności, wyrównanych budżetów ani daty oceny. — Źródło
Głównym ograniczeniem jest niezależność źródeł. DeepSeek opublikował porównanie i wybrał modele, benchmarki, środowiska wykonawcze oraz konfiguracje. Źródła pierwotne sprawdzone na potrzeby tego artykułu nie zawierają niezależnie odtworzonego wyniku dla dokładnego checkpointu 1017.
Nie oznacza to, że wyniki są fałszywe. Oceny producenta często stanowią pierwszy dostępny dowód po premierze modelu. Mogą pokazać, gdzie firma inwestowała i które obciążenia robocze spodziewa się poprawić.
Nie mogą jednak rozstrzygnąć każdego porównania. Benchmarki agentów zawierają więcej zmiennych niż standardowe testy pytań i odpowiedzi. Prompt systemowy frameworka, narzędzia, limit czasu, sandbox i logika ponownych prób mogą zmienić końcowy wynik.
DeepSeek ujawnia część warunków. Terminal-Bench korzystał z Claude Code, DeepSWE z Mini-SWE-V2, a ZeroBench-main z Pass@5. Firma rekomenduje również DeepSeek Harness w wersji 0.2.1-rc.1 lub nowszej.
Ta rekomendacja sugeruje, że integracja z harnessem jest częścią historii wyników. DeepSeek twierdzi, że zoptymalizował model pod własny harness, Tencent CodeBuddy, WorkBuddy i inne platformy.
Usprawnienia modelu i harnessu są równie uzasadnione. Kupujący muszą jednak wiedzieć, czy korzyści przenoszą się między środowiskami. Punkt kontrolny dostrojony do jednej pętli agenta może działać inaczej w warstwie orkiestracji innej firmy.
Brak ujawnionych ustawień rozumowania zwiększa niepewność. DeepSeek obsługuje wiele poziomów wysiłku myślowego, które wpływają na ilość wewnętrznych obliczeń przeznaczonych na żądanie. Wyższe ustawienie może poprawić wyniki, zwiększając jednocześnie opóźnienie lub zużycie tokenów.
Szczegóły sprzętowe również mają znaczenie dla deklaracji dotyczących szybkości. Czas działania w usłudze hostowanej nie przekłada się bezpośrednio na inferencję hostowaną samodzielnie. Narzut sieciowy, batchowanie, kwantyzacja i wybór akceleratora mogą dominować obserwowane opóźnienie.
Otwarte wagi umożliwiają testowanie tych kwestii, lecz samodzielne hostowanie nie jest automatycznie proste. Szkielet o 552 miliardach parametrów stawia wysokie wymagania dotyczące pamięci i przechowywania, nawet gdy na token aktywuje się tylko część sieci.
Kwantyzacja redukuje zużycie pamięci przez przechowywanie wag z niższą precyzją numeryczną. Może uczynić wdrożenie bardziej praktycznym, ale wyniki mogą różnić się od oficjalnej konfiguracji punktu kontrolnego. Zespoły powinny sprawdzić dokładność po każdej konwersji.
Bezpieczeństwo stanowi kolejne zagadnienie produkcyjne. Agenci programistyczni często odczytują repozytoria, wykonują polecenia, instalują pakiety i modyfikują pliki. Lepszy wynik benchmarku nie dowodzi, że model może bezpiecznie otrzymać szerokie uprawnienia.
Organizacje powinny izolować pracę agentów, ograniczać poświadczenia, rejestrować wywołania narzędzi i wymagać przeglądu wrażliwych zmian. Te zabezpieczenia dotyczą każdego modelu programistycznego, niezależnie od pozycji w benchmarkach.
Ta sama ostrożność dotyczy okna kontekstowego o milionie tokenów. Obsługa dużego kontekstu nie gwarantuje niezawodnego wyszukiwania informacji z każdej pozycji. Długie prompty mogą wprowadzać rozproszenie, sprzeczne instrukcje i niepotrzebne przetwarzanie.
Natywna obsługa obrazu przez DeepSeek również poprzedza październikową aktualizację. Wyższe wyniki wizualnych agentów sugerują lepsze wykorzystanie tej możliwości, ale nie dowodzą jednakowej niezawodności w przypadku wykresów, interfejsów, dokumentów i obrazów naturalnych.
Kontekst historyczny wzmacnia potrzebę wyważonych twierdzeń. Premiera V4 DeepSeek przyciągnęła uwagę, ponieważ połączyła obsługę dużego kontekstu z architekturą ukierunkowaną na wydajność. Niezależni analitycy cytowani we wcześniejszym materiale uznali tę rodzinę za konkurencyjną wobec czołowych modeli amerykańskich.
Ta szersza konkurencyjność nie potwierdza automatycznie dokładnych ulepszeń nowego punktu kontrolnego. Wagi 1017 wymagają własnych testów, zwłaszcza w obciążeniach przypominających rzeczywiste wdrożenia.
Praktyczna ocena powinna porównywać oba punkty kontrolne przy identycznych promptach i narzędziach. Powinna zachowywać temperaturę, ustawienia wysiłku, limity czasu, liczbę ponownych prób i stany repozytoriów.
Recenzenci powinni również oceniać jakość wyników po usunięciu przewag wynikających z rozwlekłości. Krótsza odpowiedź jest użyteczna, jeśli pozostaje kompletna. Staje się regresją, jeśli pomija testy, zastrzeżenia, kroki migracji lub wyjaśnienia błędów.
W pracy z wiedzą zwięzłość może tworzyć podobne kompromisy. Krótkie podsumowania skracają czas czytania, ale skondensowane odpowiedzi mogą ukrywać niepewność lub pomijać dowody mniejszościowe. Przegląd człowieka pozostaje konieczny przy istotnych decyzjach.
Właściwy sceptycyzm powinien być zatem konkretny. DeepSeek opublikował wiarygodne dowody własne na poprawę. Nie wykazał jeszcze uniwersalnych zysków szybkości, niższego całkowitego kosztu zadania ani większej niezawodności w niezależnych środowiskach produkcyjnych.
Trzy sygnały pokażą, czy Flash-1017 zmieni rynek
Niezależne odtworzenie wyników, działanie w różnych harnessach i trwała adopcja przez deweloperów zdecydują, czy 1017 stanie się czymś więcej niż mocną premierą benchmarkową producenta.
Aktualizacja z 17 października zastępuje checkpoint udostępniany pod aliasem API deepseek-flash, zachowując ceny. Według weryfikacji z 19 października milion tokenów Flash poza szczytem kosztuje 0.003 USD za wejście z pamięci podręcznej, 0.15 USD za wejście bez pamięci podręcznej i 0.60 USD za wyjście; w szczycie stawki wynoszą 0.006, 0.30 i 1.20 USD. Dla wyraźnie hipotetycznego zadania z milionem tokenów wejścia bez pamięci podręcznej, czterema milionami z pamięci podręcznej i 100000 tokenów wyjścia sama opłata za tokeny modelu wynosi 0.222 USD poza szczytem lub 0.444 USD w szczycie. Obliczenie pomija opłaty za wyszukiwanie i pobieranie, infrastrukturę, ponowienia oraz weryfikację człowieka. Krótsze wyjście może zmniejszyć opłatę za wyjście, ale deklaracja DeepSeek o szybkości i kosztach nie oznacza stałej oszczędności dla każdego obciążenia.
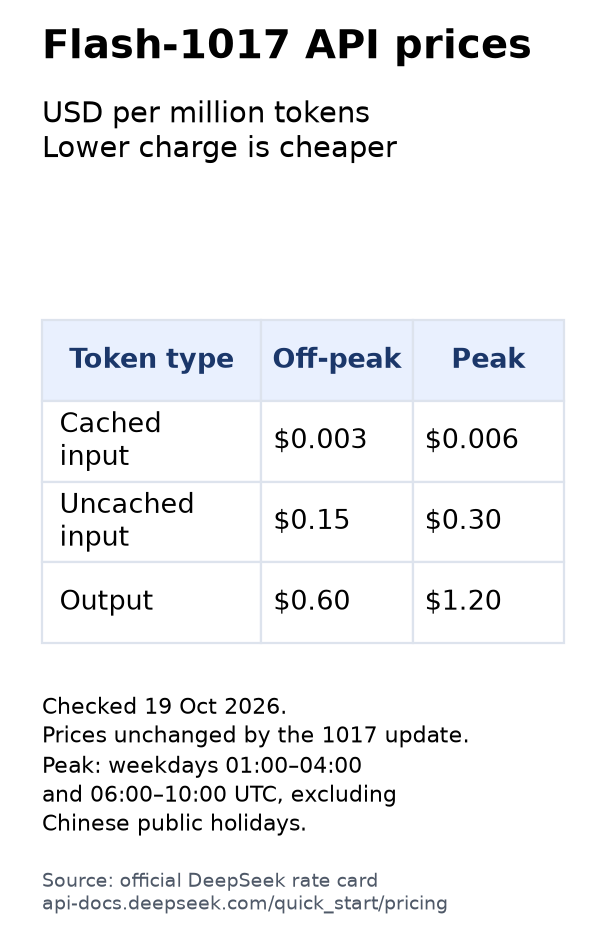
Oficjalny cennik Flash-1017 sprawdzony 19 października 2026 r., w dolarach amerykańskich za milion tokenów; niższa opłata oznacza niższy koszt. Godziny szczytu przypadają w dni robocze 01:00–04:00 oraz 06:00–10:00 UTC, z wyłączeniem chińskich świąt ustawowych. Ceny tokenów modelu są odrębne od wyszukiwania, pobierania i pozostałych kosztów operacyjnych. — Źródło
Pierwszym sygnałem jest niezależna ocena dokładnego punktu kontrolnego 1017. Badacze muszą testować opublikowane wagi, a nie wrześniowy model czy hostowany alias o niepewnej wersji.
Testy te powinny publikować prompty, wersje harnessów, ustawienia wysiłku, sprzęt, limity czasowe i zasady ponownych prób. Wyniki powinny obejmować dokładność, czas realizacji, tokeny wyjściowe oraz zachowanie przy nieudanych zadaniach.
Odtworzenie kierunku wyników raportowanych przez DeepSeek wzmocniłoby argumentację firmy. Duże regresje lub korzyści silnie zależne od konfiguracji osłabiłyby ją. Mieszane wyniki sugerowałyby, że 1017 przynosi korzyści niektórym pętlom agentów bardziej niż innym.
Drugim sygnałem jest wydajność w wielu harnessach. DeepSeek celowo zoptymalizował model dla wybranych platform, co czyni przenośność centralnym pytaniem. Model powinien zachować swoje korzyści w alternatywnych agentach programistycznych i systemach orkiestracji przedsiębiorstw.
Testy między harnessami mogą oddzielić poprawę modelu od poprawy integracji. Obie mają wartość, lecz odpowiadają na różne pytania zakupowe.
Firma wdrażająca DeepSeek Harness może skorzystać z połączonego systemu. Firma zachowująca istniejącego wewnętrznego agenta potrzebuje dowodów, że sam punkt kontrolny usprawnia jej przepływ pracy.
Warto obserwować, czy testy stron trzecich odtworzą wzrost w Terminal-Bench bez modyfikowania dostępu do narzędzi. Warto też sprawdzać, czy krótsze wyniki pozostają kompletne, gdy inny framework używa odmiennego promptu systemowego.
Spójne zyski wspierałyby twierdzenie DeepSeek o lepszym bazowym punkcie kontrolnym. Zyski ograniczone do preferowanych harnessów sprawiłyby, że wybór integracji stałby się większą częścią decyzji.
Trzecim sygnałem jest trwała adopcja przez deweloperów po początkowym cyklu premiery. Pobrania, integracje, odtwarzalne testy i studia przypadków z produkcji mają większe znaczenie niż uwaga z tygodnia premiery.
Wagi na licencji MIT zmniejszają przeszkody prawne dla eksperymentowania. Skala modelu podnosi jednak próg infrastrukturalny dla poważnego samodzielnego hostowania. Wiele zespołów nadal wybierze dostęp hostowany lub wyspecjalizowanych dostawców inferencji.
Adopcję należy więc mierzyć w obu modelach dostępu. Korzystanie z wersji hostowanej pokazuje, czy doświadczenie API jest atrakcyjne. Wdrożenia hostowane samodzielnie pokazują, czy otwarty dostęp tworzy praktyczne alternatywy dla organizacji o wyspecjalizowanych wymaganiach.
Retencja jest ważniejsza niż próby. Deweloperzy często testują nowe modele, ponieważ zmiana identyfikatora API jest łatwa. Zachowują model tylko wtedy, gdy poprawia akceptowaną pracę bez tworzenia nowych obciążeń związanych z przeglądem.
Prawdopodobnym krótkoterminowym skutkiem będą szersze testy, a nie natychmiastowa zmiana układu rynku. DeepSeek dał zespołom pracującym nad agentami programistycznymi konkretny powód, aby ponownie uruchomić ich oceny. Najsilniejsze raportowane zyski odpowiadają zadaniom, których deweloperzy już mają trudność niezawodnie automatyzować.
Konkurenci nadal mogą odpowiedzieć lepszymi modelami, mocniejszymi frameworkami agentów, niższymi opóźnieniami, bezpieczniejszym wykonywaniem lub bardziej przewidywalnym zachowaniem. Własna tabela DeepSeek pokazuje, że punkt kontrolny 1017 nie prowadzi w każdym porównaniu.
Premiera pokazuje także szybsze tempo konkurencji. We wrześniu pojawiła się duża architektura, a pięć tygodni później punkt kontrolny skoncentrowany na zachowaniu. Stabilne trasowanie API pozwala DeepSeek natychmiast udostępnić to ulepszenie.
To tempo przynosi użytkownikom korzyści, gdy aktualizacje dają mierzalne zyski. Utrudnia zarządzanie, gdy zachowanie zmienia się szybciej niż cykle oceny w przedsiębiorstwach. Zespoły potrzebują rejestrów wersji i cyklicznych zestawów testów regresyjnych, aby zarządzać oboma skutkami.
Dla deweloperów decyzja jest prosta. Przetestuj DeepSeek-V4.1-Flash-1017 na dokładnie tych zadaniach, które wykonują Twoi użytkownicy. Mierz zaakceptowane wyniki, ponowne próby, opóźnienia, długość odpowiedzi i poprawki wprowadzane przez ludzi.
Kupujący korporacyjni powinni pytać dostawców o identyfikatory punktów kontrolnych i powiadomienia o zmianach. Powinni też wymagać odtwarzalnych warunków oceny, zanim potraktują przewagę w benchmarku jako podstawę decyzji zakupowej.
Pracownicy wiedzy powinni zwracać uwagę na to, czy krótsze odpowiedzi zachowują dowody i niuanse. Szybsza odpowiedź ma niewielką wartość, gdy ktoś musi później odtwarzać brakujące rozumowanie.
Aktualizacja DeepSeek V4.1 Flash już zmieniła zestaw porównawczy. Podnosi wyniki poprzedniego punktu kontrolnego w programowaniu i zadaniach agentowych, zachowując tę samą ścieżkę dostępu i rodzinę modelu.
To, co wydarzy się dalej, zależy od dowodów spoza laboratorium DeepSeek. Przeprowadzaj kontrolowane porównania, zachowuj pełny zapis oceny i obserwuj, czy niezależne testy odtworzą deklarowane połączenie dokładności, szybkości i zwięzłości.


