Nano Banana 2.1: Co ujawniają benchmarki obrazów Google


Google udostępniło Nano Banana 2.1 6 października 2026 roku. Ta analiza, datowana na 14 października, traktuje ją jako kontynuację tamtej premiery — nie jako dzisiejsze nowe wydanie.
Opublikowane wyniki stanowią wiarygodną podstawę, by uznać, że Nano Banana 2.1 przewyższa Nano Banana 2 w kilku zadaniach generowania i edycji obrazów. Największe raportowane przewagi dotyczą projektowania infografik, spójności wielu postaci, edycji opartej na maskach oraz pracy z wieloma referencjami. Włączenie Thinking zazwyczaj zapewnia najwyższe wyniki, choć jego wartość różni się zależnie od zadania.
Wnioski te wymagają jednak ostrożnego zdefiniowania granic. Większość wyników to oparte na preferencjach oceny Elo, a nie odsetki poprawnych obrazów. Google podaje zakresy błędu dla wyników Elo, lecz nie określa poziomu ich ufności. Nie ujawnia liczby próbek, promptów benchmarkowych, rozdzielczości obrazów, budżetów ponownych prób, szczegółowych ustawień Thinking ani warunków równych zasobów obliczeniowych w tabeli karty modelu. Wynik dotyczący zgodności faktograficznej pochodzi od automatycznego oceniającego, a nie z pomiaru dokładności przez ludzi.
W konsekwencji benchmarki są użytecznym dowodem względnej wydajności w ramach oceny Google, ale nie potwierdzają niezawodności produkcyjnej, opóźnień ani zwrotu z inwestycji. Zespoły rozważające migrację nadal potrzebują testów specyficznych dla własnych obciążeń, z kontrolowanymi danymi wejściowymi, kryteriami awarii i pełnymi kosztami żądań.
Co Google rzeczywiście udostępniło 6 października
Nano Banana 2.1 to zaktualizowany model Google klasy Flash do generowania obrazów i konwersacyjnej edycji. Stabilny kod modelu Gemini API to gemini-nano-banana-2.1. Google opisuje go jako aktualizację Gemini 3.1 Flash Image, znanego także jako Nano Banana 2, oraz jako wydajniejszy odpowiednik Gemini 3 Pro Image, powszechnie nazywanego Nano Banana Pro. Dziennik zmian Gemini API odnotowuje jego ogólną dostępność od 6 października 2026 roku.
Zgodnie z kartą modelu Nano Banana 2.1, model opiera się na Gemini 3.6 Flash i przyjmuje tekst oraz obrazy, zwracając obrazy i tekst. Google pozycjonuje go do kontrolowanego tworzenia obrazów, edycji, grafiki z dużą ilością tekstu, lokalizowanego renderowania i iteracyjnych procesów pracy. Jego ewaluacja łączy porównawcze oceny preferencji ludzi dotyczące generowania i edycji z jednostronną automatyczną oceną zgodności faktograficznej.
Karta wskazuje również konkretne ograniczenia: mały lub długi tekst może się rozmywać lub rozpadać; tożsamość może ulegać zmianom; edycje maskowane mogą zachowywać ślady rysunku lub tylko częściowo wykonywać instrukcje; pozy mogą nieoczekiwanie się utrzymywać; relacje przestrzenne, takie jak lewo i prawo, mogą być mylone; a wiedza o świecie, rozumowanie 3D i zgodność faktograficzna pozostają niedoskonałe. Przyznano także możliwość okazjonalnych spowolnień i przekroczeń czasu. To ryzyka operacyjne, a nie przypisy: każde z nich wymaga testu akceptacyjnego i polityki awaryjnej przed wdrożeniem.
Dokumentacja modelu API Google dodaje szczegóły implementacyjne. Dane wyjściowe domyślnie mają rozdzielczość 1K i można zażądać rozdzielczości do 4K. Thinking oferuje ustawienia minimal, medium — domyślne — oraz high. Model obsługuje grounding z wyszukiwaniem, ale nie wywoływanie funkcji, wykonywanie kodu ani ustrukturyzowane dane wyjściowe.
Karta modelu podaje kontekst do jednego miliona tokenów i wyjście tekstowe do 64K, natomiast strona wdrożonego interfejsu Gemini API podaje 131,072 tokenów wejściowych i 32,768 tokenów wyjściowych. Publiczne dokumenty nie wyjaśniają relacji między tymi różnymi limitami. Wdrażający powinni stosować udokumentowane limity konkretnego wywoływanego punktu końcowego, zamiast zakładać, że większe wartości z karty modelu są dostępne za pośrednictwem tego API.
Elo dla generowania wskazuje przewagę, a nie wskaźnik dokładności
Google przedstawia dwa oceniane przez ludzi porównania text-to-image: ogólną preferencję i projektowanie infografik. W obu Nano Banana 2.1 z Thinking zajmuje pierwsze miejsce, następnie Nano Banana 2.1 bez Thinking, Nano Banana 2 Thinking i Nano Banana Pro.
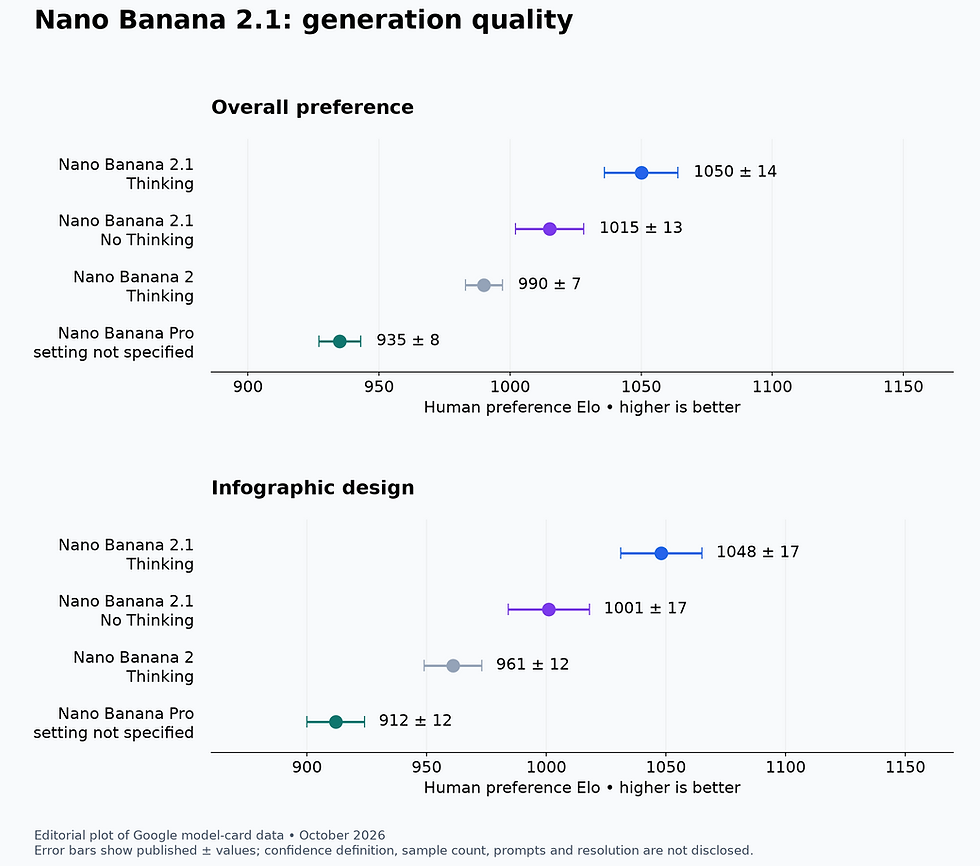
Redakcyjny wykres danych liczbowych opublikowanych w karcie modelu Nano Banana 2.1 Google DeepMind, październik 2026. Wyższe Elo wskazuje silniejszą względną preferencję ludzi w porównaniach Google; słupki błędu pokazują opublikowane zakresy ±, których definicji ufności nie podano. Nie jest to oryginalny obraz Google, a Elo nie oznacza procentowej dokładności.
Dla ogólnej preferencji Nano Banana 2.1 Thinking uzyskało 1050 ±14, wobec 1015 ±13 bez Thinking, 990 ±7 dla Nano Banana 2 Thinking i 935 ±8 dla Pro. Dla projektowania infografik odpowiadające wyniki to 1048 ±17, 1001 ±17, 961 ±12 i 912 ±12.
Kolejność jest spójna, a kilka różnic jest większych niż pokazane zakresy. W szczególności oba tryby Nano Banana 2.1 plasują się powyżej Nano Banana 2 w projektowaniu infografik nawet po uwzględnieniu opublikowanych przedziałów. To istotny dowód przewagi preferencji w ramach tej ewaluacji. Nie jest to dowód, że 2.1 wygra dla każdego promptu, wygeneruje poprawną infografikę lub będzie wymagać mniej ponownych prób w produkcji.
Thinking wydaje się tu korzystne. Jego 35-punktowa przewaga w ogólnej preferencji nad No Thinking ma niepokrywające się pokazane przedziały: 1036–1064 wobec 1002–1028. Przedziały projektowania infografik stykają się przy 1031, więc wykres wskazuje przewagę, ale nie precyzyjny uniwersalny rozmiar efektu. Google oznacza też konfigurację benchmarku wyłącznie jako „Thinking”. Nie ujawnia, czy test korzystał z minimalnego, średniego, wysokiego, adaptacyjnej polityki czy innego wewnętrznego ustawienia.
To pominięcie ogranicza wnioski dotyczące kosztów i opóźnień. Wyższego wyniku Thinking nie można przełożyć na „zawsze włączaj wysokie Thinking” bez zmierzenia wpływu każdego dostępnego ustawienia na konkretny proces pracy. Tabela benchmarków nie zawiera pomiarów opóźnień, a ta analiza nie powinna ich wymyślać.
Praktyczny sygnał jest węższy: zespoły, których użytkownicy oceniają kompozycję, wizualne dopracowanie lub układ infografik, powinny traktować Nano Banana 2.1 Thinking jako poważnego kandydata. Zespoły generujące dekoracyjne zasoby niskiego ryzyka mogą uznać No Thinking za wystarczające, ale ta decyzja powinna wynikać z kontrolowanego testu wykorzystującego ich własne prompty i progi akceptacji.
Spójność się poprawia, ale wynik dla pojedynczej postaci jest zbliżony
Spójność jest często cenniejsza niż sama atrakcyjność w przypadku powracających postaci, wariantów kampanii, storyboardów, materiałów wyjaśniających produkty i edycji wieloturowej. Google rozdziela spójność pojedynczej postaci i wielu postaci, a te dwa wyniki opowiadają różne historie.

Redakcyjny wykres danych z października 2026 roku z karty modelu Google DeepMind dotyczących spójności pojedynczej postaci i wielu postaci. Wyższe Elo oznacza większą względną preferencję ludzi; opublikowane zakresy ± są pokazane bez określonej definicji ufności. Istotne jest niemal pełne nakładanie się wyników Nano Banana 2.1 Thinking i No Thinking dla spójności pojedynczej postaci. Nie jest to oryginalny obraz Google.
W przypadku spójności pojedynczej postaci Nano Banana 2.1 Thinking osiąga 1028 ±14, a No Thinking 1021 ±14. Ich pokazane przedziały znacząco się pokrywają, od 1014 do 1035. Dlatego przedstawianie siedmiopunktowej różnicy jako potwierdzonej praktycznej przewagi byłoby nieuzasadnione. Obie konfiguracje 2.1 uzyskują wyższe wyniki niż Nano Banana 2 Thinking z 981 ±10 i Pro z 991 ±9, ale benchmark nie pokazuje, czy awarie dotyczyły twarzy, ubioru, proporcji ciała, akcesoriów czy dryfu stylu.
Wynik dla wielu postaci jest bardziej zróżnicowany. Thinking uzyskuje 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10, a Nano Banana 2 Thinking 978 ±10. Przedziały 2.1 Thinking i No Thinking nie nakładają się. Sugeruje to, że dodatkowe rozumowanie może być bardziej przydatne, gdy scena wymaga śledzenia przez system kilku tożsamości i ich relacji.
Mimo to „obsługuje do czterech postaci” nie oznacza „niezawodnie zachowuje cztery tożsamości”. Dokumentacja API mówi, że fuzja wielu obrazów przyjmuje do 14 obrazów referencyjnych, w tym do czterech postaci i dziesięciu obiektów. Są to limity wejściowe, a nie gwarancje wierności. Nie ujawniają, jak wydajność zmienia się, gdy referencje stają się wizualnie podobne, sprzeczne, przycięte, niskiej rozdzielczości lub nierównomiernie oświetlone.
Ocena produkcyjna powinna punktować każdy podmiot oddzielnie. Przydatne etykiety awarii obejmują dryf twarzy, przeniesienie garderoby, przenikanie atrybutów między postaciami, brakujące osoby, niezamierzone duplikaty, zmianę wieku i niespójną względną wysokość. Pojedynczy głos dotyczący ogólnej preferencji może ukryć poważną wadę tożsamości, jeśli reszta obrazu wygląda atrakcyjnie.
W procesie pracy z jedną postacią wykres daje niewiele dowodów na to, że Thinking jest konieczne przy każdym żądaniu. Dla scen z kilkoma powracającymi osobami jego większa raportowana przewaga czyni je bardziej obiecującym — ale nadal wymaga zmierzenia kosztów, opóźnień i wskaźników awarii tożsamości.
Wyniki edycji faworyzują 2.1, przy różnych ryzykach zależnych od zadania
Benchmarki edycji są szczególnie istotne, ponieważ wiarygodnie wyglądający wynik może nadal być nieużyteczny, jeśli zmienia chronione obszary, traci szczegóły produktu lub nieprawidłowo łączy referencje. Google podaje wyniki Elo dla ogólnej edycji, spójności, edycji opartej na maskach lub rysunku, spójności produktu, stylizacji i edycji z wieloma referencjami.

Redakcyjny wykres zweryfikowanych wyników liczbowych z karty modelu Nano Banana 2.1 Google DeepMind, październik 2026. Wyższe Elo wskazuje silniejszą względną preferencję ludzi dla edycji maska/rysunek, spójności produktu i edycji z wieloma referencjami; pokazano opublikowane zakresy ±, bez określonej definicji ufności. Nie jest to oryginalny obraz Google i nie mierzy dokładnego przestrzegania instrukcji edycji.
Edycja oparta na maskach lub rysunku jest najczytelniejszym przykładem wspólnej przewagi 2.1 bez wykazanej przewagi Thinking. Thinking uzyskuje 1049 ±15, a No Thinking 1042 ±16; ich przedziały silnie się pokrywają. Oba wyniki przewyższają Nano Banana 2 Thinking z 965 ±12 i Pro z 927 ±12. Jeśli edycja masek dominuje w obciążeniu, No Thinking może zasługiwać na równie dużą uwagę podczas testów, zamiast być traktowane jako z natury gorszy tryb.
Jednak własne ograniczenia Google kwalifikują ten wynik. Model może tylko częściowo wykonywać instrukcje edycji maskowanej, zachowywać ślady bazgrołów lub tuszu albo utrzymywać pozę podmiotu źródłowego. Preferencyjny Elo nie może potwierdzić, że piksele poza dozwolonym obszarem pozostały niezmienione. Dla katalogów i procesów regulowanych niezbędna jest osobna metryka zachowania.
Spójność produktu pokazuje mniej rozstrzygające porównanie 2.1 No Thinking ze starszymi modelami. Wyniki wynoszą 1024 ±18 z Thinking, 981 ±18 bez niego, 955 ±22 dla Nano Banana 2 Thinking i 965 ±14 dla Pro. Przedział No Thinking nakłada się na przedziały obu starszych modeli. Opublikowany wykres potwierdza zatem Thinking jako najsilniejszą konfigurację w tej ewaluacji, ale nie uzasadnia twierdzenia, że każda konfiguracja 2.1 wyraźnie poprawia wierność produktu.
Edycja z użyciem wielu referencji opowiada mocniejszą historię dla 2.1: 1066 ±22 z Thinking i 1041 ±20 bez niego, wobec 988 ±13 dla Nano Banana 2 Thinking oraz 989 ±12 dla Pro. Jednak oba przedziały dla 2.1 zachodzą na siebie, więc 25-punktowej różnicy między ich wynikami centralnymi nie należy wyolbrzymiać.
Zadania te wymagają również różnych kryteriów akceptacji. Kreatywny kompozyt może tolerować drobne zmiany geometrii, podczas gdy obraz e-commerce może nie przejść akceptacji, jeśli zmieni się logo, port, przycisk, materiał lub liczba sztuk w opakowaniu. Decyzje o migracji należy więc podejmować dla poszczególnych klas edycji, a nie na podstawie zbiorczego wniosku, że „edycja jest lepsza”.
Rzetelność faktograficzna jest obiecująca, ale pozostaje najsłabszym twierdzeniem
Google podaje wyniki zgodności infografik z faktami: 0.521 dla Nano Banana 2.1 Thinking, 0.328 bez Thinking, 0.265 dla Nano Banana Pro oraz 0.179 dla Nano Banana 2 Thinking.

Redakcyjny wykres danych AutoRater dotyczących rzetelności faktograficznej z października 2026 r., pochodzących z karty modelu Nano Banana 2.1 Google DeepMind. Wyższy wynik jest lepszy, ale ten jednostronny wynik automatycznego oceniającego nie jest odsetkiem dokładności ocenianym przez ludzi. Google nie publikuje tutaj przedziałów niepewności. To nie jest oryginalna grafika Google.
Wynik uzasadnia ograniczony wniosek: w zautomatyzowanej ocenie Google Thinking znacząco poprawia wynik rzetelności faktograficznej Nano Banana 2.1, a uzyskany wynik przewyższa wyniki wymienionych modeli porównawczych. Nie oznacza to, że 52.1% infografik jest poprawnych merytorycznie. Karta modelu nie definiuje wyniku jako wartości procentowej, nie publikuje jego niepewności, nie ujawnia liczby promptów ani nie podaje tutaj wystarczających szczegółów, by obliczyć wskaźniki błędów.
To rozróżnienie ma znaczenie, ponieważ grafiki faktograficzne mają wiele potencjalnych powierzchni błędu. Wykres może zawierać poprawny tekst, lecz przedstawiać niewłaściwe wartości. Może cytować prawdziwe źródło, ale nieprawidłowo dopasowywać daty. Mapa może zamienić regiony miejscami; oś czasu może odwrócić kolejność wydarzeń; etykieta może zostać przypisana do niewłaściwego obiektu. Zautomatyzowane ocenianie może wychwytywać część takich błędów, ale tabela nie ujawnia zakresu jego pokrycia z wystarczającą szczegółowością, by traktować je jako bramkę publikacyjną.
Uziemienie przez wyszukiwanie może dostarczać nowszych informacji, lecz pobieranie danych nie gwarantuje wiernego odwzorowania wizualnego. Karta modelu opisuje również granicę wiedzy Gemini 3.6 Flash z marca 2026 r., przy czym niektóre domeny mogą być ograniczone do stycznia 2025 r., a inne otrzymywać nowsze informacje. W przypadku grafik wrażliwych na czas materiały źródłowe należy wyraźnie dostarczyć lub pobrać, a następnie sprawdzić względem wyrenderowanego obrazu.
Uzasadniony proces pracy oddziela prawdę źródłową od prezentacji. Należy utrzymywać zatwierdzoną kartę faktów zawierającą wartości, jednostki, daty, etykiety i cytowania; wygenerować grafikę na podstawie tego briefu; a następnie porównać każde wyrenderowane twierdzenie z zatwierdzonymi faktami. To również obszar, w którym utrzymywanie identyfikowalnych faktów źródłowych i briefów dla treści wizualnych pomaga oprzeć weryfikację na podstawowych dowodach, a nie na pozornej pewności obrazu.
Benchmark czyni Thinking oczywistym kandydatem pod względem rzetelności faktograficznej, lecz nie autonomicznym systemem publikacji. Weryfikacja przez człowieka lub deterministyczna nadal jest konieczna dla grafik medycznych, finansowych, prawnych, historycznych, naukowych i dotyczących bieżących wydarzeń.
Wynik jest tańszy w każdej rozdzielczości, ale żądania niekoniecznie
Przy standardowych płatnych stawkach API Google podaje koszt generowania obrazu Nano Banana 2.1 na poziomie $30 za milion wyjściowych tokenów obrazu. Nano Banana 2 kosztuje $60 za milion. Ten nagłówek sugeruje uniwersalną redukcję o 50%, ale całkowity koszt komplikują różne przydziały tokenów w 4K oraz wyższe stawki za tokeny nieobrazowe.

Redakcyjne obliczenie na podstawie cennika Gemini API Google, październik 2026 r. Niższy koszt wyłącznie wyjścia obrazu jest lepszy: Nano Banana 2.1 jest o 50% tańszy przy 1K i 2K oraz o 25% przy 4K. Koszty nie obejmują wejścia, wyjścia tekstowego ani Thinking, uziemienia, ponownych prób, podatków ani ewentualnych rabatów Batch. To nie jest oryginalna grafika Google.
Przejrzyste obliczenie to stawka pomnożona przez liczbę wyjściowych tokenów obrazu:
Przy 1K, 1,120 tokenów obrazu kosztuje $0.0336 dla Nano Banana 2.1 i $0.0672 dla Nano Banana 2. Przy 2K, 1,680 tokenów kosztuje odpowiednio $0.0504 i $0.1008. Przy 4K modele stosują różne przydziały tokenów: 3,780 × $30 za milion daje $0.1134 dla 2.1, podczas gdy 2,520 × $60 za milion daje $0.1512 dla Nano Banana 2.
Zatem „połowa ceny” jest trafnym określeniem tylko dla wyjściowych tokenów obrazu przy 1K i 2K. Przy 4K Nano Banana 2.1 używa większej liczby podanych tokenów obrazu, co obniża oszczędność wyłącznie na wyjściu do 25%.
Inne elementy mogą zmieniać sytuację w przeciwnym kierunku. Standardowa cena wejścia dla Nano Banana 2.1 wynosi $1.50 za milion tokenów tekstowych, obrazowych lub wideo, wobec $0.50 za milion tokenów tekstowych lub obrazowych dla Nano Banana 2. Wyjście tekstowe i Thinking kosztują $7.50 za milion tokenów dla 2.1 wobec $3 dla Nano Banana 2. Pełny szacunek musi zatem uwzględniać rzeczywiste tokeny wejściowe, wyjście tekstowe, zużycie Thinking, opłaty za uziemienie tam, gdzie mają zastosowanie, ponowne próby, podatki oraz ewentualny rabat Batch.
Nie można odpowiedzialnie obliczyć łącznego kosztu „typowego żądania” bez założeń dotyczących długości promptu, tokenizacji obrazów referencyjnych, użycia Thinking, rozdzielczości i wskaźnika ponownych prób. Tańszy obraz zakończony sukcesem może nadal pochodzić z droższego żądania, podczas gdy lepsza akceptacja przy pierwszej próbie może równoważyć wyższe opłaty za rozumowanie. Mierz koszt na zaakceptowany zasób, a nie jedynie cenę wygenerowanego obrazu.
Proponowany plan oceny migracji
Poniższy opis to proponowany projekt testu, a nie opis testów przeprowadzonych na potrzeby tego artykułu.
Zacznij od warstwowego zestawu promptów pochodzących z rzeczywistej pracy. Oddziel generowanie tekst-na-obraz, pojedynczą postać, wiele postaci, edycję produktu, edycję z maską, kompozycję z wieloma referencjami, układy bogate w tekst i grafiki faktograficzne. Zachowaj prompty, pliki referencyjne, proporcje obrazu, rozdzielczości i ustawienia bezpieczeństwa, aby każdy model otrzymał to samo zadanie.
Porównaj Nano Banana 2.1 przy minimalnym, średnim i wysokim poziomie Thinking z Nano Banana 2 Thinking. Uwzględnij Pro tylko wtedy, gdy jest rzeczywistą opcją wdrożeniową; ponieważ wykres benchmarku nie określa ustawienia Pro, nie zakładaj, że jego konfiguracja obliczeniowa lub rozumowania odpowiada pozostałym. Każdemu warunkowi przyznaj w teście wewnętrznym taki sam budżet ponownych prób, nawet jeśli Google nie ujawnia, czy postąpił tak w benchmarku.
Zdefiniuj reguły akceptacji przed obejrzeniem wyników:
W przypadku renderowania tekstu przepisz każde wymagane słowo i odnotuj brakujący, zastąpiony, rozmyty lub zniekształcony tekst.
W przypadku tożsamości oceniaj każdą postać niezależnie i odnotowuj przenikanie atrybutów, duplikację, pominięcia oraz dryf twarzy lub garderoby.
W pracy z produktami porównuj chronione cechy, takie jak kształt, logo, elementy sterujące, liczba, kolor, materiał i tekst na opakowaniu.
W przypadku edycji z maską mierz zarówno powodzenie w żądanym obszarze, jak i niezamierzone zmiany poza maską.
W przypadku promptów przestrzennych testuj lewo/prawo, pierwszy plan/tło, zawieranie, kolejność i względny rozmiar.
W przypadku grafik faktograficznych weryfikuj każdą liczbę, jednostkę, datę, etykietę, cytowanie i kodowanie wizualne względem zablokowanej karty źródłowej.
W przypadku operacji rejestruj przekroczenia czasu, opóźnienie end-to-end, liczbę ponownych prób, wykorzystanie tokenów, opłaty za uziemienie oraz koszt na zaakceptowany wynik.
Stosuj zaślepioną ocenę ludzką dla jakości subiektywnej oraz kontrole deterministyczne wszędzie tam, gdzie możliwa jest dokładność. Raportuj niepewność i zachowuj sparowane wyniki, ponieważ ten sam prompt uruchomiony na różnych modelach jest bardziej informacyjny niż niepowiązane średnie. Nie sprowadzaj wszystkich zadań do jednego wyniku, jeśli błędy mają różne konsekwencje biznesowe.
Testuj zachowanie endpointu, a także jakość obrazu. Potwierdź limity 131,072 tokenów wejściowych i 32,768 wyjściowych względem aktualnej dokumentacji API, zweryfikuj domyślną rozdzielczość 1K i wyraźnie przetestuj 2K oraz 4K. Testuj wejścia z 14 referencjami tylko wtedy, gdy jest to potrzebne, pamiętając, że limity czterech postaci i dziesięciu obiektów nie gwarantują zachowania. Ponieważ function calling, wykonywanie kodu i ustrukturyzowane wyjścia nie są obsługiwane, orkiestracja i walidacja muszą odbywać się poza modelem.
Na koniec przeprowadź fazę cienia przed przełączeniem ruchu produkcyjnego. Zbieraj powody odrzucenia i porównuj koszt na zaakceptowany zasób. Ujawni to, czy zyski z benchmarku przekładają się na mniej poprawek, a nie tylko na lepiej wyglądające pierwsze wrażenia.
Kto powinien migrować — a kto powinien poczekać
Nano Banana 2.1 jest silniejszym kandydatem, gdy przepływ pracy zależy od projektowania infografik, scen z wieloma postaciami, kompozycji z wieloma referencjami, edycji opartych na maskach lub niższych opłat za wyjście obrazu. Thinking zasługuje na priorytet w przypadku grafik faktograficznych i złożonych zadań z wieloma podmiotami. No Thinking nadal warto testować w przypadku prostszego generowania i edycji, szczególnie tam, gdzie jego opublikowany przedział nakłada się na Thinking lub gdzie koszt rozumowania ma znaczenie.
Migracja powinna poczekać, gdy dokładny drobny tekst, długie fragmenty, ścisłe zachowanie tożsamości, edycja chronionych obszarów, precyzja przestrzenna lub zweryfikowane fakty są niepodlegające negocjacji, a organizacja nie dysponuje zewnętrznym etapem walidacji. To samo dotyczy sytuacji, gdy istniejąca automatyzacja zależy od nieobsługiwanego function calling, wykonywania kodu lub ustrukturyzowanego wyjścia.
Rozbieżności w dokumentacji należy traktować konserwatywnie: stosuj aktualne limity wybranego endpointu i mierz obserwowane zachowanie, zamiast wyciągać wnioski o możliwościach z szerszej architektury modelu. Podobnie aktualna tabela wycofań wymienia Gemini 3.1 Flash Image jako wycofywany, ale nie ogłasza daty wyłączenia. Nie ma zweryfikowanego terminu wycofania 29 października, który wymuszałby pośpieszne przejście.
Decyzja jest zatem konkretna. Migruj, jeśli Nano Banana 2.1 przekracza progi wierności właściwe dla zadania, obniża koszt na zaakceptowany obraz i spełnia zmierzone wymagania dotyczące opóźnień oraz przekroczeń czasu. Używaj Thinking tylko tam, gdzie wzrost współczynnika akceptacji uzasadnia dodatkowy koszt wyjścia. Zachowaj Nano Banana 2 lub inną opcję awaryjną, dopóki 2.1 nie przejdzie testów cienia. W przypadku zasobów faktograficznych, wrażliwych na tożsamość lub precyzyjnie edytowanych wymagaj walidacji niezależnie od tego, który model prowadzi w benchmarku.


