Nano Banana 2.1: Google의 이미지 벤치마크가 보여주는 것


Google은 2026년 10월 6일 Nano Banana 2.1을 출시했다. 10월 14일 기준의 이 분석은 이를 오늘의 신규 출시가 아니라 해당 출시의 후속 업데이트로 다룬다.
공개된 결과는 Nano Banana 2.1이 여러 이미지 생성 및 편집 작업에서 Nano Banana 2보다 개선됐다는 설득력 있는 근거를 제시한다. 가장 큰 것으로 보고된 우위는 인포그래픽 디자인, 다중 캐릭터 일관성, 마스크 기반 편집, 다중 참조 작업에서 나타난다. Thinking을 활성화하면 대체로 가장 높은 점수가 나오지만, 그 가치는 작업에 따라 달라진다.
이러한 결과에는 신중한 경계가 필요하다. 대부분의 점수는 올바른 이미지의 비율이 아니라 선호도 기반 Elo 평점이다. Google은 Elo 결과의 오차 범위를 제공하지만 신뢰 수준은 정의하지 않는다. 모델 카드 표에는 표본 수, 벤치마크 프롬프트, 이미지 해상도, 재시도 예산, 세부 Thinking 설정 또는 동일 연산 조건이 공개되지 않았다. 사실성 결과는 인간의 정확도 측정이 아닌 자동 평가자에서 나온 것이다.
따라서 이 벤치마크는 Google의 평가 환경에서 상대적 성능에 관한 유용한 증거이지만, 프로덕션 신뢰성, 지연 시간 또는 투자 수익을 입증하지는 않는다. 마이그레이션을 고려하는 팀은 여전히 통제된 입력, 실패 기준, 전체 요청 비용을 갖춘 워크로드별 테스트가 필요하다.
Google이 10월 6일 실제로 출시한 것
Nano Banana 2.1은 Google의 업데이트된 Flash급 이미지 생성 및 대화형 편집 모델이다. 안정 버전 Gemini API 모델 코드는 gemini-nano-banana-2.1이다. Google은 이를 Gemini 3.1 Flash Image, 즉 Nano Banana 2의 업데이트이자 일반적으로 Nano Banana Pro라 불리는 Gemini 3 Pro Image의 더 효율적인 대응 모델로 설명한다. Gemini API 변경 로그는 2026년 10월 6일의 정식 출시를 기록한다.
Nano Banana 2.1 모델 카드에 따르면, 이 모델은 Gemini 3.6 Flash를 기반으로 하며 텍스트와 이미지를 입력받아 이미지와 텍스트를 반환한다. Google은 이를 제어된 이미지 제작, 편집, 텍스트 비중이 높은 그래픽, 현지화된 렌더링, 반복적 워크플로에 적합한 모델로 내세운다. 평가는 생성 및 편집에 대한 나란히 비교하는 인간 선호도 판단과 단측 자동 사실성 평가를 결합한다.
카드는 구체적인 한계도 명시한다. 작거나 긴 텍스트는 흐려지거나 무너질 수 있고, 정체성이 흔들릴 수 있으며, 마스크 편집은 잉크를 남기거나 지시를 부분적으로만 따를 수 있다. 포즈가 예상치 않게 유지될 수 있고, 왼쪽과 오른쪽 같은 공간 관계를 혼동할 수 있으며, 세계 지식, 3D 추론, 사실성은 여전히 불완전하다. 간헐적인 속도 저하와 타임아웃도 인정된다. 이는 각주가 아니라 운영상 위험이다. 배포 전 각각에 대한 수용 테스트와 대체 정책이 필요하다.
Google의 API 모델 문서는 구현 세부 정보도 추가한다. 출력의 기본값은 1K이며 최대 4K까지 요청할 수 있다. Thinking은 minimal, 기본값인 medium, high를 제공한다. 이 모델은 검색 그라운딩을 지원하지만 함수 호출, 코드 실행, 구조화된 출력은 지원하지 않는다.
모델 카드에는 컨텍스트가 최대 100만 토큰이고 텍스트 출력이 최대 64K라고 나와 있는 반면, 배포된 Gemini API 페이지에는 입력 토큰 131,072개와 출력 토큰 32,768개가 나와 있습니다. 공개 문서는 이러한 서로 다른 제한 간의 관계를 설명하지 않습니다. 배포자는 더 큰 모델 카드 수치가 해당 API를 통해 उपलब्ध하다고 가정하기보다, 호출하는 특정 엔드포인트에 문서화된 제한을 따라야 합니다.
생성 Elo는 선두를 보여줄 뿐, 정확도 비율은 아니다
Google은 인간이 평가한 두 가지 텍스트-이미지 비교 결과를 보고한다. 전체 선호도와 인포그래픽 디자인이다. 두 비교 모두 Thinking을 사용한 Nano Banana 2.1이 1위이며, Thinking 미사용 Nano Banana 2.1, Nano Banana 2 Thinking, Nano Banana Pro가 뒤를 잇는다.
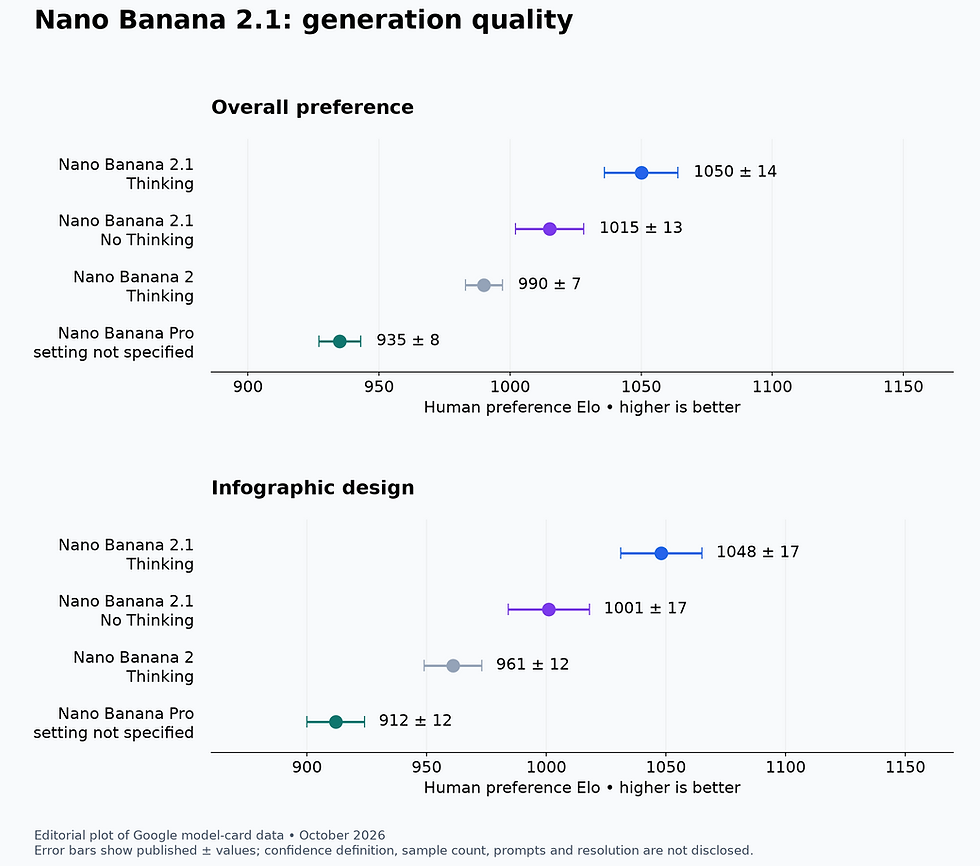
2026년 10월 Google DeepMind의 Nano Banana 2.1 모델 카드에 공개된 수치 데이터를 바탕으로 작성한 편집용 도표. 높은 Elo는 Google의 비교에서 더 강한 상대적 인간 선호도를 뜻하며, 오차 막대는 신뢰도 정의가 명시되지 않은 공개된 ± 범위를 나타낸다. 이는 원본 Google 이미지가 아니며, Elo는 백분율 정확도가 아니다.
전체 선호도에서 Nano Banana 2.1 Thinking은 1050 ±14점을 기록했으며, Thinking 미사용은 1015 ±13점, Nano Banana 2 Thinking은 990 ±7점, Pro는 935 ±8점이다. 인포그래픽 디자인의 대응 결과는 각각 1048 ±17, 1001 ±17, 961 ±12, 912 ±12다.
순위는 일관되며, 여러 격차는 표시된 범위보다 넓다. 특히 두 Nano Banana 2.1 모드는 공개된 구간을 고려해도 인포그래픽 디자인에서 Nano Banana 2보다 높은 위치에 있다. 이는 이 평가 내 선호도 우위에 대한 의미 있는 증거다. 그렇다고 2.1이 모든 프롬프트에서 승리하거나, 올바른 인포그래픽을 만들거나, 프로덕션에서 더 적은 재시도를 요구한다는 증거는 아니다.
여기에서는 Thinking이 유익한 것으로 보인다. Thinking은 No Thinking 대비 전체 선호도에서 35점 앞서며, 표시된 구간은 1036–1064와 1002–1028로 겹치지 않는다. 인포그래픽 디자인 구간은 1031에서 맞닿으므로, 차트는 우위를 뒷받침하지만 정밀하고 보편적인 효과 크기를 뒷받침하지는 않는다. Google은 벤치마크 구성을 단지 “Thinking”으로만 표기했다. 최소, 중간, 높음, 적응형 정책 또는 다른 내부 설정을 사용했는지는 공개하지 않았다.
이 누락은 비용과 지연 시간에 관한 결론을 제한한다. 사용 가능한 각 설정이 특정 워크플로에 어떤 영향을 미치는지 측정하지 않은 채, 더 높은 Thinking 점수를 “항상 high Thinking을 활성화하라”로 번역할 수는 없다. 벤치마크 표에는 지연 시간 측정치가 없으며, 이 분석 역시 이를 만들어내서는 안 된다.
실용적 신호는 더 좁다. 사용자가 구성, 시각적 완성도 또는 인포그래픽 레이아웃을 평가하는 팀은 Nano Banana 2.1 Thinking을 유력한 후보로 포함해야 한다. 저위험 장식용 자산을 생성하는 팀에는 No Thinking으로 충분할 수 있지만, 그 결정은 자체 프롬프트와 수용 임계값을 활용한 통제된 테스트에 속한다.
일관성은 개선됐지만, 단일 캐릭터 결과는 근소하다
반복 캐릭터, 캠페인 변형, 스토리보드, 제품 설명 이미지, 다중 턴 편집에서는 순수한 매력도보다 일관성이 더 가치 있는 경우가 많다. Google은 단일 캐릭터와 다중 캐릭터 일관성을 분리하며, 두 결과는 서로 다른 이야기를 들려준다.

단일 및 다중 캐릭터 일관성에 대한 Google DeepMind의 2026년 10월 모델 카드 데이터를 바탕으로 작성한 편집용 도표. 높은 Elo는 더 큰 상대적 인간 선호도를 의미하며, 공개된 ± 범위는 신뢰도 정의 없이 표시됐다. 단일 캐릭터 일관성에서 Nano Banana 2.1 Thinking과 No Thinking 사이의 거의 겹치는 구간은 중요하다. 이는 원본 Google 이미지가 아니다.
단일 캐릭터 일관성에서 Nano Banana 2.1 Thinking은 1028 ±14, No Thinking은 1021 ±14에 도달한다. 표시된 구간은 1014부터 1035까지 상당히 겹친다. 따라서 7점 차이를 확립된 실질적 우위로 제시하는 것은 정당화되지 않는다. 두 2.1 구성은 Nano Banana 2 Thinking의 981 ±10과 Pro의 991 ±9보다 높지만, 이 벤치마크는 실패가 얼굴, 의상, 신체 비율, 액세서리 또는 스타일 드리프트와 관련됐는지는 보여주지 않는다.
다중 캐릭터 결과는 차이가 더 뚜렷하다. Thinking은 1106 ±14, No Thinking은 1068 ±14, Pro는 1011 ±10, Nano Banana 2 Thinking은 978 ±10이다. 2.1 Thinking과 No Thinking의 구간은 겹치지 않는다. 이는 장면에서 여러 정체성과 그 관계를 추적해야 할 때 추가 추론이 더 유용할 수 있음을 시사한다.
그렇더라도 “최대 4명의 캐릭터 지원”은 “4개의 정체성을 안정적으로 보존”한다는 것과 다르다. API 문서는 다중 이미지 융합이 최대 14개의 참조 이미지를 허용하며, 여기에는 최대 4명의 캐릭터와 10개의 객체가 포함된다고 설명한다. 이는 입력 제한이지 충실도 보장이 아니다. 참조 이미지들이 시각적으로 유사하거나, 모순되거나, 잘렸거나, 저해상도이거나, 조명이 고르지 않을 때 성능이 어떻게 달라지는지도 알려주지 않는다.
프로덕션 평가는 각 피사체를 별도로 채점해야 한다. 유용한 실패 라벨에는 얼굴 드리프트, 의상 전이, 캐릭터 간 속성 누출, 누락된 피사체, 의도하지 않은 중복, 변경된 나이, 일관되지 않은 상대적 키가 포함된다. 이미지의 나머지 부분이 매력적으로 보인다면, 하나의 전체 선호도 투표는 심각한 정체성 결함을 가릴 수 있다.
한 캐릭터 워크플로의 경우, 차트는 모든 요청에 Thinking이 필요하다는 근거를 거의 제공하지 않는다. 여러 반복 인물이 등장하는 장면에서는 보고된 더 큰 격차가 더 유망하게 보이지만, 여전히 측정된 비용, 지연 시간, 정체성 실패율의 검증 대상이다.
편집 결과는 2.1에 유리하지만, 작업별 위험은 다르다
편집 벤치마크는 그럴듯해 보이는 출력도 보호된 영역을 변경하거나, 제품 세부 정보를 잃거나, 참조를 잘못 혼합하면 사용할 수 없기 때문에 특히 중요하다. Google은 일반 편집, 일관성, 마스크 또는 잉크 기반 편집, 제품 일관성, 스타일화, 다중 참조 편집의 Elo 점수를 보고한다.

2026년 10월 Google DeepMind의 Nano Banana 2.1 모델 카드에서 검증한 수치 결과를 바탕으로 작성한 편집용 도표. 높은 Elo는 마스크/잉크, 제품 일관성, 다중 참조 편집에서 더 강한 상대적 인간 선호도를 의미하며, 공개된 ± 범위는 신뢰도 정의 없이 표시된다. 이는 원본 Google 이미지가 아니며 정확한 편집 준수 여부를 측정하지 않는다.
마스크 또는 잉크 기반 편집은 입증된 Thinking 우위 없이 2.1의 공통 우위가 가장 분명하게 나타난 사례다. Thinking은 1049 ±15, No Thinking은 1042 ±16으로, 두 구간은 크게 겹친다. 둘 다 Nano Banana 2 Thinking의 965 ±12와 Pro의 927 ±12보다 높다. 마스크 편집이 워크로드의 대부분을 차지한다면, No Thinking을 본질적으로 열등한 모드로 취급하기보다 테스트 과정에서 동등한 주목을 받을 만하다.
그러나 Google 자체의 한계 설명은 이 결과에 조건을 단다. 모델은 마스크 편집 지시를 부분적으로만 따르거나, 낙서 또는 잉크 자국을 보존하거나, 원본 피사체의 포즈를 유지할 수 있다. 선호도 Elo는 허용된 영역 밖의 픽셀이 변하지 않았음을 입증할 수 없다. 카탈로그 및 규제 대상 워크플로에는 별도의 보존 지표가 필수적이다.
제품 일관성은 2.1 No Thinking과 이전 모델 간 비교에서 덜 निर्ण정적이다. 점수는 Thinking 사용 시 1024 ±18, 미사용 시 981 ±18, Nano Banana 2 Thinking은 955 ±22, Pro는 965 ±14다. No Thinking의 구간은 두 이전 모델의 구간과 모두 겹친다. 따라서 공개된 차트는 이 평가에서 Thinking을 가장 강한 구성으로 뒷받침하지만, 모든 2.1 구성이 제품 충실도를 명확히 개선한다고 주장할 근거는 제공하지 않는다.
다중 참조 편집은 2.1의 우위를 더 강하게 보여준다. Thinking 사용 시 1066 ±22, 미사용 시 1041 ±20으로, Nano Banana 2 Thinking의 988 ±13 및 Pro의 989 ±12와 비교된다. 다만 두 2.1 구간은 겹치므로, 중앙 점수 간 25점 차이를 과장해서는 안 된다.
이러한 작업에는 서로 다른 승인 기준도 필요하다. 창의적 합성물은 경미한 기하학적 변화가 허용될 수 있지만, 이커머스 이미지는 로고, 포트, 버튼, 소재 또는 패키지 수량이 달라지면 실패할 수 있다. 따라서 마이그레이션 결정은 “편집 성능이 더 좋다”는 종합적 결론이 아니라 편집 유형별로 내려야 한다.
사실성은 유망하지만 여전히 가장 취약한 주장이다
Google은 인포그래픽 사실성 점수가 Nano Banana 2.1 Thinking의 경우 0.521, Thinking 없이 0.328, Nano Banana Pro의 경우 0.265, Nano Banana 2 Thinking의 경우 0.179라고 보고합니다.

Google DeepMind의 Nano Banana 2.1 model card에 수록된 2026년 10월 AutoRater 사실성 데이터를 바탕으로 한 편집 차트. 높을수록 좋지만, 이 단측 자동 평가기 점수는 인간 정확도 비율이 아니다. Google은 여기에서 불확실성 범위를 공개하지 않는다. 이는 Google의 원본 이미지가 아니다.
이 결과는 제한적인 결론을 뒷받침한다. Google의 자동 평가 기준에서 Thinking은 Nano Banana 2.1의 사실성 점수를 크게 향상시키며, 그 결과 점수는 명시된 비교 대상보다 높다. 이는 인포그래픽의 52.1%가 사실적으로 정확하다는 뜻은 아니다. 모델 카드는 이 점수를 백분율로 정의하지 않고, 불확실성을 공개하지 않으며, 프롬프트 수를 밝히지 않고, 여기에서 오류율을 계산할 만큼 충분한 세부 정보를 제공하지 않는다.
이 구분은 사실 기반 그래픽에 여러 실패 지점이 있기 때문에 중요하다. 차트는 문장은 정확해도 잘못된 값을 표시할 수 있다. 실제 출처를 인용하면서 날짜를 잘못 연결할 수도 있다. 지도는 지역을 뒤바꿀 수 있고, 타임라인은 사건 순서를 역전시킬 수 있으며, 레이블은 잘못된 객체에 배정될 수 있다. 자동 점수는 이러한 오류 일부를 포착할 수 있지만, 표는 이를 출시 기준으로 취급할 만큼 충분히 상세한 적용 범위를 공개하지 않는다.
검색 기반 그라운딩은 더 최신 정보를 제공할 수 있지만, 검색 결과가 충실한 시각적 전사를 보장하지는 않는다. 모델 카드는 Gemini 3.6 Flash의 지식 마감일을 2026년 3월로 설명하며, 일부 도메인은 2025년 1월로 제한될 수 있고 일부는 더 최신 정보를 받을 수 있다고도 밝힌다. 시간 민감형 그래픽의 경우 출처 자료를 명시적으로 제공하거나 검색한 뒤, 렌더링된 이미지와 대조해야 한다.
방어 가능한 워크플로는 출처의 진실성과 표현을 분리한다. 값, 단위, 날짜, 레이블, 인용을 담은 승인된 팩트 시트를 유지하고, 그 브리프를 바탕으로 시각물을 생성한 뒤, 렌더링된 모든 주장을 승인된 사실과 비교한다. 이때 시각 콘텐츠를 위한 추적 가능한 출처 사실과 브리프 유지는 이미지가 주는 표면적 확신이 아니라 근거 자료에 기반한 검토를 유지하는 데 도움이 된다.
이 벤치마크는 Thinking을 분명한 사실성 후보로 만들지만, 자율 게시 시스템으로 만들지는 않는다. 의료, 금융, 법률, 역사, 과학 및 시사 그래픽에는 여전히 사람 또는 결정론적 검증이 필요하다.
모든 해상도에서 출력 비용은 더 저렴하지만, 요청 비용은 그렇지 않을 수 있다
Standard 유료 API 요금에서 Google은 Nano Banana 2.1의 이미지 출력 비용을 출력 이미지 토큰 100만 개당 $30로 제시한다. Nano Banana 2는 100만 개당 $60다. 이 헤드라인은 보편적인 50% 인하처럼 보이지만, 4K에서의 서로 다른 토큰 할당과 더 높은 비이미지 요금이 총비용을 복잡하게 만든다.

Google의 Gemini API pricing을 바탕으로 한 2026년 10월 편집 계산. 이미지 출력 전용 비용은 낮을수록 좋다. Nano Banana 2.1은 1K와 2K에서 50% 낮고, 4K에서 25% 낮다. 비용에는 입력, 텍스트 또는 Thinking 출력, 그라운딩, 재시도, 세금 및 가능한 Batch 할인이 포함되지 않는다. 이는 Google의 원본 이미지가 아니다.
투명한 계산식은 요금에 출력 이미지 토큰을 곱하는 방식이다.
1K에서 1,120 이미지 토큰은 Nano Banana 2.1의 경우 $0.0336, Nano Banana 2의 경우 $0.0672다. 2K에서 1,680토큰은 각각 $0.0504와 $0.1008이다. 4K에서는 모델마다 토큰 할당이 다르다. 3,780 × 출력 토큰 100만 개당 $30은 2.1 기준 $0.1134이며, 2,520 × 출력 토큰 100만 개당 $60은 Nano Banana 2 기준 $0.1512다.
따라서 “반값”은 1K와 2K의 이미지 출력 토큰에만 정확한 표현이다. 4K에서는 Nano Banana 2.1이 더 많은 명시 이미지 토큰을 사용하므로, 출력 전용 절감률은 25%로 줄어든다.
다른 구성 요소는 반대 방향으로 움직일 수 있다. Nano Banana 2.1의 Standard 입력 요금은 텍스트, 이미지 또는 비디오 토큰 100만 개당 $1.50이며, Nano Banana 2는 텍스트 또는 이미지 토큰 100만 개당 $0.50다. 텍스트 및 Thinking 출력은 2.1이 토큰 100만 개당 $7.50, Nano Banana 2가 $3이다. 따라서 전체 추정치에는 실제 입력 토큰, 텍스트 출력, Thinking 사용량, 해당되는 경우 그라운딩 비용, 재시도, 세금 및 Batch 할인을 포함해야 한다.
프롬프트 길이, 참조 이미지 토큰화, Thinking 사용량, 해상도 및 재시도율을 가정하지 않고는 어떤 “일반적인 요청” 총비용도 책임 있게 계산할 수 없다. 더 저렴하게 성공한 이미지는 더 비싼 요청에서 나올 수도 있고, 더 높은 첫 시도 승인률은 더 높은 추론 비용을 상쇄할 수도 있다. 생성 이미지당 가격만이 아니라 승인된 에셋당 비용을 측정해야 한다.
마이그레이션을 위한 제안된 평가 계획
다음은 이 글에서 수행한 테스트에 대한 설명이 아니라, 제안하는 테스트 설계다.
실제 업무에서 추출한 계층화된 프롬프트 세트로 시작한다. 텍스트-이미지 생성, 단일 캐릭터, 다중 캐릭터, 제품 편집, 마스크 편집, 다중 참조 합성, 텍스트 중심 레이아웃 및 사실 기반 그래픽을 분리한다. 모든 모델이 동일한 작업을 받도록 프롬프트, 참조 파일, 화면 비율, 해상도 및 안전 설정을 보존한다.
Nano Banana 2.1의 최소, 중간 및 높은 Thinking 설정을 Nano Banana 2 Thinking과 비교한다. Pro는 실제 배포 옵션인 경우에만 포함한다. 벤치마크 차트는 Pro의 설정을 명시하지 않으므로, 그 컴퓨팅 또는 추론 구성이 다른 모델과 같다고 가정하지 않는다. Google이 벤치마크에서 그렇게 했는지는 공개하지 않았지만, 내부 테스트에서는 각 조건에 동일한 재시도 예산을 부여한다.
출력을 검토하기 전에 승인 규칙을 정의한다:
텍스트 렌더링의 경우, 필요한 모든 단어를 전사하고 누락, 대체, 흐림 또는 잘못 형성된 텍스트를 기록한다.
정체성의 경우, 각 캐릭터를 독립적으로 평가하고 속성 누출, 중복, 누락, 얼굴 또는 의상 변화를 기록한다.
제품 작업의 경우, 형태, 로고, 제어 장치, 수량, 색상, 소재 및 패키지 텍스트 같은 보호 대상 특성을 비교한다.
마스크 편집의 경우, 요청된 영역의 성공 여부와 마스크 밖에서 발생한 의도치 않은 변경을 모두 측정한다.
공간 프롬프트의 경우, 왼쪽/오른쪽, 전경/배경, 포함 관계, 순서 및 상대적 크기를 테스트한다.
사실 기반 그래픽의 경우, 잠긴 출처 시트와 대조해 모든 숫자, 단위, 날짜, 레이블, 인용 및 시각적 인코딩을 검증한다.
운영 측면에서는 타임아웃, 종단 간 지연 시간, 재시도 횟수, 토큰 사용량, 그라운딩 비용 및 승인 결과당 비용을 기록한다.
주관적 품질에는 블라인드 인간 검토를 사용하고, 정확성이 가능한 부분에는 결정론적 검사를 사용한다. 동일한 프롬프트를 여러 모델에서 실행한 결과가 무관한 평균보다 더 많은 정보를 제공하므로, 불확실성을 보고하고 쌍을 이룬 결과를 유지한다. 실패가 서로 다른 비즈니스 결과를 낳는다면 모든 작업을 하나의 점수로 통합하지 않는다.
이미지 품질뿐 아니라 엔드포인트 동작도 테스트한다. 현재 API 문서에서 131,072 입력 및 32,768 출력 제한을 확인하고, 기본 1K 해상도를 검증하며, 2K와 4K를 명시적으로 테스트한다. 필요한 경우에만 14개 참조 입력을 테스트하되, 4개 캐릭터 및 10개 객체 제한이 보존을 보장하지는 않는다는 점을 기억한다. 함수 호출, 코드 실행 및 구조화된 출력은 지원되지 않으므로, 오케스트레이션과 검증은 모델 외부에서 이루어져야 한다.
마지막으로 프로덕션 트래픽 전환 전에 섀도 단계(shadow phase)를 실행한다. 거부 사유를 수집하고 승인된 에셋당 비용을 비교한다. 이를 통해 벤치마크 개선이 단지 더 보기 좋은 첫인상이 아니라 실제 수정 횟수 감소로 이어지는지 알 수 있다.
누가 마이그레이션해야 하며, 누가 기다려야 하는가
Nano Banana 2.1은 워크플로가 인포그래픽 디자인, 다중 캐릭터 장면, 다중 참조 합성, 마스크 기반 편집 또는 더 낮은 이미지 출력 비용에 의존할 때 더 강력한 후보이다. 사실 기반 그래픽과 복잡한 다중 주체 작업에서는 Thinking을 우선시할 가치가 있다. 더 단순한 생성 및 편집, 특히 공개된 구간이 Thinking과 겹치거나 추론 비용이 중요한 경우에는 Thinking 미사용도 테스트할 가치가 있다.
정확한 작은 텍스트, 긴 문구, 엄격한 정체성 보존, 보호 영역 편집, 공간적 정밀도 또는 검증된 사실이 협상 불가능하며 조직에 외부 검증 단계가 없다면 마이그레이션을 기다려야 한다. 기존 자동화가 지원되지 않는 함수 호출, 코드 실행 또는 구조화된 출력에 의존하는 경우도 마찬가지다.
문서 간 불일치는 보수적으로 처리해야 한다. 더 넓은 모델 아키텍처에서 용량을 추론하는 대신, 선택한 엔드포인트의 현재 제한을 따르고 관찰된 동작을 측정한다. 마찬가지로 현재 deprecations table는 Gemini 3.1 Flash Image를 지원 중단으로 나열하지만 종료 날짜는 발표하지 않는다. 성급한 전환을 강제할 검증된 10월 29일 서비스 종료 기한은 없다.
따라서 결정은 구체적이다. Nano Banana 2.1이 작업별 충실도 기준을 통과하고, 승인된 이미지당 비용을 낮추며, 측정된 지연 시간 및 타임아웃 요구 사항을 충족한다면 마이그레이션한다. Thinking은 승인률 향상이 추가 출력 비용을 정당화하는 경우에만 사용한다. 2.1이 섀도 테스트를 통과할 때까지 Nano Banana 2 또는 다른 대체 수단을 유지한다. 그리고 사실성, 정체성 민감도 또는 정밀 편집이 필요한 에셋에는 어떤 모델이 벤치마크를 주도하든 검증을 요구한다.


