Atualização DeepSeek V4.1 Flash Eleva as Pontuações, mas as Evidências Continuam Internas

Revisão das fontes em 19 de outubro de 2026: DeepSeek-V4.1-Flash-1017 é a atualização de 17 de outubro do modelo V4.1 Flash lançado em setembro. Os gráficos abaixo foram elaborados de forma independente a partir da ficha do modelo, mas as medições são da DeepSeek, não uma reprodução independente. Os preços da API não mudaram com esta atualização. A tabela comparativa não informa tamanhos de amostra, intervalos de incerteza ou orçamentos computacionais equivalentes entre fornecedores. — Fonte
A DeepSeek lançou uma atualização do DeepSeek V4.1 Flash em 17 de outubro, alegando pontuações mais altas em benchmarks, conclusão mais rápida de tarefas e respostas mais curtas. O checkpoint, chamado DeepSeek-V4.1-Flash-1017, substitui a versão de setembro no aplicativo web, aplicativo móvel e API da DeepSeek.
A mudança importante não é uma nova família de modelos nem uma nova arquitetura. A DeepSeek descreve o 1017 como uma atualização menor do modelo V4.1 Flash existente. Os desenvolvedores continuam chamando deepseek-flash, enquanto o serviço direciona as solicitações ao novo checkpoint sem exigir uma migração de API.
Essa substituição discreta cria a tensão central. A DeepSeek apresenta um equilíbrio mais forte entre desempenho e custo, especialmente para agentes de programação e trabalho orientado por ferramentas. No entanto, os resultados publicados continuam sendo reportados pela própria empresa, e diversos detalhes de avaliação necessários para comparações rigorosas não foram divulgados.
Os números da DeepSeek ainda merecem atenção. Os maiores ganhos parecem estar em trabalho de terminal, síntese de programas, automação e tarefas que abrangem repositórios de software inteiros. Essas são as cargas de trabalho nas quais Anthropic, OpenAI, Google, Moonshot AI e Zhipu AI competem pela adoção entre desenvolvedores.
Portanto, a atualização pressiona mais do que os rankings de benchmarks. Ela desafia fornecedores a demonstrar que modelos premium concluem tarefas reais com mais confiabilidade, menos tokens e menor intervenção humana. A DeepSeek melhorou seu lado desse argumento, mas testes externos agora precisam determinar quanto a atualização altera os resultados em produção.
A Atualização DeepSeek V4.1 Flash É um Checkpoint, Não uma Nova Arquitetura
A DeepSeek atualizou o modelo por trás de um produto existente, em vez de lançar outra geração de arquitetura.
O changelog de outubro da empresa afirma que o DeepSeek V4.1 Flash foi atualizado para DeepSeek-V4.1-Flash-1017. Os aplicativos web e móvel agora usam a nova versão, juntamente com o endpoint da API.
Os usuários existentes da API não precisam de um novo identificador de modelo. Solicitações que usam deepseek-flash chegam ao checkpoint mais recente. Identificadores legados de modelos Flash anteriores também são direcionados à versão atual, segundo a documentação da DeepSeek.
Esse método de entrega pode fazer o 1017 parecer menor do que é. Um endpoint estável reduz o trabalho de migração, mas também significa que o comportamento da aplicação pode mudar sem uma alteração no nome do modelo. Equipes que avaliam a consistência das respostas devem registrar o checkpoint servido, não apenas o identificador da API.
O lançamento é distinto da estreia original do V4.1 Flash em 10 de setembro. Aquele lançamento anterior introduziu a arquitetura da família de modelos, compreensão visual nativa, suporte a contextos mais longos e um design de inferência revisado. O checkpoint de outubro atualiza o modelo dentro dessa base já estabelecida.
A arquitetura usa um design de mixture-of-experts, ou MoE. Essa abordagem ativa apenas parte de uma rede muito maior para cada token, buscando reduzir a computação enquanto preserva a ampla capacidade do modelo.
A DeepSeek divulgou uma base de 552 bilhões de parâmetros para o modelo de setembro. A empresa afirmou que 8 bilhões de parâmetros ficam ativos durante o processamento da entrada e 16 bilhões ficam ativos durante a geração da saída. Essas especificações descrevem a arquitetura V4.1, não uma nova configuração de parâmetros introduzida com o 1017.
O lançamento original também descreveu um design causal de codificador-decodificador. Em termos simples, o modelo aloca diferentes capacidades ativas para compreender prompts e gerar respostas. A DeepSeek posiciona essa assimetria como uma forma de melhorar a taxa de processamento e reduzir as exigências de memória.
Seu relatório técnico descreve suporte para contextos de até um milhão de tokens. Uma janela de contexto é a quantidade de material que um modelo pode considerar em uma solicitação. A documentação atual da DeepSeek também lista um limite máximo de saída de 384.000 tokens.
Esses limites não chegaram com o 1017. Tampouco a visão nativa, que já fazia parte do V4.1 Flash. Tratar essas capacidades como adições de outubro superestimaria o que mudou.
Em vez disso, o 1017 parece ser uma atualização de pós-treinamento e comportamento. A DeepSeek afirma que ele melhora o raciocínio, a programação, o trabalho com agentes e as tarefas visuais, ao mesmo tempo que reduz o tempo de execução e o tamanho das respostas. A empresa não publicou uma contagem separada de novos parâmetros para esse checkpoint.
A distribuição aberta do modelo também importa. A DeepSeek lançou o checkpoint por meio de seu repositório de modelos sob licença MIT. Isso dá a pesquisadores e equipes de infraestrutura acesso aos pesos, sujeito às exigências práticas de servir um modelo tão grande.
Pesos abertos tornam uma inspeção mais profunda possível. Eles não tornam a avaliação independente imediata ou barata. Reproduzir benchmarks de agentes requer infraestrutura compatível, configurações de harness, acesso a ferramentas, políticas de repetição e computação substancial.
O resultado é um lançamento fácil de acessar por API, mas mais difícil de validar de forma abrangente. Essa lacuna explica por que a tabela de benchmarks da DeepSeek atualmente sustenta grande parte da narrativa.
Benchmarks de Programação da DeepSeek Mostram Onde a Atualização Melhorou
Os ganhos reportados mais fortes concentram-se em tarefas de programação e agentes, nas quais execuções mais curtas podem importar tanto quanto uma precisão maior.
A maior mudança entre estes quatro testes de programação está no Terminal-Bench 4.0, que passa de 31.2 para 42.3: aumento de 11.1 pontos, ou cerca de 35.6% em relação à pontuação anterior. O DeepSWE v1.1 sobe de 74.2 para 77.0. O cenário competitivo é misto: a tabela do fornecedor coloca o Flash-1017 acima do modelo identificado como Opus 5 no DeepSWE, mas abaixo no Terminal-Bench, ProgramBench e NL2Repo-Bench. A comparação mantém o nome exato da fonte, Opus 5. O Terminal-Bench usa Claude Code, enquanto o DeepSWE usa Mini-SWE-V2. A tabela não comprova comparações com orçamentos iguais nem taxas de sucesso em produção.

Gráfico editorial com os dados da ficha da DeepSeek de 17 de outubro de 2026. Quanto maior a pontuação informada, melhor. Terminal-Bench: Claude Code; DeepSWE: Mini-SWE-V2. A tabela não divulga data da avaliação, tamanhos de amostra, esforço de raciocínio, novas tentativas ou orçamentos equivalentes de tokens e tempo. — Fonte
A DeepSeek reporta uma pontuação de 42,3 no Terminal-Bench 4.0 para o checkpoint 1017. O modelo V4.1 Flash de setembro obteve 31,2 na comparação da empresa. Isso representa um aumento de 11,1 pontos dentro da configuração publicada pela DeepSeek.
O Terminal-Bench avalia agentes que operam em ambientes de linha de comando. Essas tarefas exigem mais do que escrever uma função isolada. O modelo precisa interpretar objetivos, usar ferramentas, navegar por arquivos, executar comandos e se recuperar de erros.
A empresa afirma que testou o Terminal-Bench 4.0 por meio do framework Claude Code. Esse detalhe importa porque um framework de agentes molda as ferramentas, instruções e o ciclo de interação disponíveis ao modelo subjacente.
No DeepSWE v1.1, a DeepSeek reporta uma alta de 74,2 para 77,0. Ela usou o framework Mini-SWE-V2 nessa avaliação. Benchmarks de engenharia de software podem ser altamente sensíveis à configuração do repositório, às permissões de ferramentas e às tentativas permitidas.
O ProgramBench mostra um salto numérico maior, de 20,3 para 29,1. O NL2Repo-Bench sobe de 65,4 para 68,2. Este último se concentra em traduzir solicitações em linguagem natural em mudanças em repositórios de software.
O padrão sugere que a DeepSeek mirou fluxos de trabalho de programação sustentados, em vez de apenas programação de respostas curtas. Essa distinção importa para empresas que testam agentes em filas de issues, tarefas de revisão de código, migrações e sessões de depuração.
Os benchmarks de agentes mostram uma direção semelhante. A DeepSeek reporta 60,5 no Automation-Bench v1.0.6, em comparação com 54,8 para o checkpoint anterior. Agents’ Last Exam sobe de 31,8 para 35,4.
O Apex Bench v1.1 passa de 64,6 para 72,1 na tabela da empresa. A DeepSeek apresenta esses resultados como evidência de que a atualização pode lidar com sequências mais longas que envolvem planejamento, uso de ferramentas e execução.
As pontuações de agentes visuais também aumentaram. O Chartography com ferramentas subiu de 78,9 para 83,0, enquanto o BabyVision passou de 89,6 para 92,5. O ZeroBench-main com ferramentas aumentou de 49,0 para 51,0.
A DeepSeek afirma que o ZeroBench-main usou Pass@5. Essa métrica permite até cinco tentativas e registra se pelo menos uma delas tem sucesso. Ela não deve ser interpretada como diretamente equivalente a uma taxa de sucesso na primeira tentativa.
A empresa também reporta 42,6 no Humanity’s Last Exam sem ferramentas. Ela lista 44,0 para um subconjunto exclusivamente textual, embora o resultado do subconjunto não deva substituir a pontuação da avaliação mais ampla.
Os ganhos nos benchmarks são consistentes em todas as comparações com modelos anteriores publicadas na tabela. Nenhum resultado listado mostra o checkpoint 1017 ficando atrás da versão de setembro. Essa consistência sustenta a alegação da DeepSeek de que a atualização é amplamente melhor dentro de suas avaliações escolhidas.
No entanto, a tabela não divulga o tamanho das amostras para várias comparações. Ela também omite hardware, orçamentos de tokens, limites de tempo, orçamentos de repetição e configurações de esforço de raciocínio. Essas variáveis podem afetar materialmente as avaliações de agentes.
Um modelo com mais chamadas de ferramentas ou mais tokens de raciocínio disponíveis pode concluir tarefas que uma configuração mais restrita não consegue. Ele também pode consumir mais tempo e recursos enquanto produz uma pontuação melhor.
A DeepSeek afirma que o novo checkpoint reduz tanto o tempo de execução quanto o tamanho das respostas. Essa alegação é central porque uma saída mais curta pode reduzir a quantidade de texto gerado que uma aplicação precisa processar. Uma conclusão mais rápida também pode melhorar a experiência do usuário e a taxa de processamento dos agentes.
Ainda assim, os materiais de lançamento não fornecem uma porcentagem universal para nenhuma das duas reduções. O tempo de execução varia conforme a carga de trabalho, a infraestrutura, o tamanho do contexto e o framework de agentes. O tamanho da saída muda conforme os prompts e a complexidade da tarefa.
A leitura responsável, portanto, é restrita. A DeepSeek reporta melhores pontuações, conclusão mais rápida e respostas mais curtas em seus harnesses avaliados. A melhoria exata em produção continua dependente da carga de trabalho.
Respostas Mais Curtas São a Verdadeira Pressão Competitiva
A DeepSeek argumenta que o desempenho útil de IA deve ser medido por tarefa concluída, e não apenas por pontuações brutas de inteligência.
A DeepSeek informa aumentos de 54.8 para 60.5 no Automation-Bench v1.0.6, de 31.8 para 35.4 no Agents’ Last Exam e de 64.6 para 72.1 no Apex Bench v1.1. O Flash-1017 supera o resultado do Opus 5 da tabela nos três testes, embora cada benchmark avalie um conjunto diferente de tarefas. Essas pontuações justificam avaliações adicionais em fluxos de trabalho com agentes; não comprovam execução confiável em um ambiente sem restrições. Os operadores devem medir, nas próprias tarefas, a conclusão bem-sucedida, o total de novas tentativas, os erros de ferramentas, o tempo de revisão e o custo total de tokens. A DeepSeek recomenda Harness 0.2.1-rc.1 ou posterior para esta versão.

Gráfico editorial de três benchmarks distintos de agentes medidos pela DeepSeek para a versão de 17 de outubro de 2026; valores maiores são melhores. A tabela não informa o esforço exato entre fornecedores, os orçamentos de tokens e tempo, os tamanhos de amostra ou a data da avaliação. Os três resultados não devem ser combinados em uma pontuação geral. — Fonte
Compradores de modelos se preocupam cada vez mais com quantos fluxos de trabalho bem-sucedidos um sistema conclui dentro de um orçamento e limite de tempo. Uma pontuação alta em benchmark perde valor quando o modelo entra em ciclos, escreve explicações desnecessárias ou chama ferramentas repetidamente.
Tarefas de agentes ampliam esse problema. Um assistente de programação pode gerar milhares de tokens enquanto explora o caminho errado. Ele também pode desperdiçar tempo relendo arquivos ou tentando correções que não abordam o problema subjacente.
A alegação da DeepSeek de respostas mais curtas mira diretamente essa ineficiência. Se o 1017 chega ao mesmo resultado, ou a um resultado melhor, com menos tokens gerados, ele pode reduzir simultaneamente a latência e a despesa operacional. Isso é mais consequente do que uma prosa concisa por si só.
A empresa chama a mudança de uma melhoria de Pareto em desempenho por custo. Uma melhoria de Pareto significa que uma opção melhora em pelo menos uma dimensão significativa sem piorar nas outras dimensões avaliadas.
Aqui, a DeepSeek alega desempenho mais forte em benchmarks junto de menor tempo de execução e respostas mais curtas. O argumento é que os desenvolvedores não precisam mais trocar tanta capacidade por velocidade ou eficiência.
As evidências disponíveis sustentam o lado do desempenho dentro da tabela de avaliação da DeepSeek. Elas não estabelecem plenamente o lado do custo por sucesso, porque a empresa não publicou medições detalhadas de recursos por tarefa.
As atuais especificações do modelo mostram que o Flash-1017 mantém a configuração de serviço existente. Os modos com e sem raciocínio continuam disponíveis, juntamente com chamadas de ferramentas, saída JSON, visão e formatos de API compatíveis.
O endpoint inalterado também reduz o atrito de implantação. Uma equipe pode testar o novo comportamento sem reescrever sua integração. Essa vantagem pode acelerar a adoção, especialmente para desenvolvedores que já usam o DeepSeek Flash.
Ela também cria risco operacional. Aplicações construídas em torno de tom, estrutura de saída ou comportamento de recusa estáveis podem reagir mal a uma mudança silenciosa de checkpoint. Testes de regressão tornam-se essenciais sempre que o modelo hospedado muda por trás de um nome persistente.
Para plataformas de programação, a pressão imediata recai sobre modelos vendidos com base em confiabilidade premium. A tabela da DeepSeek compara o 1017 com K3, GLM-5.3, GPT-5.6 Sol e um modelo identificado como Opus 5.
Esses rótulos devem ser apresentados exatamente como a DeepSeek os fornece. A tabela não avalia todos os modelos atuais de cada empresa. Seu rótulo Opus 5 não deve ser silenciosamente convertido em outra versão da Anthropic.
O checkpoint da DeepSeek supera a referência Opus 5 da tabela em DeepSWE v1.1, Automation-Bench, Agents’ Last Exam e Apex Bench. Fica atrás dessa referência em Terminal-Bench, ProgramBench, NL2Repo-Bench e nos três testes visuais listados.
Esse resultado misto é mais informativo do que uma simples alegação de vitória. A DeepSeek parece especialmente competitiva em várias avaliações de agentes, mas a própria tabela da fornecedora não mostra que ela lidere todas as categorias.
A pressão sobre os concorrentes vem do conjunto. A DeepSeek combina pesos acessíveis, uma rota de API estável, uma ampla janela de contexto, entrada multimodal e pontuações de agentes em evolução. Cada atributo amplia o número de equipes dispostas a testá-la.
O lançamento de setembro já apresentava a eficiência como um objetivo arquitetural. A DeepSeek afirmou que o V4.1 Flash usava um quarto da memória de alta largura de banda e um oitavo do armazenamento em estado sólido para seu cache de chave-valor.
Um cache de chave-valor armazena informações geradas durante a inferência para que o modelo não recalcule tudo a cada novo token. Caches menores podem reduzir a carga de memória de prompts longos e interações repetidas com agentes.
Essas alegações arquiteturais pertencem ao V4.1 Flash como família. A história de outubro é que a DeepSeek afirma que o pós-treinamento tornou o design existente mais eficaz. Ela não anunciou outro redesenho de cache com o 1017.
Essa distinção importa para compradores. A arquitetura explica por que um modelo pode ser econômico para servir. O comportamento do checkpoint determina se ele conclui as tarefas reais do comprador com precisão e eficiência.
Portanto, as equipes que avaliam a atualização devem medir o trabalho concluído, não apenas os tokens gerados. Elas devem acompanhar alterações bem-sucedidas, resultados aceitos, correções humanas, tempo decorrido e novas tentativas em fluxos de trabalho representativos.
Essa avaliação pode se encaixar em fluxos de trabalho mais amplos de IA. A etapa essencial é preservar prompts, material de origem, resultados e decisões de revisão para comparação posterior.
O que a Tabela de Benchmarks Não Estabelece
Os números da DeepSeek são evidências relevantes de sua direção de engenharia, mas não constituem confirmação independente de confiabilidade em produção.
Os resultados visuais com ferramentas melhoram, mas não mostram liderança em todos os testes. O Chartography passa de 78.9 para 83.0, o BabyVision de 89.6 para 92.5 e o ZeroBench-main de 49.0 para 51.0. As pontuações do Opus 5 citadas na fonte continuam maiores, em 84.0, 94.1 e 52.0. Essas avaliações permitem ferramentas, portanto os números não representam a precisão bruta com apenas imagens. O ZeroBench-main usa Pass@5, que admite várias tentativas; seu resultado não deve ser apresentado como confiabilidade na primeira tentativa. Agentes visuais ainda precisam de permissões adequadas para ferramentas, recuperação de erros e revisão humana em ações com consequências importantes.

Avaliações visuais com ferramentas feitas pela DeepSeek para a versão de 17 de outubro de 2026; valores maiores são melhores. O ZeroBench-main é Pass@5. A tabela não divulga outros limites de tentativas, tamanhos de amostra, intervalos de incerteza, orçamentos equivalentes ou data da avaliação. — Fonte
A principal limitação é a independência das fontes. A DeepSeek publicou a comparação e escolheu modelos, benchmarks, harnesses e configurações. As fontes primárias verificadas para este artigo não apresentam um resultado reproduzido de forma independente para o checkpoint exato 1017.
Isso não torna as pontuações falsas. Avaliações de fornecedores costumam ser a primeira evidência disponível após o lançamento de um modelo. Elas podem mostrar onde uma empresa investiu e quais cargas de trabalho espera melhorar.
Elas não podem resolver todas as comparações. Benchmarks de agentes têm mais componentes variáveis do que testes convencionais de perguntas e respostas. O prompt de sistema, as ferramentas, o tempo limite, o sandbox e a lógica de novas tentativas de um framework podem alterar a pontuação final.
A DeepSeek divulga algumas condições. O Terminal-Bench usou Claude Code, o DeepSWE usou Mini-SWE-V2 e o ZeroBench-main usou Pass@5. A empresa também recomenda o DeepSeek Harness versão 0.2.1-rc.1 ou posterior.
Essa recomendação sugere que a integração com o harness faz parte da história de desempenho. A DeepSeek diz que otimizou o modelo para seu próprio harness, Tencent CodeBuddy, WorkBuddy e outras plataformas.
Melhorias no modelo e no harness são ambas legítimas. No entanto, os compradores precisam saber se os ganhos se transferem entre ambientes. Um checkpoint ajustado em torno de um loop de agente pode ter desempenho diferente dentro da camada de orquestração de outra empresa.
A ausência de configurações de raciocínio divulgadas acrescenta incerteza. A DeepSeek oferece suporte a vários níveis de esforço de raciocínio, que afetam quanta computação interna uma solicitação recebe. Uma configuração mais alta pode melhorar os resultados enquanto aumenta a latência ou o uso de tokens.
Os detalhes de hardware também importam para alegações de velocidade. O tempo de execução em um serviço hospedado não se traduz diretamente para inferência auto-hospedada. Sobrecarga de rede, batching, quantização e a escolha do acelerador podem dominar a latência observada.
Os pesos abertos tornam essas questões testáveis, mas a auto-hospedagem não é automaticamente simples. Uma arquitetura base de 552 bilhões de parâmetros cria exigências significativas de armazenamento e memória, mesmo quando apenas parte da rede é ativada por token.
A quantização reduz a memória ao armazenar pesos em menor precisão numérica. Ela pode tornar a implantação mais prática, mas os resultados podem diferir da configuração oficial do checkpoint. As equipes devem validar a precisão após qualquer conversão.
A segurança apresenta outra preocupação de produção. Agentes de programação frequentemente leem repositórios, executam comandos, instalam pacotes e modificam arquivos. Uma melhor pontuação em benchmark não estabelece que um modelo possa receber permissões amplas com segurança.
As organizações devem isolar o trabalho dos agentes, restringir credenciais, registrar chamadas de ferramentas e exigir revisão para mudanças sensíveis. Esses controles se aplicam a todos os modelos de programação, independentemente da posição no benchmark.
A mesma cautela se aplica à janela de contexto de um milhão de tokens. Oferecer suporte a um contexto grande não garante recuperação confiável de todas as posições. Prompts longos podem introduzir distrações, instruções conflitantes e processamento desnecessário.
O suporte nativo a visão da DeepSeek também antecede a atualização de outubro. As maiores pontuações em agentes visuais sugerem um uso aprimorado dessa capacidade, mas não comprovam confiabilidade equivalente em gráficos, interfaces, documentos e imagens naturais.
O contexto histórico reforça a necessidade de alegações ponderadas. O lançamento do V4 da DeepSeek atraiu atenção porque combinava suporte a contexto amplo com uma arquitetura voltada para eficiência. Analistas independentes citados em cobertura anterior consideraram a família competitiva em relação aos principais modelos americanos.
Essa competitividade mais ampla não valida automaticamente as melhorias exatas do novo checkpoint. Os pesos 1017 exigem seus próprios testes, especialmente em cargas de trabalho que se assemelham a implantações reais.
Uma avaliação prática deve comparar ambos os checkpoints com prompts e ferramentas idênticos. Ela deve preservar temperatura, configurações de esforço, tempos limite, contagens de novas tentativas e estados dos repositórios.
Os revisores também devem pontuar a qualidade dos resultados após eliminar vantagens de verbosidade. Uma resposta mais curta é útil quando permanece completa. Ela se torna uma regressão se omitir testes, ressalvas, etapas de migração ou explicações de falhas.
Para o trabalho do conhecimento, a concisão pode gerar compensações semelhantes. Resumos curtos reduzem o tempo de leitura, mas respostas comprimidas podem ocultar incertezas ou descartar evidências minoritárias. A revisão humana continua necessária para decisões consequentes.
Portanto, o ceticismo adequado é específico. A DeepSeek publicou evidências próprias e críveis de melhoria. Ela ainda não estabeleceu ganhos universais de velocidade, menor custo total por tarefa ou confiabilidade superior em ambientes de produção independentes.
Três Sinais Mostrarão se o Flash-1017 Muda o Mercado
A reprodução independente, o desempenho entre harnesses e a adoção sustentada por desenvolvedores determinarão se o 1017 se tornará mais do que um forte lançamento de benchmark de fornecedor.
A atualização de 17 de outubro substitui o checkpoint servido pelo alias de API deepseek-flash, mantendo os preços. Na verificação de 19 de outubro, um milhão de tokens Flash custa fora do pico US$ 0.003 de entrada em cache, US$ 0.15 de entrada sem cache e US$ 0.60 de saída; no pico, os preços são US$ 0.006, US$ 0.30 e US$ 1.20. Para uma tarefa explicitamente hipotética com um milhão de tokens de entrada sem cache, quatro milhões em cache e 100000 tokens de saída, a cobrança apenas dos tokens do modelo seria US$ 0.222 fora do pico ou US$ 0.444 no pico. O cálculo exclui busca e obtenção de conteúdo, infraestrutura, novas tentativas e revisão humana. Uma saída mais curta pode reduzir a cobrança de saída, mas a afirmação da DeepSeek sobre velocidade e custo não implica uma economia fixa para toda carga de trabalho.
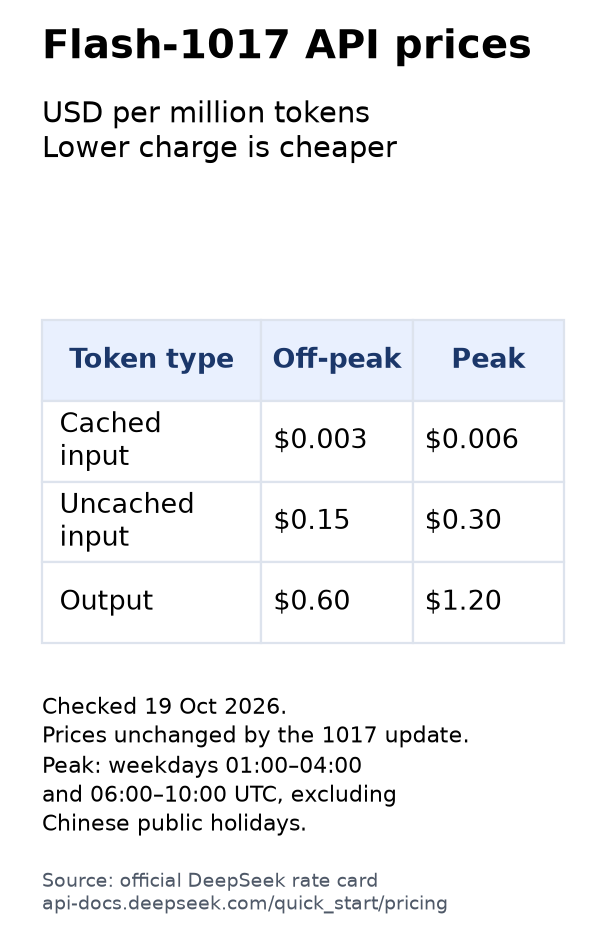
Tabela oficial de preços do Flash-1017 verificada em 19 de outubro de 2026, em dólares americanos por milhão de tokens; valores menores são mais baratos. O horário de pico ocorre nos dias úteis de 01:00–04:00 e 06:00–10:00 UTC, exceto nos feriados oficiais chineses. Os preços de tokens do modelo são separados de busca, obtenção de conteúdo e outros custos operacionais. — Fonte
O primeiro sinal é uma avaliação independente do checkpoint 1017 exato. Pesquisadores precisam testar os pesos lançados, e não o modelo de setembro ou um alias hospedado com versão incerta.
Esses testes devem publicar prompts, versões do harness, configurações de esforço, hardware, limites de tempo e políticas de novas tentativas. Os resultados devem incluir precisão, tempo decorrido, tokens de saída e comportamento em tarefas malsucedidas.
Uma correspondência com a direção relatada pela DeepSeek fortaleceria o argumento da empresa. Grandes regressões ou ganhos altamente dependentes de configuração o enfraqueceriam. Resultados mistos sugeririam que o 1017 beneficia alguns loops de agentes mais do que outros.
O segundo sinal é o desempenho em vários harnesses. A DeepSeek otimizou especificamente para plataformas selecionadas, tornando a portabilidade uma questão central. O modelo deve manter seus ganhos em agentes de programação alternativos e sistemas empresariais de orquestração.
Testes entre harnesses podem separar a melhoria do modelo da melhoria de integração. Ambas têm valor, mas respondem a perguntas de compra diferentes.
Uma empresa que adota o DeepSeek Harness pode se beneficiar do sistema combinado. Uma empresa que mantém um agente interno estabelecido precisa de evidências de que o checkpoint, por si só, melhora seu fluxo de trabalho.
Observe se testes de terceiros reproduzem o aumento no Terminal-Bench sem modificar o acesso a ferramentas. Observe também se resultados mais curtos permanecem completos quando outro framework usa um prompt de sistema diferente.
Ganhos consistentes sustentariam a alegação da DeepSeek de um checkpoint subjacente melhor. Ganhos limitados aos harnesses preferenciais fariam da escolha de integração uma parte maior da decisão.
O terceiro sinal é a adoção sustentada por desenvolvedores após o ciclo inicial de lançamento. Downloads, integrações, testes reproduzíveis e estudos de caso em produção importam mais do que a atenção na semana do lançamento.
Os pesos licenciados sob MIT reduzem o atrito jurídico para experimentação. No entanto, a escala do modelo eleva o patamar de infraestrutura para uma auto-hospedagem séria. Muitas equipes ainda escolherão acesso hospedado ou provedores especializados de inferência.
Portanto, a adoção deve ser medida nas duas rotas. O uso hospedado mostra se a experiência da API é atraente. As implantações auto-hospedadas mostram se o acesso aberto cria alternativas práticas para organizações com requisitos especializados.
A retenção importa mais do que testes. Desenvolvedores frequentemente testam novos modelos porque trocar um identificador de API é fácil. Eles só mantêm um modelo quando ele melhora o trabalho aceito sem criar novas cargas de revisão.
O resultado provável no curto prazo é uma testagem mais ampla, não uma reorganização imediata do mercado. A DeepSeek deu às equipes de agentes de programação um motivo concreto para refazer suas avaliações. Seus ganhos relatados mais fortes se alinham a tarefas que os desenvolvedores já têm dificuldade de automatizar com confiabilidade.
Os concorrentes ainda têm espaço para responder com modelos melhores, frameworks de agentes mais fortes, menor latência, execução mais segura ou comportamento mais previsível. A própria tabela da DeepSeek mostra que o checkpoint 1017 não lidera todas as comparações.
O lançamento também demonstra uma cadência competitiva mais rápida. Uma arquitetura importante chegou em setembro, seguida cinco semanas depois por um checkpoint focado em comportamento. O roteamento estável de API permite que a DeepSeek distribua essa melhoria imediatamente.
Essa cadência beneficia os usuários quando as atualizações produzem ganhos mensuráveis. Ela complica a governança quando o comportamento muda mais rápido do que os ciclos de avaliação empresariais. As equipes precisam de registros de versões e suítes recorrentes de regressão para gerenciar ambos os efeitos.
Para desenvolvedores, a decisão é simples. Teste o DeepSeek-V4.1-Flash-1017 nas tarefas exatas executadas por seus usuários. Meça resultados aceitos, novas tentativas, latência, extensão das saídas e correções humanas.
Compradores empresariais devem solicitar aos provedores identificadores de checkpoint e avisos de mudança. Também devem exigir condições de avaliação reproduzíveis antes de tratar qualquer liderança em benchmark como uma conclusão de compra.
Profissionais do conhecimento devem observar se respostas mais curtas preservam evidências e nuances. Uma resposta mais rápida oferece pouco valor quando alguém precisa reconstruir o raciocínio ausente depois.
A atualização DeepSeek V4.1 Flash já alterou o conjunto de comparação. Ela eleva as pontuações de programação e agentes do checkpoint anterior, mantendo o mesmo caminho de acesso e a mesma família de modelos.
O que acontecerá em seguida depende de evidências fora do laboratório da DeepSeek. Execute comparações controladas, preserve o registro completo da avaliação e acompanhe se testes independentes reproduzem a combinação alegada de precisão, velocidade e concisão.


