Nano Banana 2.1: O que os benchmarks de imagem do Google revelam


O Google lançou o Nano Banana 2.1 em 6 de outubro de 2026. Esta análise, datada de 14 de outubro, trata-o como um acompanhamento desse lançamento — e não como um novo lançamento hoje.
Os resultados publicados apresentam um argumento plausível de que o Nano Banana 2.1 supera o Nano Banana 2 em várias tarefas de geração e edição de imagens. As maiores vantagens relatadas aparecem no design de infográficos, na consistência entre múltiplos personagens, na edição baseada em máscara e no trabalho com múltiplas referências. Em geral, ativar o Thinking produz as pontuações mais altas, embora seu valor varie conforme a tarefa.
Essas conclusões exigem limites cuidadosos. A maioria das pontuações são classificações Elo baseadas em preferência, não percentuais de imagens corretas. O Google fornece margens de erro para os resultados Elo, mas não define seu nível de confiança. A empresa não divulga contagens de amostras, prompts de benchmark, resoluções de imagem, orçamentos de novas tentativas, configurações detalhadas de Thinking ou condições de computação equivalentes na tabela do model card. O resultado de factualidade vem de um avaliador automatizado, e não de uma medição humana de precisão.
Consequentemente, os benchmarks são evidências úteis sobre o desempenho relativo sob a avaliação do Google, mas não estabelecem confiabilidade em produção, latência ou retorno sobre o investimento. Equipes que consideram uma migração ainda precisam realizar testes específicos para suas cargas de trabalho, com entradas controladas, critérios de falha e custos completos por solicitação.
O que o Google realmente lançou em 6 de outubro
Nano Banana 2.1 é o modelo atualizado de geração de imagens e edição conversacional da classe Flash do Google. O código estável do modelo na Gemini API é gemini-nano-banana-2.1. O Google o descreve como uma atualização do Gemini 3.1 Flash Image, também chamado de Nano Banana 2, e como uma contraparte mais eficiente do Gemini 3 Pro Image, normalmente chamado de Nano Banana Pro. O changelog da Gemini API registra seu lançamento em disponibilidade geral em 6 de outubro de 2026.
Segundo o model card do Nano Banana 2.1, o modelo é baseado no Gemini 3.6 Flash e aceita texto e imagens, retornando imagens e texto. O Google o posiciona para criação controlada de imagens, edição, gráficos com muito texto, renderização localizada e fluxos de trabalho iterativos. Sua avaliação combina julgamentos humanos de preferência lado a lado para geração e edição com uma única avaliação automatizada de factualidade.
O card também identifica limitações concretas: textos pequenos ou extensos podem ficar borrados ou se deteriorar; a identidade pode variar; edições mascaradas podem preservar marcas de tinta ou seguir instruções apenas parcialmente; poses podem persistir de forma inesperada; relações espaciais como esquerda e direita podem ser confundidas; e o conhecimento de mundo, o raciocínio 3D e a factualidade continuam imperfeitos. Lentidão ocasional e timeouts também são reconhecidos. Esses são riscos operacionais, não notas de rodapé: cada um exige um teste de aceitação e uma política de contingência antes da implantação.
A documentação do modelo na API do Google acrescenta detalhes de implementação. A saída é 1K por padrão e pode ser solicitada em até 4K. O Thinking oferece minimal, medium — o padrão — e high. O modelo oferece suporte a grounding com busca, mas não a chamada de funções, execução de código ou saídas estruturadas.
O cartão do modelo lista contexto de até um milhão de tokens e saída de texto de até 64K, enquanto a página da API Gemini implantada lista 131,072 tokens de entrada e 32,768 tokens de saída. Os documentos públicos não explicam a relação entre esses limites diferentes. Os responsáveis pela implantação devem seguir os limites documentados do endpoint específico que chamam, em vez de presumir que os valores maiores do cartão do modelo estão disponíveis por meio dessa API.
O Elo de geração mostra liderança, não uma taxa de precisão
O Google relata duas comparações de texto para imagem avaliadas por humanos: preferência geral e design de infográficos. Em ambas, o Nano Banana 2.1 com Thinking ocupa o primeiro lugar, seguido pelo Nano Banana 2.1 sem Thinking, Nano Banana 2 Thinking e Nano Banana Pro.
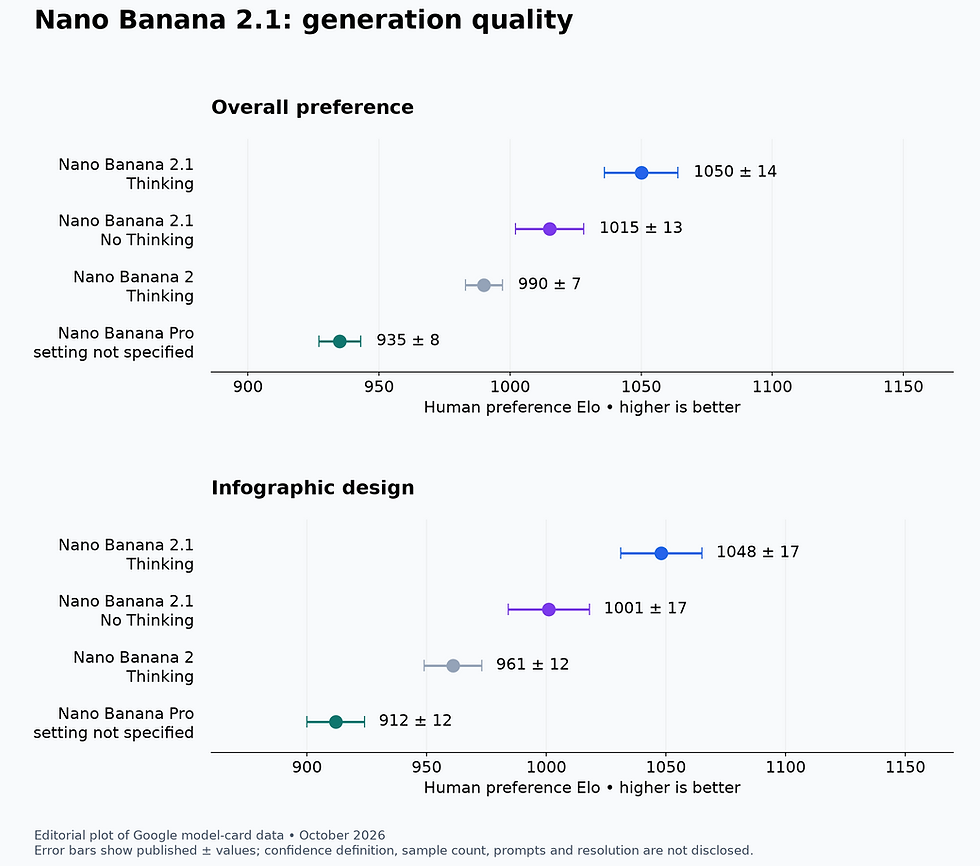
Gráfico editorial de dados numéricos publicados no model card do Nano Banana 2.1 do Google DeepMind, outubro de 2026. Um Elo mais alto indica maior preferência humana relativa nas comparações do Google; as barras de erro mostram as margens ± publicadas, cuja definição de confiança não é informada. Esta não é uma imagem original do Google, e Elo não é precisão percentual.
Para preferência geral, o Nano Banana 2.1 Thinking marca 1050 ±14, em comparação com 1015 ±13 sem Thinking, 990 ±7 para o Nano Banana 2 Thinking e 935 ±8 para o Pro. Para design de infográficos, os resultados correspondentes são 1048 ±17, 1001 ±17, 961 ±12 e 912 ±12.
A ordem é consistente, e várias diferenças são maiores que os intervalos exibidos. Em particular, ambos os modos do Nano Banana 2.1 ficam acima do Nano Banana 2 em design de infográficos mesmo considerando seus intervalos publicados. Isso é uma evidência significativa de uma vantagem de preferência dentro desta avaliação. Não é prova de que o 2.1 vencerá em todos os prompts, produzirá um infográfico correto ou exigirá menos tentativas em produção.
O Thinking parece benéfico nesse caso. Sua vantagem de 35 pontos em preferência geral sobre o No Thinking possui intervalos exibidos sem sobreposição: 1036–1064 contra 1002–1028. Os intervalos de design de infográficos se tocam em 1031, portanto o gráfico sustenta uma vantagem, mas não um tamanho de efeito universal preciso. O Google também rotula a configuração de benchmark apenas como “Thinking”. Não revela se a execução usou minimal, medium, high, uma política adaptativa ou outra configuração interna.
Essa omissão limita conclusões sobre custo e latência. Uma pontuação mais alta com Thinking não pode ser traduzida como “sempre ative o Thinking em high” sem medir como cada configuração disponível afeta um fluxo de trabalho específico. A tabela de benchmark não contém medições de latência, e esta análise não deve inventá-las.
O sinal prático é mais restrito: equipes cujos usuários avaliam composição, acabamento visual ou layout de infográficos devem incluir o Nano Banana 2.1 Thinking como um candidato sério. Equipes que geram ativos decorativos de baixo risco podem considerar o No Thinking suficiente, mas essa decisão deve vir de um teste controlado com seus próprios prompts e limites de aceitação.
A consistência melhora, mas o resultado para um único personagem é próximo
A consistência costuma ser mais valiosa do que a atratividade bruta em personagens recorrentes, variações de campanha, storyboards, explicadores de produtos e edição em múltiplas etapas. O Google separa a consistência de personagem único da consistência de múltiplos personagens, e os dois resultados contam histórias diferentes.

Gráfico editorial dos dados do model card do Google DeepMind de outubro de 2026 para consistência de personagem único e múltiplos personagens. Elo mais alto significa maior preferência humana relativa; as margens ± publicadas são exibidas sem uma definição de confiança informada. A quase sobreposição entre Nano Banana 2.1 Thinking e No Thinking para consistência de personagem único é importante. Esta não é uma imagem original do Google.
Na consistência de personagem único, o Nano Banana 2.1 Thinking alcança 1028 ±14 e o No Thinking alcança 1021 ±14. Seus intervalos exibidos se sobrepõem substancialmente, de 1014 a 1035. Portanto, seria injustificado apresentar a diferença de sete pontos como uma vantagem prática estabelecida. Ambas as configurações 2.1 pontuam acima do Nano Banana 2 Thinking, com 981 ±10, e do Pro, com 991 ±9, mas o benchmark não mostra se as falhas envolveram rostos, roupas, proporções corporais, acessórios ou desvio de estilo.
O resultado para múltiplos personagens é mais diferenciado. Thinking marca 1106 ±14, No Thinking 1068 ±14, Pro 1011 ±10 e Nano Banana 2 Thinking 978 ±10. Os intervalos de 2.1 Thinking e No Thinking não se sobrepõem. Isso sugere que o raciocínio adicional pode ser mais útil quando uma cena exige que o sistema acompanhe várias identidades e suas relações.
Ainda assim, “suporta até quatro personagens” não é o mesmo que “preserva quatro identidades de forma confiável”. A documentação da API afirma que a fusão de múltiplas imagens aceita até 14 imagens de referência, incluindo até quatro personagens e dez objetos. Esses são limites de entrada, não garantias de fidelidade. Eles não revelam como o desempenho muda quando as referências se tornam visualmente semelhantes, contraditórias, recortadas, de baixa resolução ou iluminadas de forma desigual.
Uma avaliação de produção deve pontuar cada sujeito separadamente. Rótulos úteis de falha incluem desvio facial, transferência de vestuário, vazamento de atributos entre personagens, sujeitos ausentes, duplicação indesejada, alteração de idade e altura relativa inconsistente. Um único voto geral de preferência pode ocultar um grave defeito de identidade se o restante da imagem parecer atraente.
Para um fluxo de trabalho com um personagem, o gráfico fornece pouca evidência de que Thinking seja necessário em cada solicitação. Para cenas com várias pessoas recorrentes, sua vantagem relatada maior o torna mais promissor — mas ainda sujeito à medição de custo, latência e taxas de falha de identidade.
Os resultados de edição favorecem o 2.1, com riscos diferentes por tarefa
Os benchmarks de edição são particularmente relevantes porque uma saída com aparência plausível ainda pode ser inutilizável se alterar regiões protegidas, perder detalhes do produto ou misturar referências incorretamente. O Google relata pontuações Elo para edição geral, consistência, edição baseada em máscara ou tinta, consistência de produto, estilização e edição com múltiplas referências.

Gráfico editorial de resultados numéricos verificados do model card do Nano Banana 2.1 do Google DeepMind, outubro de 2026. Elo mais alto indica maior preferência humana relativa para edição com máscara/tinta, consistência de produto e edição com múltiplas referências; as margens ± publicadas são exibidas, sem definição de confiança informada. Esta não é uma imagem original do Google e não mede a conformidade exata da edição.
A edição baseada em máscara ou tinta é o exemplo mais claro de uma vantagem compartilhada do 2.1 sem uma vantagem demonstrada do Thinking. Thinking marca 1049 ±15 e No Thinking 1042 ±16; seus intervalos se sobrepõem fortemente. Ambos ficam acima do Nano Banana 2 Thinking, com 965 ±12, e do Pro, com 927 ±12. Se a edição com máscara dominar uma carga de trabalho, o No Thinking pode merecer a mesma atenção durante os testes, em vez de ser tratado como um modo inerentemente inferior.
No entanto, as próprias limitações do Google qualificam o resultado. O modelo pode seguir instruções de edição mascarada apenas parcialmente, preservar rabiscos ou marcas de tinta, ou manter a pose do sujeito original. A preferência Elo não pode estabelecer que os pixels fora da área permitida permaneceram inalterados. Para fluxos de catálogo e regulados, uma métrica separada de preservação é essencial.
A consistência de produto mostra uma comparação menos decisiva entre o 2.1 No Thinking e os modelos anteriores. As pontuações são 1024 ±18 com Thinking, 981 ±18 sem ele, 955 ±22 para o Nano Banana 2 Thinking e 965 ±14 para o Pro. O intervalo do No Thinking se sobrepõe aos de ambos os modelos anteriores. Portanto, o gráfico publicado sustenta o Thinking como a configuração mais forte nesta avaliação, mas não sustenta a alegação de que toda configuração 2.1 melhora claramente a fidelidade do produto.
A edição com múltiplas referências conta uma história mais forte para o 2.1: 1066 ±22 com Thinking e 1041 ±20 sem ele, versus 988 ±13 para Nano Banana 2 Thinking e 989 ±12 para Pro. Ainda assim, os dois intervalos do 2.1 se sobrepõem, portanto a diferença de 25 pontos entre suas pontuações centrais não deve ser exagerada.
Essas tarefas também exigem critérios de aceitação diferentes. Uma composição criativa pode tolerar pequenas mudanças de geometria, enquanto uma imagem de ecommerce pode falhar se um logotipo, porta, botão, material ou quantidade da embalagem mudar. As decisões de migração devem, portanto, ser tomadas por classe de edição, e não a partir de uma conclusão genérica de que “a edição é melhor”.
A Factualidade É Promissora, mas Continua Sendo a Afirmação Mais Frágil
O Google relata pontuações de factualidade de infográficos de 0.521 para Nano Banana 2.1 Thinking, 0.328 sem Thinking, 0.265 para Nano Banana Pro e 0.179 para Nano Banana 2 Thinking.

Gráfico editorial dos dados de factualidade do AutoRater de outubro de 2026 do model card do Nano Banana 2.1 do Google DeepMind. Quanto maior, melhor, mas essa pontuação automatizada unilateral não é uma porcentagem de precisão humana. O Google não publica intervalos de incerteza aqui. Esta não é uma imagem original do Google.
O resultado sustenta uma conclusão limitada: sob a avaliação automatizada do Google, Thinking melhora substancialmente a pontuação de factualidade do Nano Banana 2.1, e a pontuação resultante supera as dos comparadores listados. Isso não significa que 52.1% dos infográficos estejam factualmente corretos. O model card não define a pontuação como porcentagem, não publica sua incerteza, não divulga a quantidade de prompts nem fornece detalhes suficientes para calcular taxas de erro.
Essa distinção importa porque gráficos factuais têm múltiplas superfícies de falha. Um gráfico pode conter texto correto, mas representar valores errados. Pode citar uma fonte real enquanto associa datas incorretamente. Um mapa pode trocar regiões; uma linha do tempo pode inverter eventos; um rótulo pode ser atribuído ao objeto errado. A pontuação automatizada pode capturar alguns desses erros, mas a tabela não divulga sua cobertura com detalhes suficientes para tratá-la como um critério de liberação.
O grounding por busca pode fornecer informações mais recentes, mas a recuperação não garante uma transcrição visual fiel. O model card também descreve um corte de conhecimento de março de 2026 para Gemini 3.6 Flash, com alguns domínios potencialmente limitados a janeiro de 2025 e outros recebendo informações mais novas. Para gráficos sensíveis ao tempo, o material-fonte deve ser fornecido ou recuperado explicitamente e, em seguida, conferido em relação à imagem renderizada.
Um fluxo de trabalho defensável separa a verdade da fonte da apresentação. Mantenha uma ficha de fatos aprovada contendo valores, unidades, datas, rótulos e citações; gere o visual a partir desse briefing; depois compare cada afirmação renderizada com os fatos aprovados. É também aqui que manter fatos e briefings de fontes rastreáveis para conteúdo visual ajuda a manter a revisão fundamentada nas evidências subjacentes, e não na aparente confiança da imagem.
O benchmark torna Thinking o candidato óbvio para factualidade, não um sistema autônomo de publicação. A verificação humana ou determinística continua necessária para gráficos médicos, financeiros, jurídicos, históricos, científicos e de eventos atuais.
A Saída É Mais Barata em Todas as Resoluções, mas as Solicitações Podem Não Ser
Nas tarifas pagas Standard da API, o Google lista a saída de imagem do Nano Banana 2.1 a US$30 por milhão de tokens de imagem de saída. Nano Banana 2 custa US$60 por milhão. Essa manchete parece uma redução universal de 50%, mas diferentes alocações de tokens em 4K e tarifas mais altas para conteúdo não visual complicam o total.

Cálculo editorial baseado nos preços da Gemini API, outubro de 2026. Menor custo apenas de saída de imagem é melhor: Nano Banana 2.1 é 50% mais barato em 1K e 2K e 25% mais barato em 4K. Os custos excluem entrada, saída de texto ou Thinking, grounding, novas tentativas, impostos e possíveis descontos de Batch. Esta não é uma imagem original do Google.
O cálculo transparente é tarifa multiplicada pelos tokens de imagem de saída:
Em 1K, 1,120 tokens de imagem custam US$0.0336 para Nano Banana 2.1 e US$0.0672 para Nano Banana 2. Em 2K, 1,680 tokens custam US$0.0504 e US$0.1008, respectivamente. Em 4K, os modelos usam diferentes alocações de tokens: 3,780 × US$30 por milhão resulta em US$0.1134 para o 2.1, enquanto 2,520 × US$60 por milhão resulta em US$0.1512 para Nano Banana 2.
Assim, “metade do preço” é preciso apenas para tokens de imagem de saída em 1K e 2K. Em 4K, Nano Banana 2.1 usa mais tokens de imagem listados, reduzindo a economia apenas de saída para 25%.
Outros componentes podem se mover na direção oposta. O preço Standard de entrada para Nano Banana 2.1 é US$1.50 por milhão de tokens de texto, imagem ou vídeo, contra US$0.50 por milhão de tokens de texto ou imagem para Nano Banana 2. A saída de texto e Thinking custa US$7.50 por milhão de tokens para o 2.1, contra US$3 para Nano Banana 2. Portanto, uma estimativa completa deve incluir tokens de entrada reais, saída textual, consumo de Thinking, cobranças de grounding quando aplicáveis, novas tentativas, impostos e qualquer desconto de Batch.
Nenhum total de “solicitação típica” pode ser calculado com responsabilidade sem supor comprimento do prompt, tokenização de imagens de referência, uso de Thinking, resolução e taxa de novas tentativas. Uma imagem bem-sucedida mais barata ainda pode vir de uma solicitação mais cara, enquanto uma aceitação melhor na primeira tentativa pode compensar cobranças de raciocínio mais altas. Meça o custo por ativo aceito, não apenas o preço por imagem gerada.
Um Plano de Avaliação Sugerido para a Migração
O seguinte é um desenho de teste proposto, não uma descrição de testes realizados para este artigo.
Comece com um conjunto estratificado de prompts extraídos de trabalho real. Separe texto para imagem, personagem único, múltiplos personagens, edição de produtos, edição com máscara, composição com múltiplas referências, layouts com muito texto e gráficos factuais. Preserve prompts, arquivos de referência, proporções, resoluções e configurações de segurança para que cada modelo receba a mesma tarefa.
Compare Nano Banana 2.1 com Thinking mínimo, médio e alto com Nano Banana 2 Thinking. Inclua Pro apenas se for uma opção real de implantação; como o gráfico de benchmark não especifica a configuração de Pro, não presuma que sua configuração de computação ou raciocínio corresponda às demais. Dê a cada condição o mesmo orçamento de novas tentativas no teste interno, embora o Google não divulgue se fez isso em seu benchmark.
Defina os critérios de aceitação antes de examinar as saídas:
Para renderização de texto, transcreva cada palavra exigida e registre texto ausente, substituído, borrado ou malformado.
Para identidade, avalie cada personagem de forma independente e registre vazamento de atributos, duplicação, omissão e desvio de rosto ou vestuário.
Para trabalho com produtos, compare recursos protegidos como forma, logotipo, controles, quantidade, cor, material e texto da embalagem.
Para edições com máscara, meça tanto o êxito na região solicitada quanto mudanças não intencionais fora da máscara.
Para prompts espaciais, teste esquerda/direita, primeiro plano/plano de fundo, contenção, ordenação e tamanho relativo.
Para gráficos factuais, verifique cada número, unidade, data, rótulo, citação e codificação visual em relação a uma ficha de fontes bloqueada.
Para operações, registre timeouts, latência de ponta a ponta, contagem de novas tentativas, uso de tokens, cobranças de grounding e custo por resultado aceito.
Use revisão humana cega para qualidade subjetiva e verificações determinísticas sempre que a exatidão for possível. Informe a incerteza e retenha resultados pareados, pois o mesmo prompt executado em vários modelos é mais informativo do que médias não relacionadas. Não reduza todas as tarefas a uma única pontuação se as falhas têm consequências de negócios diferentes.
Teste o comportamento do endpoint além da qualidade da imagem. Confirme os limites de 131,072 de entrada e 32,768 de saída na documentação atual da API, verifique a resolução padrão de 1K e teste 2K e 4K explicitamente. Teste entradas com 14 referências apenas quando necessário, lembrando que os limites de quatro personagens e dez objetos não prometem preservação. Como function calling, execução de código e saídas estruturadas não são compatíveis, a orquestração e a validação devem ocorrer fora do modelo.
Por fim, execute uma fase paralela antes de mudar o tráfego de produção. Registre os motivos de rejeição e compare o custo por ativo aceito. Isso revela se os ganhos de benchmark se traduzem em menos revisões, em vez de apenas primeiras impressões visualmente melhores.
Quem Deve Migrar — e Quem Deve Esperar
Nano Banana 2.1 é o candidato mais forte quando um fluxo de trabalho depende de design de infográficos, cenas com múltiplos personagens, composição com múltiplas referências, edições baseadas em máscara ou menores cobranças de saída de imagem. Thinking merece prioridade para gráficos factuais e tarefas complexas com múltiplos assuntos. Sem Thinking continua valendo testes para geração e edição mais simples, especialmente quando seu intervalo publicado se sobrepõe ao de Thinking ou quando o custo de raciocínio é relevante.
A migração deve esperar quando texto pequeno exato, passagens longas, preservação estrita de identidade, edição de regiões protegidas, precisão espacial ou fatos verificados são inegociáveis e a organização não dispõe de uma etapa externa de validação. O mesmo se aplica quando a automação existente depende de function calling, execução de código ou saída estruturada não compatíveis.
Discrepâncias na documentação devem ser tratadas de forma conservadora: siga os limites atuais do endpoint escolhido e meça o comportamento observado, em vez de inferir capacidade a partir da arquitetura mais ampla do modelo. Da mesma forma, a atual tabela de descontinuações lista Gemini 3.1 Flash Image como descontinuado, mas não anuncia uma data de encerramento. Não há um prazo de aposentadoria verificado em 29 de outubro que justifique uma transição apressada.
A decisão é, portanto, concreta. Migre se Nano Banana 2.1 superar os limites de fidelidade específicos da tarefa, reduzir o custo por imagem aceita e atender aos requisitos medidos de latência e timeout. Use Thinking apenas quando seu ganho na taxa de aceitação justificar seu custo adicional de saída. Mantenha Nano Banana 2 ou outra alternativa até que o 2.1 passe nos testes paralelos. E, para ativos factuais, sensíveis à identidade ou editados com precisão, exija validação independentemente de qual modelo liderar o benchmark.


