AI 代理的上下文工程:揭示 Manus 构建更智能、可扩展 AI 解决方案的经验教训

已更新:6月17日

引言
随着大语言模型 (LLMs) 时代的开启,构建真正具备能力的自主 AI agent 不仅仅是选择最强大的模型,更在于如何设计该模型通过上下文与其环境进行交互。“上下文工程”已迅速成为构建可靠、可扩展且高效 AI agent 的关键。本文借鉴了 Manus(一个开创性的 AI agent 框架) 背后的实践历程,探讨了掌握上下文工程的核心概念、关键经验和可操作策略。无论你是从零开始开发新的 agent,还是寻求将现有产品推向新高度,理解并应用这些原则都将加速你通往稳健 AI 解决方案的道路。
究竟什么是 AI agent 的上下文工程?

核心定义与常见误区
AI agent 的上下文工程(Context engineering)是指对提供给语言模型的信息(上下文)进行系统性的设计、结构化和处理,使 agent 能够在现实环境中进行推理、行动和适应。与其针对每个新用例对模型进行微调(这是一个缓慢、昂贵且缺乏灵活性的过程),上下文工程利用提示词组合、上下文记忆和交互模式来最大化性能和适应性。
常见误区:
这只是提示工程(prompt engineering): 虽然提示工程是其中的一部分,但上下文工程涵盖了完整的 agent 与环境交互、记忆管理,甚至包括如何将失败转化为学习信号。
更大的上下文窗口能解决所有问题: 即使模型提供 128K 或更多的 token,现实世界的应用也会迅速暴露其局限性——包括技术层面(长上下文导致的性能下降)和经济层面(飙升的推理成本)。
因此,合理的上下文工程(context engineering)是构建稳健、高效且可扩展的 AI agent 的基础。
为什么 AI agent 的上下文工程如此重要?

其影响与价值
上下文工程至关重要,因为它决定了 AI agent 的行为、效率和成功:
速度与成本:智能上下文管理(特别是最大化 KV-cache 命中率)可以使延迟和成本降低一个数量级。例如,在 Manus 中,缓存 token 推理的成本可能比非缓存操作便宜 10 倍。
适应性: 精心设计的上下文使智能体能够随着底层 LLMs 的改进而进化,从而避开了定制微调模型的不灵活性。
可靠性与恢复: 在上下文中记录成功和失败的案例可以增强智能体的鲁棒性。无需外部干预即可从错误中“学习”的智能体,能更好地应对现实世界的各种变化。
可扩展性:高效的上下文处理 让智能体能够处理复杂的、多步骤的任务,而不会消耗过多的资源。
如果没有上下文工程,即使是最好的模型也会变得脆弱、昂贵且不可靠。
AI 智能体上下文工程的演进:从 BERT 到 LLMs
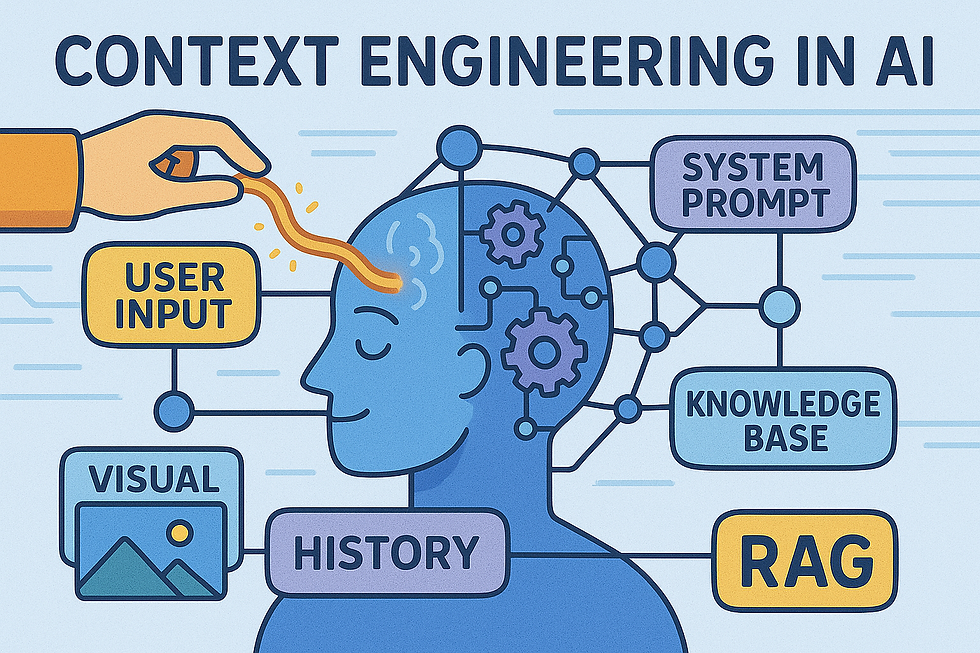
先进上下文工程的发展道路与 NLP 的进步并驾齐驱:
Pre-BERT 时代: 模型需要大量的微调和数周的迭代来处理新任务,这阻碍了产品与市场的契合以及快速开发。
LLM 的兴起 (GPT-3, Flan-T5): 强大的、具备上下文感知能力的 LLM 的出现,使团队能够从训练自定义模型转向构建利用上下文进行动态适应的智能体 (agents)。
当代实践: 如今最出色的智能体框架,例如 Manus,旨在充分利用上下文操作、 KV-cache 优化以及模块化内存系统的能力。
核心教训:上下文工程 (context engineering) 现在至少与模型工程本身一样至关重要。
AI 智能体上下文工程的工作原理:逐步揭秘
针对 KV-Cache 效率进行设计
KV-cache(键值缓存)命中率是衡量智能体性能和成本最关键的指标。通过保持稳定的提示词前缀、使上下文严格保持“仅追加”模式,以及确保上下文对象的确定性序列化(例如工具定义或状态数据),可以实现高缓存利用率。
避免破坏上下文的做法,例如在提示词中包含易变的时刻数据,或重新排序先前已序列化的操作/观测结果。
动作空间管理:使用掩码,而非移除
如果不加管理,工具“爆炸”会导致智能体的动作选择容易出错。Manus 发现,掩码技术(在解码过程中使用 logit masking根据状态隐藏或要求特定动作)比在智能体循环中动态添加/删除工具更具缓存友好性且更稳健。
遮蔽(Masking)可以避免缓存失效,减少混淆,并允许在不牺牲效率的情况下进行灵活的工具管理。
将文件系统作为上下文外部存储使用
文件系统提供了几乎无限的、持久的上下文外部化能力Manus 智能体学习读写文件以实现结构化、可恢复的记忆——例如,保存 URL 而不是整个网页,或保存路径而不是完整文档。
这既能实现高效的上下文截断(以节省成本并适应限制),又能在必要时进行恢复。
利用重复与重述
在智能体的上下文中持续更新 "todo.md" 或类似的计划文件,起到了一种 "注意力操纵" 的作用——让目标始终处于首位,并抵消 LLM 注意力中长期任务目标的自然衰减。
保留上下文中的失败记录
与其擦除失败的尝试或错误,将它们保留在上下文中能加强智能体的学习并减少重复错误。能够“看到”自己过去错误的智能体适应速度要快得多。
这一原则在基准测试中未被充分利用,但在现实世界的性能表现中至关重要。
避免少样本模式的过拟合
过度的少样本提示工程会导致智能体模仿无效率的模式。相反,Manus 增加了受控的变异性(模板更改、轻微的顺序打乱、交替措辞)以避免停滞和幻觉。
如何在现实生活中为 AI 智能体应用上下文工程

实践指南:
针对缓存进行优化:
在不同会话间保持 prompt 和工具定义稳定
以确定性方式序列化对象以避免细微的上下文差异
仅在绝对必要时,通过明确的缓存断点来批量处理更改
使用遮罩工具而非删除:
使用解码过程中的有状态 logit 遮罩来限制或强制执行操作选择
创建一致的操作前缀(例如,所有浏览器工具都以 browser_ 开头),使遮罩更容易且调试更简单
外部化长期状态:
将大型、不常用的数据卸载到文件中,通过路径或 URL 进行引用,而不是将其保留在原始上下文中
利用重述与自我引用:
让智能体反复阐述目标或计划,确保在长期任务中始终保持对齐
保留错误以供学习:
将失败的操作和异常保留在上下文中以促进自我纠正
改变模式以减少过拟合:
在提示词序列和操作模板中加入刻意的多样性,以打破单调并防止无用的模仿
实现示例:
一个 Manus 风格的智能体在处理 20 份简历筛选时,会将评审计划和进度存储在外部文件中,通过屏蔽工具选项来确保每个评审阶段仅允许相关操作,并记录每份简历的成功与失败尝试。通过将细节卸载到文件中,仅在实时上下文中保留摘要指针,从而实现上下文修剪,优化成本和模型性能。
AI 智能体上下文工程的未来:机遇与挑战
机遇:
更智能、更可靠的智能体: 增强的上下文管理为真正像人类一样行动和恢复的“自主”智能体奠定了基础。
模型无关的智能体设计: 上下文工程 允许智能体架构随着 LLM 的快速进步而演进,无需进行破坏性的重写。
外部存储集成:利用类文件系统结构可以为集成下一代神经记忆系统(如 State Space Models、神经图灵机)铺平道路,从而实现更具扩展性的 AI。
挑战:
平衡上下文大小与效用:随着上下文窗口的增长,在必要信息与推理成本之间进行权衡变得更加复杂。
上下文压缩风险:过度截断上下文或有损压缩可能会面临删除智能体决策关键证据的风险。
人机协作:决定在 agent 日志中公开哪些错误或失败的尝试,涉及隐私、可审计性和信任方面的考量。
下一波突破可能来自那些将 context engineering、架构创新和严谨的现实世界迭代相结合的人。
结论:AI Agent context engineering 的关键要点
Context engineering对于构建可扩展、高性价比且稳健的 AI agent 至关重要。这不仅仅关乎提示词技巧,更关乎整体交互设计——包括外部记忆、错误处理和动作空间控制。
实用性胜过完美:经验表明,经验性迭代(“随机梯度下降”)和稳健的工程实践比优雅但未经证实的理论能带来更多进步。
智能体记忆就是一切:持久且可检索的上下文——尤其是外部化的上下文——能够实现复杂、长期且具有韧性的行为。
失败是有价值的:拥抱并记录智能体的失败,以加速自我纠正和学习。
为演进而设计:优化你的上下文,让你的智能体能够顺应 LLM 进步的浪潮,而不是在潮水转向时搁浅。
正如 Manus 的历程所示,智能体的未来将由一个又一个上下文构建而成。
关于 AI Agent 上下文工程(Context Engineering)的常见问题解答 (FAQ)

什么是 AI Agent 的上下文工程?
上下文工程是指组织和管理信息的过程,这些信息由 AI Agent 提供给语言模型,从而实现有效的推理、行动和适应。它比提示工程(prompt engineering)更广泛——涵盖了 Agent 与环境交互的所有方面。
AI Agent 上下文工程中最常见的挑战是什么?
最大的挑战是管理 KV-cache 效率(以平衡成本和速度)、处理不断增长的上下文长度,以及确保利用错误进行适应而非将其隐藏。
AI Agent 的上下文工程与传统的 NLP 或聊天机器人设计有何不同?
传统的聊天机器人依赖于简单的“提示-响应”循环,除了简短对话外可能不需要记忆。相比之下,高级 AI agent 维持持久化记忆,管理大型工具集,并使用复杂的上下文管理(包括文件系统和动态动作空间)与环境交互。
开发者如何开始进行 AI agent 的上下文工程?
首先应稳定提示词前缀,实施仅追加(append-only)的上下文策略,并将大型或持久状态外部化到结构化文件中。在动作选择中使用 logit masking,并在 agent 工作流中设计错误持久化机制。


