智能体视觉 Gemini 3 Flash: 超越静态图像识别


的发布 Agentic Vision Gemini 3 Flash 于2026年1月标志着多模态模型处理视觉数据方式的具体转变。我们不只是在关注更高的参数数量或对“更好理解”的模糊承诺。我们正在关注机制的根本变化:该模型现在编写并执行Python代码来“调查”图像,而不是仅仅盯着它猜测。
此功能更新,currently live in Google AI Studio and Vertex AI, 试图解决视觉语言模型(VLMs)在面对密集图表或计数任务时持续存在的幻觉问题。
Agentic Vision Gemini 3 Flash的真实世界反馈
在深入研究Google架构图之前,最好先看看开发者实际使用API时的情况。Reddit等平台上的反馈以及初期开发者日志描绘了一幅喜忧参半但充满希望的画面:Agentic Vision Gemini 3 Flash。
复杂数据提取的成功
用户在复杂图表和技术图纸上测试该模型时,报告称可靠性显著提升。在之前的迭代中,要求模型从密集散点图中提取特定数据点往往会得到“基于感觉”的答案——看起来正确但实际是幻觉的数字。
因为Agentic Vision Gemini 3 Flash使用代码执行,它不只是预测下一个token;它似乎运行Python脚本来处理视觉信息。一位用户指出,对于转录复杂菜单,该模型相比OpenAI’s o3模型的速度优势显著,将原本可能需要5-10分钟的任务缩短至几秒。这表明“Flash”架构即使在代理循环的开销下,仍保持了低延迟的承诺。
“Mannequin”失败与分割限制
不过,它并非魔法。一项值得注意的压力测试要求模型使用边界框区分照片中的真实人物和人体模型。该模型未能正确标注它们。
这一失败凸显了一个关键区别:Agentic Vision Gemini 3 Flash在数学和逻辑“调查”(计数对象、通过OCR脚本读取文本、计算比率)方面表现出色,但如果代码解释找不到程序化钩子,它在需要对视觉上下文进行深度概念理解的语义分割任务上仍存在困难。用户已经在请求与SAM3等专业分割工具集成以弥合这一差距。
开发者需求
社区反馈循环迅速展开。强烈要求将此功能移植到“Pro”系列,假设更大的模型大脑能编写更好的调查代码。还有针对“nerfing”的具体抱怨,这是一种常见情绪,即模型拒绝它之前可能尝试的任务(即使效果不佳),这可能是由于新代理功能伴随的更严格安全护栏所致。
Agentic Vision Gemini 3 Flash循环的工作原理

这里的核心差异在于“Think-Act-Observe”循环。标准VLMs执行单次传递:它们摄取像素并输出文本。如果文本需要计数50个微小对象,而模型在第一次传递中遗漏了三个,它就无法返回检查。
Agentic Vision Gemini 3 Flash改变了工作流程:
Think: 模型分析提示(例如,“Count the red cars”)。
Act: 它生成Python代码来执行操作,例如裁剪图像以放大特定区域或运行像素分析脚本。
Observe: 它审查该代码的输出。
Iterate: 如果数据不足,它会在给出最终答案前重复该过程。
这种主动调查实现了“ grounding”。当模型回答关于微芯片序列号的问题时,它不是基于模糊概览进行猜测;它很可能已在内存中“cropped”图像的该部分以清晰读取。
对Agentic Vision Gemini 3 Flash基准的影响
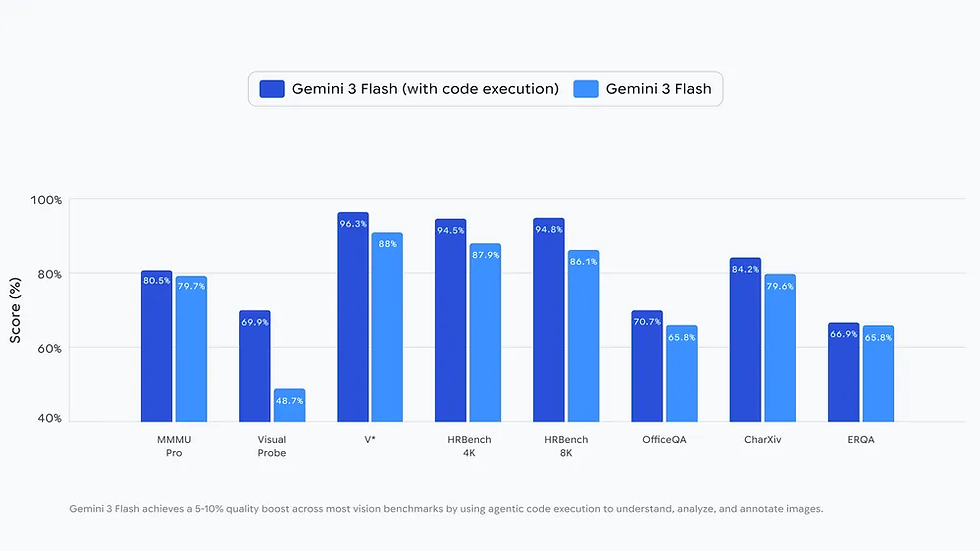
Google声称这种迭代方法在标准视觉基准上带来了5-10%的质量提升。虽然基准数字往往感觉抽象,但在这种情况下,该指标与方法直接相关:改进来自模型使用工具进行自我纠正的能力。
技术实现与成本
对于在Vertex AI或Google AI Studio上构建的团队,入门门槛较低,但成本结构具体。
定价与效率
Agentic Vision Gemini 3 Flash的定价为每100万输入token 0.50美元,每100万输出token 3.00美元。对于音频输入,费率翻倍至每100万token 1.00美元。
Google指出与Gemini 2.5 Pro相比,token使用量减少了30%。这种效率提升可能源于模型通过简洁代码而非冗长的思维链文本生成来解决问题。它不是生成大段推理来说服自己得出答案,而是直接运行脚本。
使用API
要使用Agentic Vision Gemini 3 Flash, 开发者必须在API中启用Code Execution参数或在AI Studio playground的“Tools”部分启用。
有一个名为media_resolution的细粒度控制可用。开发者可以在low、medium、high和ultra_high之间切换。
Low/Medium: 适用于一般场景描述。
High/Ultra_high: 对于代理功能在文本阅读或小对象计数等细节上有效工作至关重要。
高分辨率会增加延迟和token消耗,因此最佳实践是根据用户请求的复杂性动态调整此参数。
代理成像的未来

的发布Agentic Vision Gemini 3 Flash表明我们正在触及“静态”神经网络处理图像能力的极限。未来不只是更大的模型;而是使用工具的模型。
然而,“Think-Act-Observe”循环引入了新的故障点。如果模型编写了错误的Python代码,视觉分析就会失败,无论底层LLM多么智能。关于人体模型测试的反馈证明,代码执行并非语义理解的灵丹妙药。它将视觉问题转化为逻辑问题,这对图表有效,但对细微摄影效果较差。
目前,对于数据处理工作流而言,其实用性无可否认。我们已经从AI查看电子表格截图并猜测总数,转变为AI编写脚本来对列求和。这是可靠的一步向前。
FAQ: Agentic Vision Gemini 3 Flash
Q: Can Agentic Vision Gemini 3 Flash count objects accurately, like skittles in a jar?
A: 它比标准模型表现显著更好,因为它可以编写代码来识别和计数不同的像素组。然而,对于代码分割失败的严重遮挡对象,它可能仍存在困难。
Q: How do I enable the code execution feature for image analysis?
A: 在Google AI Studio中,转到“Tools”下拉菜单并将“Code Execution”切换为开启。如果使用API,您必须在请求负载中包含代码执行工具定义。
Q: Why did users compare Gemini 3 Flash to OpenAI’s o3?
A: 用户发现Gemini 3 Flash在转录菜单等任务上更快。虽然o3功能强大,但反馈表明Gemini的特定代理工具在“主动”视觉任务中提供了速度优势。
Q: Does the "Think-Act-Observe" loop increase the cost of using the model?
A: 是也不是。虽然它可能每个请求使用更多处理时间,但Google声称平均节省30%的token量,因为模型通过代码而非冗长文本推理高效解决问题。
Q: Can Agentic Vision Gemini 3 Flash replace segmentation models like SAM?
A: 尚未。用户测试显示它在语义边界上存在困难,例如区分人类和人体模型。它最适合用于逻辑提取而非像素完美的分割掩码。
Q: Is this feature available in the standard Gemini App?
A: 是的,它正在通过“Thinking”模型设置推广到Gemini App,允许普通用户访问与开发者相同的代理功能。


