DeepSeek V4.1 Flashアップデート、スコアは向上も根拠は依然として社内にとどまる

2026 年 10 月 19 日の根拠確認:DeepSeek-V4.1-Flash-1017 は、9 月に公開された V4.1 Flash の 10 月 17 日版アップデートです。以下は DeepSeek のモデルカードの数値を編集部が独自に図示したもので、測定自体は DeepSeek によるものです。第三者による再現結果ではありません。今回の更新に伴う API 価格の変更はありません。比較表では、サンプル数、不確実性の区間、提供元間で条件をそろえた計算予算は公開されていません。 — 出典
DeepSeekは10月17日、ベンチマークスコアの向上、タスク完了の高速化、出力の短縮をうたうDeepSeek V4.1 Flashのアップデートを公開した。DeepSeek-V4.1-Flash-1017と名付けられたこのチェックポイントは、DeepSeekのWebアプリ、モバイルアプリ、APIにおいて9月版を置き換える。
重要な変更は、新しいモデルファミリーやアーキテクチャではない。DeepSeekは1017を、既存のV4.1 Flashモデルに対する小規模なアップデートと説明している。開発者は引き続きdeepseek-flashを呼び出せ、API移行なしにサービス側でリクエストが新しいチェックポイントへ振り分けられる。
この目立たない置き換えが、今回の中心的な緊張関係を生む。DeepSeekは、特にコーディングエージェントやツール駆動型の作業において、性能とコストのバランスが改善したとしている。しかし、公表された結果は依然として同社報告にとどまり、厳密な比較に必要な評価の詳細の一部は開示されていない。
それでもDeepSeekの数値は注目に値する。最大の改善は、ターミナル作業、プログラム合成、自動化、ソフトウェアリポジトリ全体にまたがるタスクで見られる。これらは、Anthropic、OpenAI、Google、Moonshot AI、Zhipu AIが開発者の採用を巡って競争している領域だ。
したがって、このアップデートが圧力をかけるのはベンチマーク順位だけではない。プレミアムモデルの提供企業には、より少ないトークンと人手の介入で、実際のタスクをより確実に完了できることの提示が求められる。DeepSeekはこの論点で自社の立場を強化したが、今回の更新が本番環境の成果をどこまで変えるかは、今後の外部検証で判断される必要がある。
DeepSeek V4.1 Flashアップデートは、新アーキテクチャではなくチェックポイントだ
DeepSeekは新たなアーキテクチャ世代を投入するのではなく、既存製品の背後にあるモデルを更新した。
同社の10月の変更履歴によると、DeepSeek V4.1 FlashはDeepSeek-V4.1-Flash-1017へアップグレードされた。Webアプリとモバイルアプリは、APIエンドポイントとともに新バージョンを利用している。
既存のAPI利用者に新しいモデル識別子は必要ない。deepseek-flashを使用するリクエストは最新のチェックポイントに到達する。DeepSeekのドキュメントによれば、従来のFlashモデル用レガシー識別子も現在のバージョンにルーティングされる。
この提供方法により、1017は実際より小さな変更に見えるかもしれない。安定したエンドポイントは移行作業を減らす一方、モデル名が変わらないままアプリケーションの挙動が変化することも意味する。出力の一貫性を評価するチームは、API識別子だけでなく、実際に提供されたチェックポイントも記録すべきだ。
このリリースは、9月10日のV4.1 Flash初回公開とは異なる。先行リリースでは、モデルファミリーのアーキテクチャ、ネイティブな視覚理解、より長いコンテキスト対応、改訂された推論設計が導入された。10月のチェックポイントは、その確立済みの基盤の上でモデルを更新するものだ。
アーキテクチャには、Mixture-of-Experts(MoE)設計が採用されている。この方式は、各トークンに対して大規模ネットワークの一部だけを活性化し、幅広いモデル能力を維持しつつ計算量の削減を目指す。
DeepSeekは9月モデルについて、5520億パラメータのバックボーンを開示した。入力処理時には80億パラメータ、出力生成時には160億パラメータがアクティブになるとしている。これらの仕様はV4.1のアーキテクチャを示すものであり、1017で導入された新しいパラメータ構成ではない。
初回リリースでは、因果的エンコーダ・デコーダ設計も説明されていた。簡単に言えば、このモデルはプロンプト理解と回答生成に異なるアクティブ容量を割り当てる。DeepSeekはこの非対称性を、スループットの改善とメモリ要件の削減につながる手法として位置付けている。
同社の技術報告書では、最大100万トークンに達するコンテキストへの対応が説明されている。コンテキストウィンドウとは、モデルが1回のリクエスト内で考慮できる情報量を指す。DeepSeekの現行ドキュメントには、最大出力許容量として384,000トークンも記載されている。
これらの上限は1017で導入されたものではない。V4.1 FlashにはすでにネイティブVisionも含まれていた。これらの能力を10月の追加機能として扱えば、変更点を過大に評価することになる。
むしろ1017は、ポストトレーニングと挙動の更新と見られる。DeepSeekは、実行時間と応答長を削減しながら、推論、コーディング、エージェント作業、視覚タスクを改善したとしている。同社はこのチェックポイント向けの別個の新しいパラメータ数を公表していない。
オープンモデルとしての配布も重要だ。DeepSeekはこのチェックポイントを、MITライセンスの下でモデルリポジトリを通じて公開した。これにより、研究者やインフラチームは、このほど大規模なモデルを提供する際の実務的な負荷を前提として、重みにアクセスできる。
オープンウェイトにより、より深い検証は可能になる。ただし、独立評価が即座に、あるいは低コストで可能になるわけではない。エージェントベンチマークの再現には、互換性のあるインフラ、ハーネス設定、ツールアクセス、再試行ポリシー、大量の計算資源が必要となる。
結果として、このリリースはAPI経由では容易に利用できる一方、包括的な検証はより難しい。その隔たりが、現時点でDeepSeekのベンチマーク表が記事の大部分を担う理由でもある。
DeepSeekのコーディングベンチマークは、アップデートの改善領域を示す
報告された最も大きな改善はコーディングおよびエージェント系タスクに集中しており、この領域では高い精度と同じくらい短い実行時間が重要になり得る。
この 4 項目のコーディング評価で最大の変化は Terminal-Bench 4.0 の 31.2 から 42.3 への上昇です。11.1 ポイントの増加で、元のスコアに対して約 35.6% の改善となります。DeepSWE v1.1 は 74.2 から 77.0 に上昇しました。競争力は評価によって異なります。提供元の表では、Flash-1017 は DeepSWE で Opus 5 と記されたモデルを上回りますが、Terminal-Bench、ProgramBench、NL2Repo-Bench では下回ります。比較対象の名称は原資料どおり Opus 5 としています。Terminal-Bench は Claude Code、DeepSWE は Mini-SWE-V2 を使用します。この表だけでは、同一予算での比較や本番業務の成功率は示せません。

DeepSeek が 2026 年 10 月 17 日に公開したモデルカードの数値を編集部が図示。報告スコアは高いほど良好です。Terminal-Bench:Claude Code、DeepSWE:Mini-SWE-V2。表には評価日、サンプル数、推論の強度、再試行回数、トークン・時間予算の統一条件が示されていません。 — 出典
DeepSeekによると、1017チェックポイントのTerminal-Bench 4.0スコアは42.3だった。9月のV4.1 Flashモデルは、同社比較で31.2を記録していた。DeepSeekが公表した設定内では、11.1ポイントの上昇となる。
Terminal-Benchは、コマンドライン環境で動作するエージェントを評価する。これらのタスクでは、単独の関数を書くだけでは足りない。モデルは目標を解釈し、ツールを使い、ファイルを操作し、コマンドを実行し、エラーから回復しなければならない。
同社は、Claude Codeフレームワークを通じてTerminal-Bench 4.0をテストしたとしている。この点は重要である。エージェントフレームワークは、基盤モデルが利用できるツール、指示、対話ループを形作るためだ。
DeepSWE v1.1では、DeepSeekは74.2から77.0への上昇を報告した。この評価にはMini-SWE-V2フレームワークを使用した。ソフトウェアエンジニアリングのベンチマークは、リポジトリ設定、ツール権限、許可された試行回数に大きく左右され得る。
ProgramBenchは20.3から29.1へと、より大きな数値上の伸びを示した。NL2Repo-Benchは65.4から68.2に上昇している。後者は、自然言語の依頼をソフトウェアリポジトリ全体にわたる変更へと変換することに焦点を当てる。
この傾向は、DeepSeekが短い回答のプログラミングだけでなく、継続的なコーディングワークフローを対象にしたことを示唆する。この違いは、イシューキュー、コードレビュー、移行、デバッグセッションに対してエージェントを試験する企業にとって重要だ。
エージェントベンチマークでも同様の方向性が見られる。DeepSeekはAutomation-Bench v1.0.6で60.5を報告しており、前チェックポイントの54.8を上回った。Agents’ Last Examは31.8から35.4に上昇した。
同社の表では、Apex Bench v1.1は64.6から72.1へ移行している。DeepSeekはこれらの結果を、更新版が計画、ツール利用、実行を伴うより長い一連の作業を処理できる証拠として示している。
視覚エージェントのスコアも上昇した。ツール付きChartographyは78.9から83.0へ、BabyVisionは89.6から92.5へ上がった。ツール付きZeroBench-mainは49.0から51.0に増加した。
DeepSeekによると、ZeroBench-mainではPass@5を使用した。この指標では最大5回の試行が許可され、少なくとも1回成功したかを記録する。初回試行の成功率と直接同等のものとして解釈すべきではない。
同社はツールなしのHumanity’s Last Examで42.6も報告している。純粋なテキストのサブセットでは44.0としているが、このサブセットの結果を、より広範な評価におけるスコアの代替とみなすべきではない。
ベンチマークの改善は、表に掲載されたすべての旧モデル比較で一貫している。掲載結果の中に、1017チェックポイントが9月版を下回ったものはない。この一貫性は、選定した評価の範囲においてアップデートが広範に改善されたというDeepSeekの主張を支える。
ただし、この表では複数の比較におけるサンプル数が開示されていない。また、ハードウェア、トークン予算、時間制限、再試行予算、推論努力設定も省かれている。これらの変数はエージェント評価に大きな影響を与え得る。
より多くのツール呼び出しや推論トークンを許可されたモデルは、より厳しい設定では失敗するタスクを完了できることがある。一方で、より良いスコアを得る代わりに、より多くの時間とリソースを消費する可能性もある。
DeepSeekは新しいチェックポイントが実行時間と出力長の両方を削減するとしている。この主張は重要だ。出力が短ければ、アプリケーションが処理しなければならない生成テキスト量を減らせる。完了の高速化は、ユーザー体験やエージェントのスループットも改善し得る。
ただし、リリース資料では、いずれの削減についても普遍的な割合は示されていない。実行時間はワークロード、インフラ、コンテキスト長、エージェントフレームワークによって異なる。出力長もプロンプトとタスクの複雑さに応じて変化する。
したがって、慎重な解釈は限定的なものになる。DeepSeekは、評価したハーネスにおいて、より高いスコア、より速い完了、より短い回答を報告している。正確な本番環境での改善幅は、依然としてワークロードに依存する。
短い出力こそが競争圧力の本質
DeepSeekは、有用なAI性能を、単なる知能スコアではなく完了タスク当たりで測定すべきだと主張している。
DeepSeek の報告では、Automation-Bench v1.0.6 は 54.8 から 60.5、Agents’ Last Exam は 31.8 から 35.4、Apex Bench v1.1 は 64.6 から 72.1 に上昇しています。Flash-1017 はこの 3 項目すべてで表中の Opus 5 を上回りますが、それぞれ異なるタスク集合を測っています。これらの結果はエージェント業務で追加評価する根拠になりますが、制約のない環境での確実な実行を証明するものではありません。運用者は自分たちの業務で、正常完了率、再試行の総数、ツールのエラー、確認時間、トークン費用の合計を測る必要があります。DeepSeek はこの版で Harness 0.2.1-rc.1 以降を推奨しています。

2026 年 10 月 17 日版について DeepSeek が測定した、異なる 3 種類のエージェント評価を図示。高いほど良好です。提供元間の正確な推論強度とトークン・時間予算、サンプル数、評価日は比較表に示されていません。3 つを合成して総合スコアにしないでください。 — 出典
モデルの購入者は、予算と時間の制約内でシステムが成功裏に完了するワークフローの数を、ますます重視している。モデルがループしたり、不必要な説明を書いたり、ツールを繰り返し呼び出したりするなら、高いベンチマークスコアの価値は下がる。
エージェントタスクでは、この問題がさらに大きくなる。コーディングアシスタントは、誤った経路を探索しながら数千トークンを生成することがある。また、ファイルを読み直したり、根本的な問題を解決しない修正を試みたりして時間を浪費する場合もある。
DeepSeekによる短い出力という主張は、この非効率性を直接の標的にしている。1017がより少ない生成トークンで同等以上の結果に到達するなら、レイテンシーと運用コストを同時に下げられる可能性がある。これは、単に文章が簡潔になる以上に重大な意味を持つ。
同社はこの変更を、性能とコストのパレート改善と呼んでいる。パレート改善とは、測定対象となる他の要素を悪化させずに、少なくとも1つの重要な次元で選択肢が改善されることを意味する。
ここでDeepSeekは、より高いベンチマーク性能に加え、実行時間の短縮と出力の削減を主張している。開発者が、能力と速度または効率性を以前ほど大きく引き換えにする必要がなくなる、という論旨だ。
現時点で利用できる証拠は、DeepSeekの評価表の範囲内で性能面を裏付けている。しかし、同社がタスクレベルの詳細なリソース測定値を公表していないため、成功当たりのコストという側面を完全に確立するものではない。
現行のモデル仕様によると、Flash-1017は既存のサービス構成を維持している。thinkingモードとnon-thinkingモードの両方に加え、ツール呼び出し、JSON出力、Vision、互換性のあるAPI形式が引き続き利用できる。
エンドポイントが変わらないことは、導入時の摩擦も減らす。チームは統合を書き直すことなく、新しい挙動をテストできる。この利点は、すでにDeepSeek Flashを使用している開発者を中心に採用を加速させ得る。
一方で、運用上のリスクも生む。安定したトーン、出力構造、拒否挙動を前提に構築されたアプリケーションは、目立たないチェックポイント変更に悪影響を受ける可能性がある。恒久的な名前の背後でホスト型モデルが変わるたびに、回帰テストが不可欠となる。
コーディングプラットフォームでは、直近の圧力はプレミアムな信頼性を売りにするモデルへ向かう。DeepSeekの表では、1017をK3、GLM-5.3、GPT-5.6 Sol、Opus 5と表記されたモデルと比較している。
これらのラベルは、DeepSeekが提供する表記どおりに報告しなければならない。この表は各社の現行モデルをすべて評価しているわけではない。Opus 5という表記を、別のAnthropicリリースに勝手に置き換えてはならない。
DeepSeekのチェックポイントは、DeepSWE v1.1、Automation-Bench、Agents’ Last Exam、Apex Benchで表内のOpus 5参照モデルを上回った。一方、Terminal-Bench、ProgramBench、NL2Repo-Bench、および掲載されている3つのビジュアルテストでは、その参照モデルを下回っている。
このような入り交じった結果は、単純な勝者宣言よりも多くを示している。DeepSeekは複数のエージェント評価で特に競争力があるように見えるが、ベンダー自身の表でも、すべてのカテゴリーで首位に立っているわけではない。
競合他社への圧力は、その組み合わせから生じる。DeepSeekは、利用しやすい重み、安定したAPI経路、大きなコンテキストウィンドウ、マルチモーダル入力、向上するエージェントスコアを組み合わせている。それぞれの属性が、試験導入を検討するチームの数を増やす。
9月のリリースでは、すでに効率性がアーキテクチャ上の目標として示されていた。DeepSeekによれば、V4.1 Flashはキー・バリューキャッシュに必要な高帯域幅メモリを4分の1に、ソリッドステートストレージを8分の1に抑えた。
キー・バリューキャッシュは、推論中に生成された情報を保存し、新しいトークンごとにモデルがすべてを再計算しなくて済むようにする。キャッシュを小さくすれば、長いプロンプトや繰り返されるエージェントのやり取りに伴うメモリ負荷を軽減できる。
こうしたアーキテクチャ上の主張は、V4.1 Flashというモデルファミリーに属するものだ。10月の要点は、既存の設計をポストトレーニングによってより有効にしたとDeepSeekが説明している点にある。1017で新たなキャッシュ再設計が発表されたわけではない。
この区別は、購入者にとって重要である。アーキテクチャは、なぜモデルを経済的に提供できる可能性があるのかを説明する。一方、チェックポイントの挙動は、購入者の実際のタスクを正確かつ効率的に完了できるかを決定する。
したがって、この更新を評価するチームは、生成トークン数だけでなく、完了した作業を測定すべきだ。代表的なワークフロー全体で、成功した変更、受け入れられた出力、人間による修正、経過時間、再試行を追跡する必要がある。
この評価は、より広範なAIワークフローに組み込める。重要なのは、後の比較に備え、プロンプト、ソース資料、出力、レビュー判断を保存することだ。
ベンチマーク表が示していないこと
DeepSeekの数値は同社のエンジニアリングの方向性を示す有意義な証拠だが、本番環境での信頼性を独立して確認するものではない。
視覚ツールの評価は改善していますが、全項目での首位ではありません。Chartography は 78.9 から 83.0、BabyVision は 89.6 から 92.5、ZeroBench-main は 49.0 から 51.0 に上昇しました。原資料の Opus 5 はそれぞれ 84.0、94.1、52.0 で、引き続き上回っています。これらはツールを利用する評価なので、画像だけを入力した場合の素の正解率とは解釈できません。ZeroBench-main は複数回の試行を認める Pass@5 を使用しており、初回実行の信頼性を示す数値ではありません。重大な結果を伴う操作では、視覚エージェントにも適切なツール権限、エラーからの回復、人による確認が必要です。

2026 年 10 月 17 日版について DeepSeek が実施した、ツール利用ありの視覚評価。高いほど良好です。ZeroBench-main は Pass@5。その他の再試行上限、サンプル数、不確実性の区間、統一予算、評価日は表に示されていません。 — 出典
主な制約は情報源の独立性にある。DeepSeekが比較を公表し、モデル、ベンチマーク、ハーネス、構成を選定した。本記事で確認した一次資料には、1017チェックポイントそのものの独立した再現評価の結果は示されていない。
これはスコアが誤りだという意味ではない。ベンダーによる評価は、モデルリリース後に利用可能となる最初の証拠であることが多い。企業がどこに投資したか、どのワークロードの改善を見込んでいるかを示し得る。
ただし、あらゆる比較を確定させることはできない。エージェントベンチマークには、標準的な質問応答テストより多くの可変要素がある。フレームワークのシステムプロンプト、ツール、タイムアウト、サンドボックス、再試行ロジックは、最終スコアを変え得る。
DeepSeekはいくつかの条件を開示している。Terminal-BenchではClaude Code、DeepSWEではMini-SWE-V2、ZeroBench-mainではPass@5を使用した。同社はDeepSeek Harnessのバージョン0.2.1-rc.1以降も推奨している。
この推奨は、ハーネス統合がパフォーマンスの一部を成すことを示唆している。DeepSeekは、自社ハーネス、Tencent CodeBuddy、WorkBuddy、その他のプラットフォーム向けにモデルを最適化したとしている。
モデルとハーネスの改善はいずれも正当なものだ。しかし購入者は、改善が環境をまたいで再現されるかを知る必要がある。あるエージェントループに合わせて調整されたチェックポイントは、別企業のオーケストレーションレイヤー内では異なる性能を示す可能性がある。
推論設定が開示されていないことも不確実性を加える。DeepSeekは複数の思考努力レベルをサポートしており、これはリクエストに割り当てられる内部計算量に影響する。より高い設定は結果を改善し得る一方、レイテンシーやトークン使用量を増加させる可能性がある。
速度に関する主張では、ハードウェアの詳細も重要だ。ホステッドサービス上での実行時間は、セルフホスト推論へ直接換算できない。ネットワークオーバーヘッド、バッチ処理、量子化、アクセラレータの選択が、観測されるレイテンシーを大きく左右し得る。
オープンな重みにより、こうした疑問は検証可能になるが、セルフホスティングが自動的に容易になるわけではない。5520億パラメータのバックボーンは、トークンごとにネットワークの一部しか活性化しない場合でも、厳しいストレージおよびメモリ要件を生む。
量子化は、より低い数値精度で重みを保存することでメモリ使用量を削減する。デプロイをより現実的にできる一方、結果は公式のチェックポイント構成と異なる場合がある。チームは変換後に精度を検証すべきだ。
セキュリティも、本番導入における別の懸念となる。コーディングエージェントはしばしばリポジトリを読み取り、コマンドを実行し、パッケージをインストールし、ファイルを変更する。より高いベンチマークスコアは、モデルに広範な権限を安全に与えられることを証明しない。
組織はエージェント作業を隔離し、認証情報を制限し、ツール呼び出しを記録し、機密性の高い変更にはレビューを義務付けるべきだ。こうした制御は、ベンチマーク上の位置にかかわらず、すべてのコーディングモデルに適用される。
同じ注意は、100万トークンのコンテキストウィンドウにも当てはまる。大規模なコンテキストをサポートすることは、あらゆる位置からの信頼できる情報取得を保証しない。長いプロンプトは、注意散漫、相反する指示、不必要な処理を招く可能性がある。
DeepSeekのネイティブなビジョンサポートも、10月の更新以前から存在していた。ビジュアルエージェントのスコア上昇はその機能の活用改善を示唆するが、チャート、インターフェース、文書、自然画像にわたる同等の信頼性を証明するものではない。
歴史的な文脈も、慎重な主張の必要性を強める。DeepSeekのV4ローンチが注目を集めたのは、大規模コンテキストのサポートと効率重視のアーキテクチャを組み合わせたためだ。以前の報道で引用された独立アナリストは、このファミリーを米国の主要モデルと競合するものと評価した。
しかし、こうした幅広い競争力が、新しいチェックポイントの正確な改善を自動的に裏付けるわけではない。1017の重みには、特に実際の導入環境に近いワークロードで、独自のテストが必要だ。
実用的な評価では、両チェックポイントを同一のプロンプトとツールで比較すべきである。温度、努力設定、タイムアウト、再試行回数、リポジトリの状態を保持する必要がある。
レビュー担当者は、冗長性による優位性を取り除いたうえで、出力品質も評価すべきだ。短い回答は完全性を維持していれば有用である。テスト、注意事項、移行手順、失敗の説明を省くなら、それは後退となる。
ナレッジワークでも、簡潔さは同様のトレードオフを生む。短い要約は読了時間を減らすが、圧縮された回答は不確実性を隠したり、少数派の証拠を捨てたりすることがある。重要な判断には引き続き人間のレビューが必要だ。
したがって、適切な懐疑は具体的なものであるべきだ。DeepSeekは改善を示す信頼できる一次資料の証拠を公表した。しかし、独立した本番環境全体での普遍的な速度向上、総タスクコストの低下、優れた信頼性を、まだ確立したわけではない。
Flash-1017が市場を変えるかを示す3つのシグナル
独立した再現、ハーネス横断の性能、持続的な開発者導入が、1017が強力なベンダーベンチマークのリリース以上の存在になるかを決める。
10 月 17 日の更新では deepseek-flash API エイリアスが提供するチェックポイントが置き換わり、価格は据え置かれました。10 月 19 日に確認した Flash の 100 万トークン当たりのオフピーク価格は、キャッシュ入力が 0.003 ドル、非キャッシュ入力が 0.15 ドル、出力が 0.60 ドルです。ピーク価格は順に 0.006、0.30、1.20 ドルです。仮に 100 万の非キャッシュ入力、400 万のキャッシュ入力、100,000 の出力トークンを使うタスクでは、モデルのトークン料金はオフピークで 0.222 ドル、ピークで 0.444 ドルとなります。この計算には検索・取得料金、インフラ、再試行、人による確認は含みません。出力が短くなれば出力料金を下げられますが、DeepSeek の速度と費用に関する主張は、どの業務でも一定の節約が得られることを意味しません。
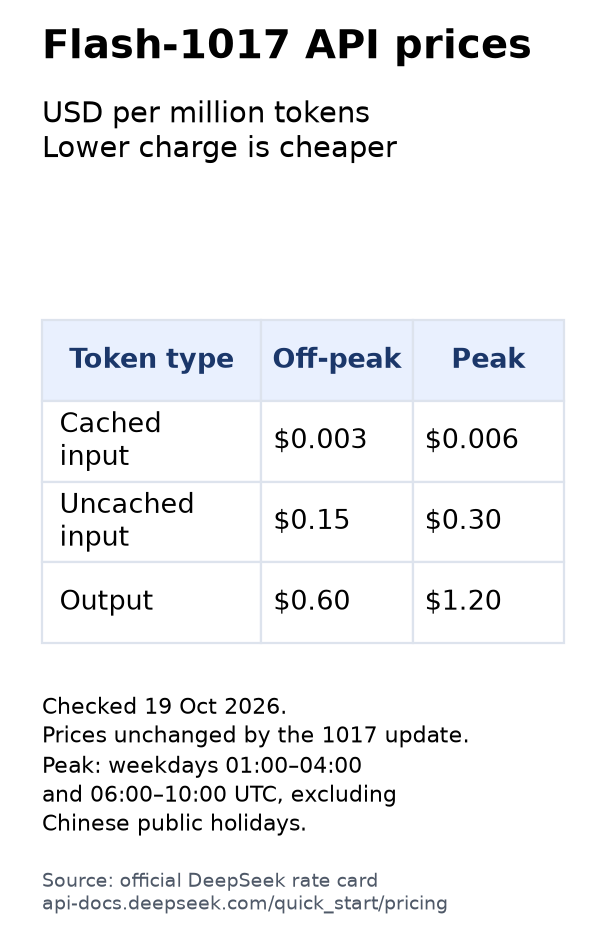
2026 年 10 月 19 日に確認した公式 Flash-1017 料金表。単位は 100 万トークン当たりの米ドルで、低いほど安価です。ピーク時間帯は平日の UTC 01:00–04:00 と 06:00–10:00 で、中国の法定祝日を除きます。モデルのトークン価格と検索・取得などの運用費用は別です。 — 出典
最初のシグナルは、正確に1017チェックポイントを対象とした独立評価である。研究者は、9月のモデルやバージョンが不確かなホステッドエイリアスではなく、公開された重みをテストする必要がある。
こうしたテストでは、プロンプト、ハーネスのバージョン、努力設定、ハードウェア、時間制限、再試行ポリシーを公開すべきだ。結果には、精度、経過時間、出力トークン、タスク失敗時の挙動を含める必要がある。
DeepSeekが報告した方向性と一致すれば、同社の主張は強まる。大幅な後退や構成への強い依存が見られれば、それは弱まる。結果が混在すれば、1017は一部のエージェントループに他より大きな恩恵をもたらすことが示唆される。
2つ目のシグナルは、複数のハーネスにわたる性能である。DeepSeekは特定のプラットフォーム向けに最適化したため、移植性が中心的な問いとなる。このモデルは、代替のコーディングエージェントやエンタープライズのオーケストレーションシステムでも改善を維持すべきだ。
ハーネス横断テストは、モデル改善と統合改善を切り分けられる。どちらにも価値はあるが、購入に関する異なる問いに答える。
DeepSeek Harnessを採用する企業は、統合システムから恩恵を受けられる。既存の社内エージェントを維持する企業には、チェックポイント単体でワークフローが改善するという証拠が必要だ。
サードパーティーテストが、ツールアクセスを変更せずにTerminal-Benchの向上を再現するかに注目すべきだ。また、別のフレームワークが異なるシステムプロンプトを使う場合にも、短い出力が完全性を保つかを確認すべきである。
一貫した改善は、基盤となるチェックポイントが改善されたというDeepSeekの主張を支える。改善が優先ハーネスに限定されるなら、統合の選択が意思決定に占める比重は大きくなる。
3つ目のシグナルは、初期リリースサイクル後も続く開発者導入である。ダウンロード数、統合、再現可能なテスト、本番導入事例は、リリース週の注目度より重要だ。
MITライセンスの重みは、実験における法的摩擦を低減する。しかし、このモデルの規模は、本格的なセルフホスティングに必要なインフラのハードルを引き上げる。多くのチームは引き続き、ホステッドアクセスや専門の推論プロバイダーを選ぶだろう。
したがって、導入は両方の経路で測定すべきである。ホステッド利用は、API体験が魅力的かを示す。セルフホスト導入は、オープンアクセスが特殊な要件を持つ組織に実用的な代替手段を生むかを示す。
試用より継続利用の方が重要だ。API識別子の切り替えは容易なため、開発者は頻繁に新モデルを試す。新たなレビュー負担を生まず、受け入れられる作業を改善する場合にのみ、そのモデルを使い続ける。
短期的に見込まれる結果は、即時の市場再編ではなく、より広範なテストだ。DeepSeekはコーディングエージェントのチームに、評価を再実行する具体的な理由を与えた。最も大きいと報告された改善は、開発者がすでに信頼性をもって自動化することに苦労しているタスクと一致している。
競合他社には、より優れたモデル、より強力なエージェントフレームワーク、低レイテンシー、安全な実行、より予測可能な挙動を通じて対応する余地がある。DeepSeek自身の表でも、1017チェックポイントがすべての比較で首位ではないことが示されている。
このリリースは、より速い競争サイクルも示している。9月に主要なアーキテクチャが登場し、その5週間後には挙動に焦点を当てたチェックポイントが続いた。安定したAPIルーティングにより、DeepSeekはその改善を直ちに配布できる。
更新が測定可能な改善をもたらすとき、このサイクルはユーザーに利益をもたらす。挙動の変化がエンタープライズの評価サイクルより速く進む場合、ガバナンスは複雑になる。チームには、両方の影響を管理するためのバージョン記録と定期的な回帰テストスイートが必要だ。
開発者にとって、判断は明快である。DeepSeek-V4.1-Flash-1017を、ユーザーが実際に行うタスクと照らしてテストすべきだ。受け入れられた成果、再試行、レイテンシー、出力長、人間による修正を測定する。
エンタープライズの購入者は、プロバイダーにチェックポイント識別子と変更通知を求めるべきだ。また、ベンチマーク上の首位を購買判断として扱う前に、再現可能な評価条件を要求すべきである。
ナレッジワーカーは、短い回答が証拠とニュアンスを保っているかに注意を払うべきだ。後から誰かが欠けた推論を再構築しなければならないなら、より速い回答の価値はほとんどない。
DeepSeek V4.1 Flashの更新は、すでに比較対象の顔ぶれを変えた。同じアクセス経路とモデルファミリーを維持しながら、前のチェックポイントのコーディングおよびエージェントスコアを引き上げている。
次に何が起こるかは、DeepSeekの研究環境外で得られる証拠にかかっている。統制された比較を実施し、評価記録を完全に保存し、独立テストが精度、速度、簡潔さの組み合わせという主張を再現するかを注視しよう。


