Nano Banana 2.1:Googleの画像ベンチマークが示すこと


Googleは2026年10月6日にNano Banana 2.1を公開した。10月14日付の本分析では、これを本日発表された新製品ではなく、そのリリースの続報として扱う。
公開された結果は、Nano Banana 2.1が複数の画像生成・編集タスクでNano Banana 2を改善しているという、もっともらしい根拠を提示している。報告された優位性が特に大きいのは、インフォグラフィック設計、複数キャラクターの一貫性、マスクベースの編集、複数参照画像を用いる作業だ。Thinkingを有効にすると概して最高スコアになるが、その価値はタスクによって異なる。
これらの知見には慎重な線引きが必要だ。大半のスコアは正しい画像の割合ではなく、選好に基づくEloレーティングである。GoogleはElo結果の誤差範囲を提示しているが、その信頼水準は定義していない。モデルカードの表では、サンプル数、ベンチマークプロンプト、画像解像度、再試行予算、Thinkingの詳細設定、同等計算量の条件を開示していない。事実性の結果も、人間による正確性の測定ではなく自動評価器に基づく。
したがって、これらのベンチマークはGoogleの評価条件下における相対性能について有用な証拠となる一方、本番環境での信頼性、レイテンシー、投資対効果を確立するものではない。移行を検討するチームは、制御された入力、失敗基準、リクエスト全体のコストを用いた、ワークロード固有のテストを依然として必要とする。
Googleが10月6日に実際に公開したもの
Nano Banana 2.1は、Googleが更新したFlashクラスの画像生成・対話型編集モデルだ。安定版Gemini APIのモデルコードはgemini-nano-banana-2.1である。Googleはこれを、Nano Banana 2とも呼ばれるGemini 3.1 Flash Imageの更新版であり、一般にNano Banana Proと呼ばれるGemini 3 Pro Imageのより効率的な対となるモデルだと説明している。Gemini APIの変更履歴には、2026年10月6日の一般提供開始が記録されている。
Nano Banana 2.1のモデルカードによると、このモデルはGemini 3.6 Flashを基盤とし、テキストと画像を受け取り、画像とテキストを返す。Googleは、制御可能な画像作成、編集、文字量の多いグラフィック、ローカライズされたレンダリング、反復的なワークフロー向けに位置付けている。評価では、生成・編集に対する並列比較型の人間の選好判断と、片側の自動事実性評価を組み合わせている。
カードは具体的な制約も示している。小さい文字や長い文章はぼやけたり崩れたりする場合がある。アイデンティティが変化することがあり、マスク編集では描き込みが残ったり指示に部分的にしか従わなかったりする。ポーズが予期せず維持される場合があり、左右などの空間関係を取り違えることもある。世界知識、3D推論、事実性もなお不完全だ。ときどき遅延やタイムアウトが発生することも認められている。これらは脚注ではなく運用上のリスクであり、導入前にそれぞれ受け入れテストとフォールバック方針を必要とする。
GoogleのAPIモデル文書には、実装上の詳細が加わる。出力はデフォルトで1Kで、最大4Kまで指定できる。Thinkingにはminimal、デフォルトのmedium、highがある。このモデルは検索グラウンディングをサポートするが、関数呼び出し、コード実行、構造化出力には対応しない。
モデルカードには、コンテキストは最大 100 万トークン、テキスト出力は最大 64K と記載されています。一方、デプロイ済みの Gemini API ページには、入力トークン 131,072、出力トークン 32,768 と記載されています。公開文書では、これらの異なる制限の関係は説明されていません。デプロイヤーは、より大きなモデルカード上の数値がその API で利用可能だと仮定するのではなく、呼び出す特定のエンドポイントに文書化された制限に従うべきです。
生成Eloが示すのは優位性であり、正確性の割合ではない
Googleは、人間評価によるテキストから画像への比較を2件報告している。総合選好とインフォグラフィック設計である。どちらでも、Thinkingを有効にしたNano Banana 2.1が1位で、ThinkingなしのNano Banana 2.1、Nano Banana 2 Thinking、Nano Banana Proが続く。
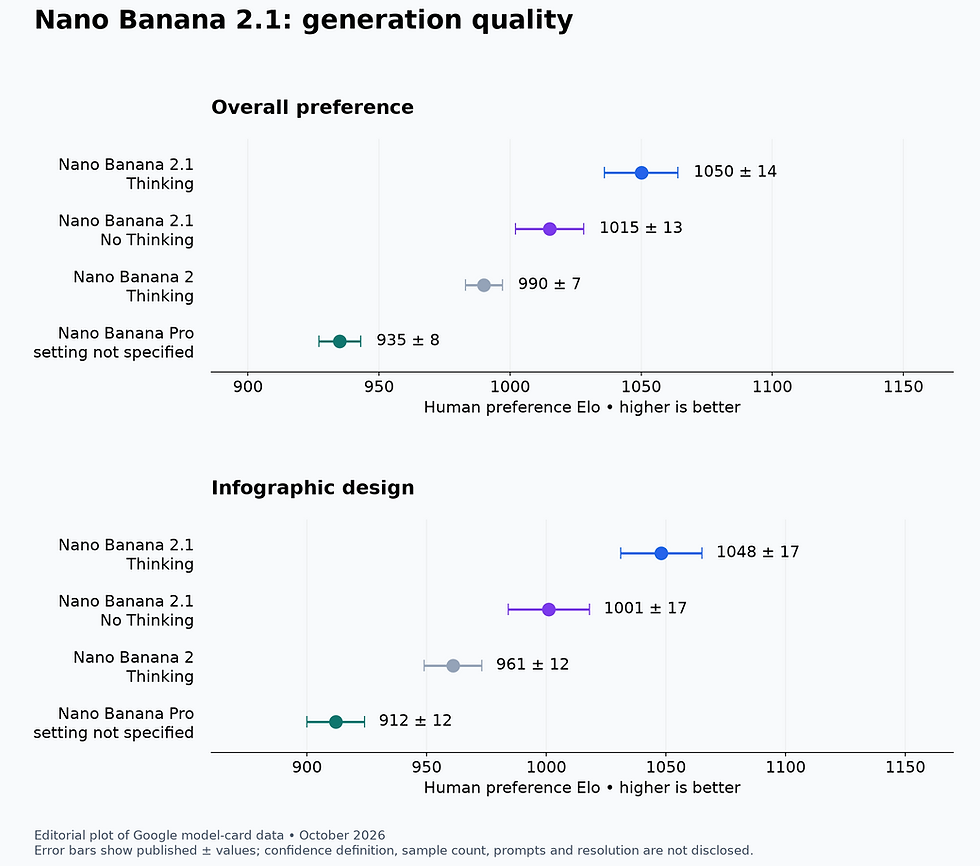
Google DeepMindのNano Banana 2.1モデルカードで2026年10月に公開された数値データに基づく編集部作成のプロット。Eloが高いほど、Googleの比較における相対的な人間の選好が強いことを示す。エラーバーは公開された±範囲を示すが、信頼性の定義は明示されていない。これはGoogle作成のオリジナル画像ではなく、Eloは正確性の割合ではない。
総合選好では、Nano Banana 2.1 Thinkingが1050 ±14、Thinkingなしが1015 ±13、Nano Banana 2 Thinkingが990 ±7、Proが935 ±8である。インフォグラフィック設計では、対応する結果は1048 ±17、1001 ±17、961 ±12、912 ±12となった。
順位は一貫しており、いくつかの差は表示された範囲を上回る。特にインフォグラフィック設計では、公開された区間を考慮しても、Nano Banana 2.1の両モードはNano Banana 2を上回っている。これは、この評価内での選好上の優位性を示す意味のある証拠だ。ただし、2.1がすべてのプロンプトで勝つこと、正しいインフォグラフィックを生成すること、本番環境で必要な再試行が少ないことの証明ではない。
ここではThinkingが有益に見える。Thinkingなしに対する総合選好での35ポイントの差は、表示区間が重ならない。1036–1064に対し、1002–1028である。インフォグラフィック設計の区間は1031で接しているため、チャートは優位性を支持するが、正確で普遍的な効果量までは支持しない。Googleもベンチマーク構成を単に「Thinking」と表記している。それがminimal、medium、high、適応型ポリシー、または別の内部設定を使ったかは明らかにしていない。
この欠落により、コストとレイテンシーに関する結論は限定される。各利用可能な設定が特定のワークフローにどう影響するかを測定せずに、Thinkingの高スコアを「常にhigh Thinkingを有効にすべき」と読み替えることはできない。ベンチマーク表にはレイテンシー測定値がなく、本分析がそれを捏造すべきでもない。
実務上のシグナルはより限定的である。利用者が構図、視覚的な完成度、インフォグラフィックのレイアウトを評価するチームは、Nano Banana 2.1 Thinkingを有力な候補として含めるべきだ。低リスクの装飾アセットを生成するチームにはThinkingなしで十分な場合もあるが、その判断は自社のプロンプトと受け入れ閾値を用いる制御テストに委ねられる。
一貫性は向上したが、単一キャラクターの結果は僅差
繰り返し登場するキャラクター、キャンペーンのバリエーション、ストーリーボード、製品解説、複数ターンの編集では、一貫性が単純な見栄えより重要となることが多い。Googleは単一キャラクターと複数キャラクターの一貫性を分けており、この2つの結果は異なる状況を示す。

単一キャラクターおよび複数キャラクターの一貫性に関するGoogle DeepMindの2026年10月のモデルカードデータを基にした編集部作成のプロット。Eloが高いほど相対的な人間の選好が高いことを意味する。公開された±範囲は示されているが、信頼性の定義は明記されていない。単一キャラクターの一貫性におけるNano Banana 2.1 ThinkingとThinkingなしの区間がほぼ重なる点は重要である。これはGoogle作成のオリジナル画像ではない。
単一キャラクターの一貫性では、Nano Banana 2.1 Thinkingは1028 ±14、Thinkingなしは1021 ±14に達している。表示区間は1014から1035まで大きく重なる。したがって、7ポイント差を確立された実用上の優位性として示すことは正当化できない。2.1の両構成は、Nano Banana 2 Thinkingの981 ±10およびProの991 ±9を上回るが、ベンチマークは失敗が顔、衣服、体型、アクセサリー、スタイルの変化のどれに関わるものかを示していない。
複数キャラクターの結果は、より明確に差別化されている。Thinkingは1106 ±14、Thinkingなしは1068 ±14、Proは1011 ±10、Nano Banana 2 Thinkingは978 ±10である。2.1 ThinkingとThinkingなしの区間は重ならない。これは、複数のアイデンティティとその関係を追跡する必要があるシーンでは、追加の推論がより有用である可能性を示唆する。
それでも、「最大4キャラクターをサポートする」ことは「4つのアイデンティティを確実に維持する」ことと同義ではない。API文書によれば、複数画像の融合では、最大4キャラクターと10個のオブジェクトを含む、最大14枚の参照画像を受け付ける。これらは入力上限であって、忠実性の保証ではない。参照画像の見た目が似通っている、矛盾している、トリミングされている、低解像度である、照明にばらつきがある場合に、性能がどう変化するかは明らかにしない。
本番評価では、各被写体を別々に採点すべきだ。有用な失敗ラベルには、顔の変化、衣服の移植、キャラクター間の属性漏れ、被写体の欠落、意図しない重複、年齢の変化、相対的な身長の不整合が含まれる。画像の残りが魅力的に見える場合、単一の総合選好投票では深刻なアイデンティティ欠陥が隠れる可能性がある。
1キャラクターのワークフローでは、チャートはThinkingがすべてのリクエストに必要だという証拠をほとんど示していない。繰り返し登場する人物が複数いるシーンでは、報告されたより大きな優位性により有望ではあるが、それでもコスト、レイテンシー、アイデンティティ失敗率の測定が必要だ。
編集結果は2.1を支持するが、タスクごとにリスクが異なる
編集ベンチマークは特に重要である。もっともらしく見える出力でも、保護領域を変更したり、製品の詳細を失ったり、参照画像を不正確に融合したりすれば、使用できない可能性がある。Googleは、一般編集、一貫性、マスクまたはインクベースの編集、製品一貫性、スタイライズ、複数参照編集についてEloスコアを報告している。

Google DeepMindのNano Banana 2.1モデルカードで2026年10月に公開された検証済み数値結果に基づく編集部作成のプロット。Eloが高いほど、マスク/インク、製品一貫性、複数参照編集に対する相対的な人間の選好が強いことを示す。公開された±範囲を表示しているが、信頼性の定義は明記されていない。これはGoogle作成のオリジナル画像ではなく、厳密な編集指示への準拠を測定するものでもない。
マスクまたはインクベースの編集は、実証されたThinkingの優位性がない一方で、2.1全体の優位性が最も明確に表れている例だ。Thinkingは1049 ±15、Thinkingなしは1042 ±16で、区間は大きく重なる。両者とも、Nano Banana 2 Thinkingの965 ±12とProの927 ±12を上回る。マスク編集がワークロードの中心である場合、Thinkingなしを本質的に劣るモードとして扱うのではなく、テストで同等に注目する価値があるかもしれない。
ただし、Google自身が示す制約はこの結果を限定する。このモデルは、マスク編集の指示に部分的にしか従わなかったり、落書きやインクの跡を残したり、元の被写体のポーズを維持したりする可能性がある。選好Eloでは、許可領域外のピクセルが変わらず維持されたことを確立できない。カタログや規制対象のワークフローでは、別個の保持指標が不可欠である。
製品一貫性では、2.1 Thinkingなしと旧モデルの比較は決定的ではない。スコアはThinkingありで1024 ±18、Thinkingなしで981 ±18、Nano Banana 2 Thinkingで955 ±22、Proで965 ±14である。Thinkingなしの区間は、両方の旧モデルの区間と重なる。したがって公開チャートは、この評価においてThinkingが最も強い構成であることを支持するが、2.1のすべての構成が製品の忠実性を明確に改善すると主張する根拠にはならない。
マルチリファレンス編集でも、2.1の優位性はより明確に示されています。Thinkingありでは1066 ±22、なしでは1041 ±20であるのに対し、Nano Banana 2 Thinkingは988 ±13、Proは989 ±12です。ただし、2.1の2つの区間は重なっているため、中心スコア間の25ポイント差を過大に解釈すべきではありません。
これらのタスクには、それぞれ異なる受け入れ基準も必要です。クリエイティブな合成画像では軽微なジオメトリの変化が許容される場合がある一方、EC向け画像では、ロゴ、ポート、ボタン、素材、梱包数量が変わるだけで不合格となり得ます。したがって移行判断は、「編集がより優れている」という総合的な結論ではなく、編集クラスごとに行うべきです。
事実性は有望だが、依然として最も弱い主張
Google は、インフォグラフィックの事実性スコアについて、Nano Banana 2.1 Thinking は 0.521、Thinking なしは 0.328、Nano Banana Pro は 0.265、Nano Banana 2 Thinking は 0.179 と報告しています。

Google DeepMindのNano Banana 2.1モデルカードに掲載された2026年10月のAutoRater事実性データをもとにした編集部作成グラフ。高いほど良好ですが、この片側の自動評価スコアは人間による正確性の割合ではありません。Googleはここで不確実性の範囲を公開していません。これはGoogleのオリジナル画像ではありません。
この結果から支持される結論は限定的です。Googleの自動評価において、ThinkingはNano Banana 2.1の事実性スコアを大幅に向上させ、その結果のスコアは掲載された比較対象を上回っています。しかし、これはインフォグラフィックの52.1%が事実として正しいことを意味しません。モデルカードはこのスコアをパーセンテージとして定義しておらず、不確実性やプロンプト数を公開せず、エラー率を算出するのに十分な詳細も示していません。
この区別は重要です。事実を扱うグラフィックには、複数の失敗要因があります。グラフには正しい文章が含まれていても、誤った値をプロットしている可能性があります。実在する情報源を引用していても、日付が一致していない場合があります。地図では地域を取り違え、タイムラインでは出来事の順序を逆転させ、ラベルを誤ったオブジェクトに割り当てることもあります。自動スコアリングはこうしたエラーの一部を捉えられる可能性がありますが、その網羅性は表から十分に明らかでないため、リリースゲートとして扱うべきではありません。
検索によるグラウンディングは新しい情報を提供できますが、取得した情報が視覚表現に忠実に転記される保証はありません。モデルカードでは、Gemini 3.6 Flashの知識カットオフを2026年3月としており、一部のドメインでは2025年1月までに制限される可能性がある一方、より新しい情報を受け取るものもあると説明しています。時間に敏感なグラフィックでは、ソース資料を明示的に提供または取得したうえで、レンダリングされた画像と照合する必要があります。
堅実なワークフローでは、ソースの真実性と表現を分離します。値、単位、日付、ラベル、引用を含む承認済みファクトシートを維持し、そのブリーフからビジュアルを生成してから、レンダリングされたすべての主張を承認済みの事実と照合します。ここで、ビジュアルコンテンツ向けに追跡可能なソース事実とブリーフを維持することは、画像が与える見かけ上の確信ではなく、根拠となる証拠に基づいたレビューを維持する助けになります。
このベンチマークは、Thinkingを明確な事実性候補として示していますが、自律的な公開システムとして示しているわけではありません。医療、金融、法律、歴史、科学、時事に関するグラフィックでは、人間または決定論的な検証が引き続き必要です。
出力はすべての解像度で安価だが、リクエスト全体はそうとは限らない
Standardの有料API料金では、GoogleはNano Banana 2.1の画像出力を100万出力画像トークンあたり30ドルとしています。Nano Banana 2は100万あたり60ドルです。この見出しだけを見ると一律50%の削減に見えますが、4Kでの異なるトークン配分と、より高い非画像料金が総額を複雑にします。

GoogleのGemini API料金をもとにした、2026年10月時点の編集部計算。画像出力のみのコストは低いほど良好です。Nano Banana 2.1は1Kと2Kで50%低く、4Kでは25%低くなります。コストには入力、テキストまたはThinking出力、グラウンディング、再試行、税金、Batch割引の可能性は含まれません。これはGoogleのオリジナル画像ではありません。
透明性のある計算式は、料金に出力画像トークンを掛けたものです。
1Kでは、1,120画像トークンのコストはNano Banana 2.1で0.0336ドル、Nano Banana 2で0.0672ドルです。2Kでは、1,680トークンのコストはそれぞれ0.0504ドルと0.1008ドルです。4Kでは、モデルごとにトークン配分が異なります。2.1では3,780 × 100万あたり30ドルで0.1134ドル、Nano Banana 2では2,520 × 100万あたり60ドルで0.1512ドルとなります。
したがって、「半額」が正確なのは、1Kおよび2Kにおける画像出力トークンについてのみです。4KではNano Banana 2.1の使用する掲載画像トークン数が多く、出力のみでの節約率は25%まで下がります。
ほかの構成要素は逆方向に動く可能性があります。Nano Banana 2.1のStandard入力料金は、テキスト、画像、動画トークン100万あたり1.50ドルであるのに対し、Nano Banana 2はテキストまたは画像トークン100万あたり0.50ドルです。テキストおよびThinking出力は、2.1では100万トークンあたり7.50ドル、Nano Banana 2では3ドルです。したがって完全な見積もりには、実際の入力トークン、テキスト出力、Thinking消費量、該当する場合のグラウンディング料金、再試行、税金、Batch割引を含める必要があります。
プロンプトの長さ、参照画像のトークン化、Thinkingの使用、解像度、再試行率を仮定せずに、「典型的なリクエスト」の総額を責任をもって算出することはできません。より安価な成功画像が、より高価なリクエストから生まれる可能性もありますし、初回合格率の向上がより高い推論料金を相殺する可能性もあります。生成画像あたりの価格だけではなく、受け入れられたアセットあたりのコストを測定してください。
移行に向けた推奨評価計画
以下は、この記事で実施したテストの説明ではなく、提案するテスト設計です。
実務から抽出した層化プロンプトセットから始めます。テキストから画像、単一キャラクター、複数キャラクター、商品編集、マスク編集、マルチリファレンス合成、テキスト量の多いレイアウト、事実を扱うグラフィックを分けます。すべてのモデルに同じタスクを与えられるよう、プロンプト、参照ファイル、アスペクト比、解像度、安全設定を保持してください。
Nano Banana 2 Thinkingと、Nano Banana 2.1の最小・中・高Thinkingを比較します。Proは実際の導入候補である場合にのみ含めてください。ベンチマークグラフはProの設定を明記していないため、その計算量や推論構成が他と同じだと仮定してはいけません。Googleがベンチマークでそうしたかどうかは開示していませんが、社内テストでは各条件に同一の再試行予算を与えてください。
出力を確認する前に、受け入れルールを定義します。
テキストレンダリングでは、必要なすべての語句を書き起こし、欠落、置換、ぼやけ、不正なテキストを記録します。
アイデンティティでは、各キャラクターを個別に評価し、属性の漏れ、重複、欠落、顔や衣装のドリフトを記録します。
商品関連の作業では、形状、ロゴ、コントロール、数量、色、素材、パッケージのテキストなど、保護対象の特徴を比較します。
マスク編集では、要求領域での成功と、マスク外における意図しない変更の両方を測定します。
空間的なプロンプトでは、左右、前景・背景、包含関係、順序、相対的な大きさをテストします。
事実を扱うグラフィックでは、固定されたソースシートに照らして、すべての数値、単位、日付、ラベル、引用、視覚エンコーディングを検証します。
運用面では、タイムアウト、エンドツーエンドのレイテンシ、再試行回数、トークン使用量、グラウンディング料金、受け入れ結果あたりのコストを記録します。
主観的な品質にはブラインドの人間レビューを用い、正確性を確保できる箇所では決定論的なチェックを使用してください。同じプロンプトを複数のモデルで実行したペア結果は、無関係な平均値よりも多くの情報をもたらすため、不確実性を報告し、ペア結果を保持してください。失敗が異なる事業上の影響を持つ場合、すべてのタスクを単一のスコアに集約してはいけません。
画像品質だけでなく、エンドポイントの挙動もテストしてください。131,072入力・32,768出力の上限を現行APIドキュメントで確認し、デフォルトの1K解像度を検証したうえで、2Kと4Kを明示的に試します。14件の参照入力は必要な場合にのみテストし、4キャラクターおよび10オブジェクトの上限が保持を保証するものではないことを忘れないでください。function calling、code execution、structured outputsはサポートされていないため、オーケストレーションと検証はモデルの外部で実施する必要があります。
最後に、本番トラフィックを切り替える前にシャドーフェーズを実行します。不合格の理由を記録し、受け入れられたアセットあたりのコストを比較します。これにより、ベンチマーク上の向上が、見栄えのよい第一印象だけでなく、修正回数の削減につながるかを明らかにできます。
移行すべき人、待つべき人
Nano Banana 2.1は、インフォグラフィック設計、複数キャラクターのシーン、マルチリファレンス合成、マスクベースの編集、より低い画像出力料金に依存するワークフローでは、より有力な候補です。Thinkingは、事実を扱うグラフィックと複雑な複数主体タスクで優先すべきです。Thinkingなしも、よりシンプルな生成・編集ではテストする価値があり、特に公開された区間がThinkingと重なる場合や、推論コストが重要な場合に有用です。
正確な小さいテキスト、長文、厳密なアイデンティティ保持、保護領域の編集、空間的精度、検証済みの事実が譲れない条件であり、組織に外部検証ステップがない場合、移行は待つべきです。既存の自動化がサポートされていないfunction calling、code execution、structured outputに依存している場合も同様です。
ドキュメント間の不一致には慎重に対応すべきです。より広いモデルアーキテクチャから能力を推測するのではなく、選択したエンドポイントの現行上限に従い、観測された挙動を測定してください。同様に、現行の非推奨化テーブルではGemini 3.1 Flash Imageが非推奨として記載されていますが、停止日は発表されていません。急いだ切り替えを強いる、検証済みの10月29日という終了期限は存在しません。
したがって、判断は具体的です。Nano Banana 2.1がタスク固有の忠実度しきい値を満たし、受け入れられた画像あたりのコストを削減し、測定済みのレイテンシおよびタイムアウト要件を満たすなら移行してください。Thinkingは、その合格率向上が追加の出力コストを正当化する場合にのみ使用します。2.1がシャドーテストに合格するまでは、Nano Banana 2または別のフォールバックを維持してください。そして、事実性、アイデンティティの感度、精密な編集が求められるアセットでは、どのモデルがベンチマークをリードしていても検証を必須としてください。


